Ming-3-TTS-0.5B:2G显存本地跑声音克隆与设计,audio.cpp整合包实测

0.5B开源TTS模型实测:零样本克隆加一句话声音设计,2G显存本地可跑。
本文介绍百灵开源的明山TTS 0.5B模型,它以仅0.5B参数同时支持零样本声音克隆(3-10秒参考音频,中文相似度0.758)和一句话自然语言声音设计,输出44.1kHz音频,覆盖7种语言及四川话、粤语等方言。官方测试显示中文零样本词错率0.8%、英文1.58%,声音设计72.29%号称超过7B模型,粤语达98%。配套audio.cpp整合包经Q8量化后约2G显存即可运行,GPU走Vulkan兼容A/N卡,无独显可用CPU模式,API兼容OpenAI TTS客户端。文章也指出其局限:复杂情绪与长文本稳定性不如大模型,8bit量化偶有底噪,声音设计对描述写法敏感。
明山TTS 0.5B(Ming-3-TTS-0.5B)是一个百灵开源、仅0.5B参数就同时支持零样本声音克隆和一句话设计音色的TTS模型。配套的audio.cpp本地API整合包让CPU和普通显卡都能跑,按Q8量化后大约2G显存即可运行,输出44.1kHz音频,覆盖7种语言加粤语等方言。下面结合UP主的实测流程,拆解它的能力边界、官方测试数据和整合包用法。
0.5B参数能做什么:克隆、设计与多语言
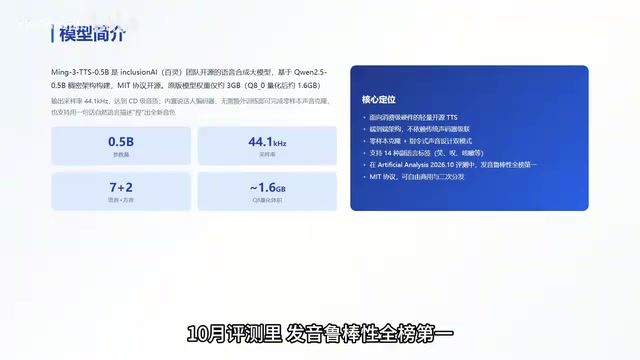
Ming-3-TTS-0.5B基于约0.5B的原版全重,Q8量化后体积明显缩小,官方给出的输出规格是44.1kHz音频,语言覆盖7种语言加四川话、粤语等方言。声音克隆只需一句话、3到10秒的参考音频即可完成,中文相似度官方数据为0.758;声音设计则用一句话自然语言描述音色,支持控制语速、情绪等维度,并附带14种复语言标签、气语言及两种方言标签。
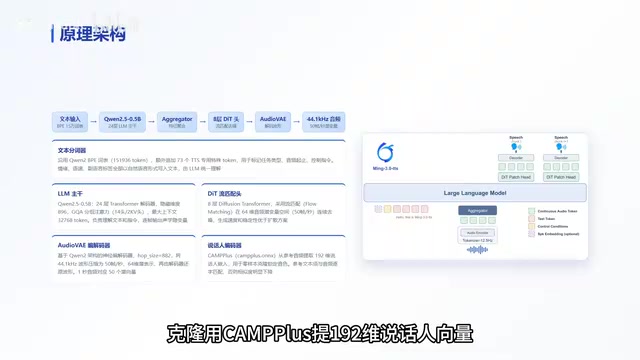
从架构上看,它走的是分词加73个控制标记、24层切文、0.5B主干用GTOA逐帧出特征,再由8层DiT在64维浅空间做流匹配去噪,最后经Odo VAE还原44.1kHz波形;克隆部分用CamPlus提取192维说话人向量。这套组合在0.5B量级里算比较完整的本地化方案。
零样本声音克隆(Zero-shot Voice Cloning) 指模型无需针对目标说话人进行额外训练,仅凭几秒到十几秒的参考音频即可复制其音色并合成新语音。其技术关键在于从参考音频中提取一个固定维度的说话人嵌入向量(speaker embedding),作为条件输入引导声学模型生成。文中提到的 CamPlus 即为此类说话人编码器,输出192维向量。与需要微调的少样本方案相比,零样本克隆部署成本极低,但相似度上限受参考音频质量、时长和信噪比影响,通常3-10秒清晰、无背景音乐的干声效果最佳。
声音设计(Voice Design) 与克隆不同,它不依赖参考音频,而是用自然语言描述目标音色(如“低沉沙哑的男声、语速偏慢”),由模型将文本描述映射到声学空间。其难点在于文本描述与声学特征之间的对齐较弱,因此描述越具体、越贴近训练数据中的常见表述,生成结果越稳定。这也解释了为何实测建议“描述越简单直白越稳”。
官方测试数据:零样本词错率与声音设计表现
官方测试里最值得关注的是零样本表现:中文词错率0.8%,英文1.58%,已接近1.5B模型的水平;声音设计72.29%,据称超过7B模型;副语言中文单标签CR2.7、PCR22.8,四川话2.27%,粤语98%。在0.5B这个参数量级下,这些指标说明它在发音稳定性和可控声音维度上做得比较全面,官方也将其描述为可控声音维度开放全重第一、发音鲁棒性全榜第一。
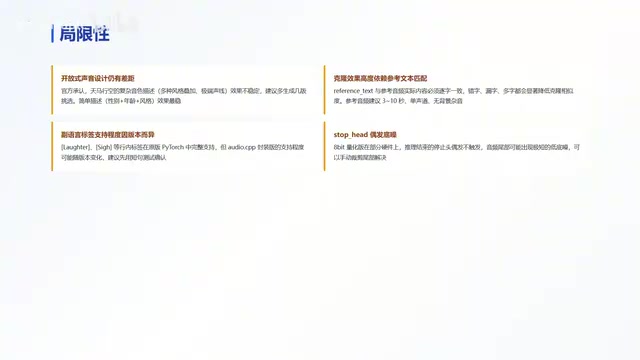
需要提醒的是,这些是官方口径的测试结果,实际效果会受参考音频质量、描述文本写法影响。UP主在实测中也提到,声音设计的描述越简单直白越稳,reference test更适合参考音频逐字匹配;副语言标签建议先用短句测试,8bit版本尾部偶尔有底噪,裁掉即可。
词错率(WER,Word Error Rate) 是语音合成可懂度的核心客观指标:将合成语音交给独立的ASR系统转写,再与原文逐词比对,计算替换、删除、插入错误占参考词总数的比例。数值越低说明发音越准确、越接近真人。零样本场景下的WER同时反映了模型对未见说话人的泛化能力,因此0.8%的中文成绩在0.5B量级中相当可观。
副语言(Paralinguistic)标签 指不改变字面内容、但承载情绪与语气信息的语音特征,如笑声、叹息、停顿、重音等。文中CR、PCR等缩写即针对这类可控维度的评测指标,用于衡量模型能否按指令稳定地产生指定语气。这类能力对角色配音、有声书等场景价值很高,但也最容易受文本描述写法影响。
整合包上手:CPU与通用显卡都能跑
整合包下载后需放在纯英文路径下。GPU模式走Vulkan,A卡N卡都可以;没有独显则用CPU模式。根据模式需求双击对应BAT文件,监听9883端口,初始化成功后用浏览器打开127.0.0.1:9283即可在网页上使用声音克隆和声音设计功能。Q8版大约两G显存就能跑,这是它相对大模型TTS最实际的优势——低门槛本地部署。
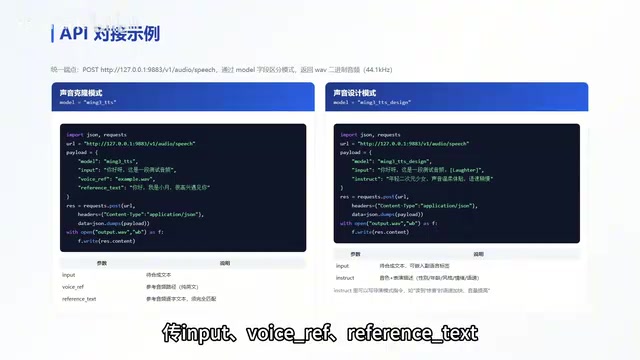
API 部分走的是 /v1/audio/speech 这类接口,POST 返回WAV。克隆模式Model填“Ming-3-TTS”,传 input、voice、reference_text;设计模式Model填“Ming-3-TTS-Design”,用 input 写描述,还可插入Loft等标签。Python调用改一下路径就能用,也能接OpenAI TTS客户端,对已有TTS工作流的迁移成本较低。
Vulkan 是Khronos组织维护的跨平台图形与计算API,相比CUDA只支持NVIDIA显卡,Vulkan可在AMD、NVIDIA、Intel核显等多种硬件上运行推理计算。整合包采用Vulkan后端,正是为了做到“A卡N卡都能跑”的硬件无关性。代价是不同厂商驱动的优化程度不一,实际速度会有差异。
量化(Quantization) 指用更低比特位宽(如8bit、4bit)表示模型权重,以牺牲少量精度换取显存和带宽的大幅下降。文中Q8即8bit量化,把原本FP16的权重压缩一半左右,使0.5B模型仅需约2G显存即可运行。量化程度越高越省资源,但可能出现底噪、细节丢失等问题,这也是文中提到8bit版尾部偶有底噪的原因。
实测听感与适用场景
UP主的实测用一句“你好呀,这是合成的语音,可以听听看效果怎么样哦”反复合成试听,整体评价是“游戏完成”,即流程跑通、效果可用。结合官方指标,它更适合这些场景:本地化、隐私敏感的声音克隆;快速做多语言配音原型;用自然语言描述音色做角色声音设计;以及在低显存设备上搭建TTS服务。
局限也明确:0.5B的容量决定了它在复杂情绪、长文本稳定性和极端音色上的上限不如大模型;8bit量化偶有底噪;声音设计对描述文本的写法比较敏感。把它当作低成本、可离线、API友好的入门级TTS基座,预期会更合理。
常见问题
Q:没有独立显卡能用吗? 可以,整合包提供CPU模式,按需双击对应的BAT即可。
Q:显存要求多少? Q8量化版大约2G显存可跑,官方原版全重更大,量化后体积显著降低。
Q:支持哪些语言? 7种语言加四川话、粤语等方言,官方测试中粤语表现尤为突出。
Q:能接入现有TTS客户端吗? API兼容OpenAI TTS客户端形式,Python侧改路径即可调用。
相关推荐

beacon.sh:为AI编程助手装上自我进化记忆
beacon.sh 是一款开源、可自我进化的 AI 编程代理记忆层,支持 Claude Code、Cursor、Codex 等 20 多个 harness,把代理会话转化为复利式知识层,解决跨工具记忆断层问题。

Xmind 2027发布:思维导图进化为AI思考伙伴
Xmind 2027 在 Product Hunt 发布,主打「AI 思考伙伴」定位。新增 Xmind Agent 支持基于本地文档与导图做研究,并通过 MCP 将导图上下文接入 ChatGPT、Claude 等 AI 工作流。本文解析其产品逻辑、差异化优势与待验证的问题。

UnleashX:像雇人一样雇佣AI员工,对话直接交付成果
UnleashX在Product Hunt上线,主打像雇人一样雇佣AI员工:选角色、连CRM和工具、设规则,端到端执行工作流,人类仅在必要时介入。本文分析其产品定位、配置逻辑与人机协作边界。