MiniMax H3本地部署教程:8G显存跑通开源视频模型
用ComfyUI本地部署MiniMax H3开源视频模型,8G显存也能跑通的完整工作流搭建指南。
本文介绍如何在ComfyUI中搭建MiniMax H3(海螺开源版)的本地视频生成工作流,面向30系入门显卡、8G显存用户。工作流以三张图像(两张人物主图+一张场景图)为输入,经过Clip编码、UNet采样、双路VAE解码,最终合成带音频的MP4视频。显存压力通过lowvram优化器、分块处理和内存节约三个节点组合解决。模型加载推荐int8量化UNet与Clip、fp32音频VAE、fp16视频VAE的搭配;采样结构与Flux工作流高度相似,有相关经验者可快速迁移。文章同时提醒读者理性看待"7倍提速""最强开源"等营销表述,实际性能以自身硬件测试为准。
开源视频生成模型正在快速拉平与商业平台的差距。这篇教程基于B站UP主分享的MiniMax H3工作流搭建流程,梳理了如何在本地环境用ComfyUI搭建一条从图像输入到视频输出的完整链路,并重点讲解显存优化的几个关键节点。对于只有8G显存、30系入门显卡的用户来说,这套方案确实提供了一条可行的本地化路径。
MiniMax H3能做什么
MiniMax H3(海螺开源版本)主打图片与视频的免费生成,无需科学上网,全程在本地运行,最低30系显卡即可跑通。相比动辄按次收费的云端平台,本地部署的最大意义在于成本可控与无使用限制。
根据UP主的演示,这套工作流支持多图输入(人物主图+场景图)驱动视频生成,同时集成了音频与视频的双路解码,可以输出带声音的成片。工作流采用纯中文界面,对国内用户较为友好。需要留意的是,视频中提到的"7倍提速""8G显存可用"等表述来自加速模型与显存优化节点的组合效果,实际速度会因硬件和参数设置而有差异。
工作流的输入结构:三图接入
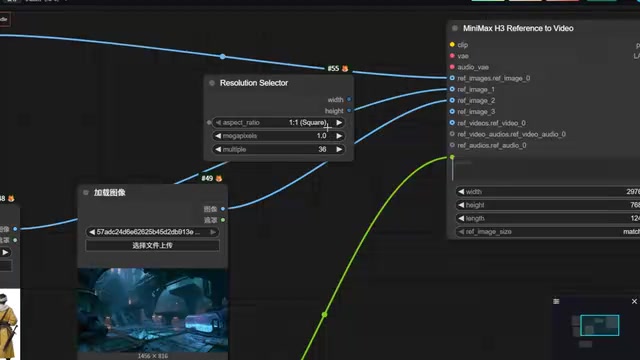
搭建从图像输入开始。整个工作流需要三个"加载图像"节点——两张人物主图和一张场景图。做法是先创建一个加载图像节点,复制两份,分别导入图一、图二、图三,再统一接入MiniMax H3采样器。
采样器方面需要搜索两个核心节点:MiniMax控格H3,以及一个F1文生视频参考采样节点。图一、图二、图三接入采样器后会自动向下延展对应接口。采样器还预留了参考视频、音频与声音参考的接口,若有素材可以导入,没有则可跳过。提示词部分通过"加载文本"节点单独接入,方便后续管理和自定义。
分辨率与时长的参数化控制
把长宽高和时长写死在采样器里并不灵活。UP主推荐用Resolution Selector节点单独控制画面的长和宽,通过名称对应接入即可。
时长控制稍微复杂一点,需要两个工具配合:一个浮点(float)参数节点,加上一个数学表达式转化器。浮点节点无法直接接入,必须经过转化器换算。核心逻辑是"帧数×时长"——以每秒24帧为例,想要10秒视频就用公式换算出总帧数。
视频里也给出了现成的数学表达式,数学不好的用户只需把表达式里的两个数字改成对应帧率即可。这里有个实用建议:标准视频24帧就足够,帧数越高画面越流畅,但对应的算力和显存开销也越大。
模型加载:Clip、UNet与双路VAE
模型部分是整套工作流的核心。需要加载的模型分三类:
- Clip模型:负责把提示词翻译成AI能理解的语义信息。搜索"Clip加载器",在模型列表里从Stable Diffusion等标准分类切换到minimax,选择int8版本。
- UNet大模型:也就是MiniMax H3的主模型。通过"unet加载器"搜索minimax_h3_int8版本加载。int8量化版本在精度与显存之间做了平衡,更适合本地部署。
- VAE解码器:这里要特别注意需要复制两份,因为音频和视频要用不同版本解码。音频VAE选fp32版本,视频VAE选fp16版本。
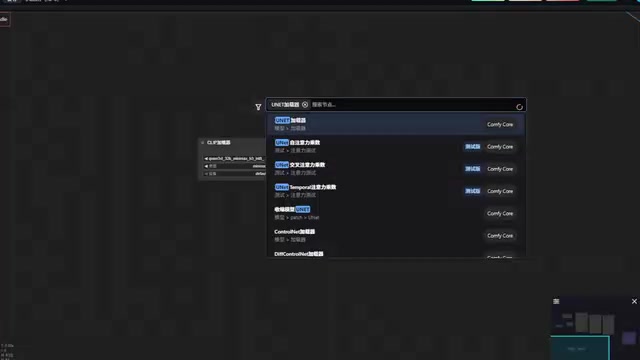
双路VAE的设计是这套工作流能输出带声音视频的关键——音频接audio,视频接video,各走各的解码通道。
int8量化是一种模型压缩技术,将神经网络权重从32位或16位浮点数压缩为8位整数表示,通常可将模型体积缩减约50-75%,显存占用同步下降。代价是计算精度有轻微损失,但在视频生成这类感知类任务上,人眼往往难以察觉差异。fp32(32位浮点)精度最高但最占显存,fp16(16位浮点)是目前GPU推理的主流折中选项。文中音频VAE选fp32是因为音频对数值精度更敏感,失真容易被耳朵察觉;视频VAE选fp16则是在画质与显存之间取得平衡。理解这一区别,有助于在后续调参时根据自身硬件做出合理取舍。
显存优化:8G显存的关键三件套
对本地部署用户来说,显存不足是最大痛点。UP主给出的解决方案是三个优化节点的组合:
- 显存优化器:搜索minimax h3 lowvram节点,降低注意力机制的显存占用,帮助调配显存。
- 分块处理节点:把显存处理分成多个批次(如4除以2,分2批次),避免一次性占满显存。
- 内存节约节点:进一步优化内存使用。
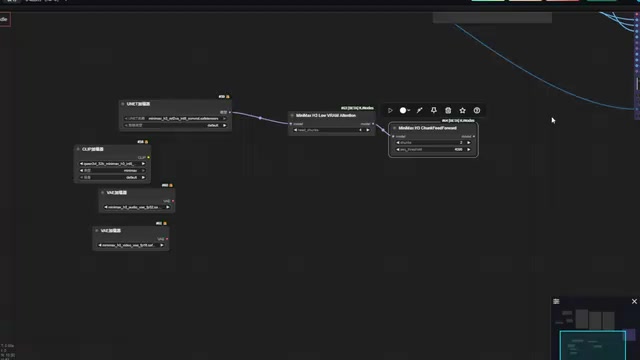
这三个节点是"8G显存可用"说法的技术基础。原理上是用时间换空间——通过分块和显存调度,让原本跑不动的模型在小显存卡上能够运行,代价是生成速度会有所下降。这也是入门显卡本地跑大模型的通用思路。
采样与合成:串起完整链路
模型加载完成后,需要把数据引导进采样系统。这一步与Flux模型的工作流高度相似:先用"基础引导"节点整合模型数据,再接入MiniMax v6采样器提供的条件,然后配置基础调度器、随机噪波(种子)、K采样器和自定义高级采样器。
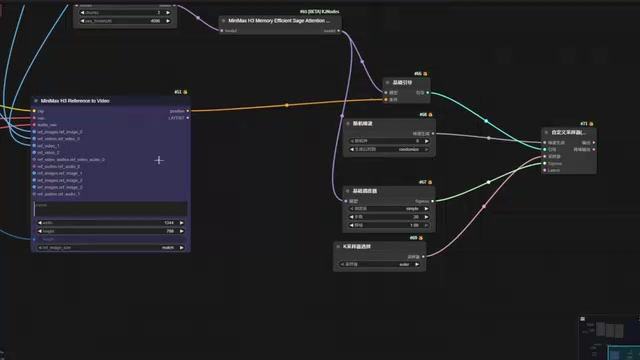
关键在于Latent(潜空间)数据的获取——它是AI混合数据的内部通道,从MiniMax video采样器的Latent接口引出即可。数据齐全后,分别用Video和Audio两个VAE解码器解码,再通过"合并为视频"节点合成。
合成时要注意帧率对齐:前面设置24帧,这里也要选24帧,否则会出问题。输出格式选择标准的MP4(video/h264)即可,文件名前缀可自定义。至此整条工作流就跑通了。
**Latent(潜空间)**是扩散模型的核心概念。AI并不直接在像素层面生成图像或视频,而是先在一个压缩的低维"潜空间"中进行噪声扩散与去噪运算,最后再由VAE解码器将潜空间表示还原为可视的像素输出。这一设计大幅降低了计算量——在潜空间操作比在原始像素空间操作快几个数量级。MiniMax H3的双路输出(视频+音频)同样各自维持独立的潜空间表示,因此需要两个VAE分别解码,而不能共用同一个解码器。理解潜空间的角色,也能帮助解释为什么"K采样器""调度器""随机噪波"这些节点的参数会直接影响最终画面质量。
上手建议
这套工作流的门槛主要在ComfyUI的节点连线逻辑上,而非模型本身。有Flux工作流经验的用户会上手很快,因为采样部分几乎一致。零基础用户按照节点顺序照做也能搭出来,但理解每个节点的作用(编码、解码、采样、调度)才能真正灵活调整。
对于硬件有限的用户,int8量化模型加上lowvram、分块、内存优化三件套,是让开源视频模型落地的现实路径。需要提醒的是,视频中的性能数据来自单一UP主演示,实际效果建议以自己的硬件测试为准。开源视频模型的本地化正在降低创作门槛,但也要理性看待"免费""最强"这类营销表述。
相关推荐
Boox Palma 3发布:新增手写笔支持与全新设计
Boox Palma 3正式发布,新增手写笔支持并采用全新简洁设计。作为口袋尺寸的黑白电子墨水屏阅读器,它在功能升级的同时价格明显上涨。本文解析Palma 3的核心变化与升级价值。
Cursor 3.0 完整入门指南:从零上手 AI 编程 IDE
Cursor 3.0 完整入门教程:从下载安装、创建项目到并行子代理、云端开发、技能与自动化等高级功能。零基础也能上手这款 AI 编程 IDE,掌握模型选择、设计模式与 Git 版本控制的实用技巧。
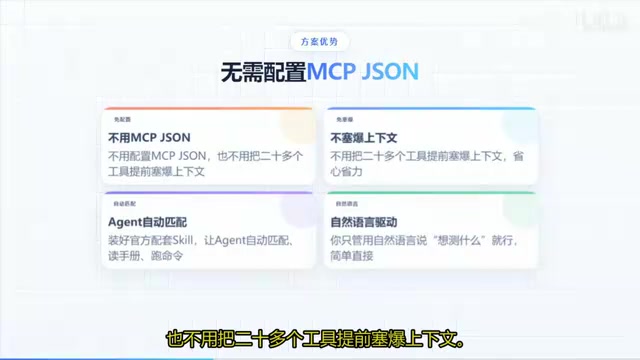
Codex+Playwright封装测试Skill:UI自动化不再手敲命令
把 Playwright 封装成 Codex Skill,让 AI Agent 通过自然语言完成 UI 自动化测试。本文详解安装加载、Sauce Demo 实战、PO 分层模板,以及 MCP 与 CLI+Skill 的选型对照。