MiniMax H3登陆Draw Things:Mac/iPad本地跑开源最强音视频模型指南
MiniMax H3音视频模型登陆Draw Things,16GB内存iPad即可本地运行。
开源音视频生成模型MiniMax H3现已在苹果生态AI工具Draw Things上获得支持,Mac和iPad用户无需依赖云端即可本地运行。该模型提供首尾帧版本(FLR VA)和参考生成版本(REF VA)两大类型,共八种量化精度。借助加速LoRA技术,Apple Silicon从M2 Ultra起的多款设备均可运行,推荐M4以上芯片搭配32GB以上内存以获得流畅体验。UP主「工具狂」在仅16GB内存的M5 iPad Pro上完成实测,推荐使用Talmate三步版加速LoRA(优化后仅182MB),并建议先从小尺寸小帧数跑通流程。提示词撰写可借助LLM自动化完成,将官方Markdown指导封装为skill技能后一键调用,大幅降低创作门槛。
开源视频模型的竞赛中,MiniMax H3被不少创作者视为当前最强大的音视频生成模型之一。它现已在苹果生态的AI工具Draw Things上正式获得支持——这意味着Mac和iPad用户第一次能在本地设备上运行这个模型,而不必完全依赖云端算力。B站UP主「工具狂」用一台仅16GB内存的M5 iPad Pro完成了实测,本文结合其分享梳理出一份可操作的上手指南。
两种模型版本:首尾帧与参考生成
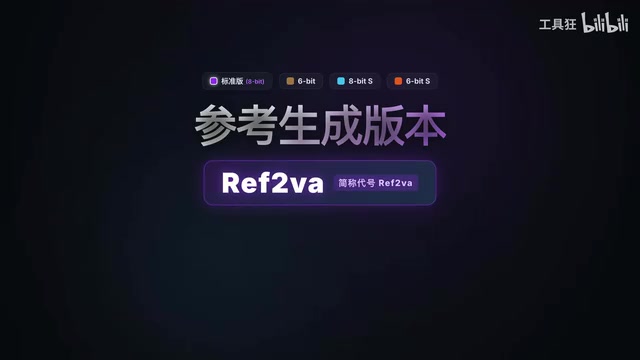
在Draw Things的模型列表中搜索「MiniMax」,会得到两种类型、八种量化精度的模型。理解这两种版本的能力边界,是决定怎么用的第一步。
第一种是首尾帧版本(FLR VA,First and Last Frame to Audio Video)。它支持文生视频、图生视频以及首尾帧视频三种模式,这也是Draw Things上首款支持首尾帧生成的模型。你可以在创意面板中放入首帧和尾帧图片,让模型补全中间的运动过程并同步生成音频。
第二种是参考生成版本(REF VA,Reference to Audio Video)。它允许放入两张或多张参考图,比如放两张人物图来生成双人对话视频。UP主用「山姆你为啥把OpenAI做成了CloseAI」这类调侃对话作为演示,展示了角色一致性和音画同步的效果。
两个版本UP主分别下载了8-bit和6-bit量化。量化精度越高画质越好,但对硬盘和内存的占用也越大。整体建议:追求本地运行的用户至少准备M4级设备并下载6-bit或8-bit版本,同时留出充足的硬盘空间。
量化(Quantization)是将模型权重从高精度浮点数(如FP16/BF16)压缩为低位整数的技术,核心目标是在有限的内存中运行更大的模型。8-bit量化意味着每个权重用8位整数存储,相比原始精度约节省50%内存;6-bit则进一步压缩,内存占用更小,但理论上存在轻微的精度损失。对于MiniMax H3这类原始参数量极大的视频模型,量化是在消费级设备上本地运行的前提条件,而非可选优化。用户在选择版本时,通常需要在画质与硬件可行性之间做权衡:内存充裕(64GB以上)的设备可优先考虑8-bit版本;内存较紧张的设备则以6-bit版本优先保证能跑通流程。
硬件门槛与加速LoRA
「我的设备到底能不能本地跑」是苹果用户最关心的问题。答案的关键,藏在加速LoRA里。
目前MiniMax H3的加速生态已有多个厂商和个人推出的LoRA,UP主测试了三个版本:LightX RV的四步版、LarryVRH的四步版,以及Talmate的三步版。结论是他最偏爱Talmate的三步版本——用更少的步数就取得了更优的结果。经过K神KeyJay优化后的版本体积仅182MB,导入Draw Things即可完美运行。
在加速LoRA的加持下,运行门槛被大幅拉低。据UP主结合社区网友反馈的测算:Apple Silicon从M2 Ultra开始的许多设备都能本地运行,内存越大越有优势。若想要更流畅的体验,则推荐M4以上芯片搭配32GB及以上内存,才能在更大尺寸、更长时长上从容发挥。
实测层面,UP主给出了务实的调参路径:先从小尺寸(如576×384)、较少帧数(如107帧)开始跑通流程,再逐步加大尺寸和帧数。第一步把参数跑通才是关键,追求高清画质则确实需要更强的硬件,或者退而使用Draw Things官方的云计算服务作为弱配置设备的补充方案。
加速LoRA(Low-Rank Adaptation)在视频生成语境下的作用与文本生成中不同——它并非用于改变模型风格,而是通过蒸馏训练让模型学会以更少的去噪步数达到接近原始质量的输出。传统扩散模型视频生成通常需要数十步迭代,而经过加速LoRA训练后,3至4步即可完成采样,推理时间可大幅缩短至原来的十分之一左右。这类技术与文本模型领域的一致性蒸馏(Consistency Distillation)思路相近,近年来已被广泛应用于Wan、HunyuanVideo等主流开源视频模型的本地部署加速,是让大型视频模型在消费级苹果硬件上变得实用的关键环节。
用LLM搞定提示词
现在的视频提示词规划几乎都交给大语言模型完成,用户只需给出简单指令。UP主把MiniMax H3首尾帧版本和参考生成版本的提示词撰写指导整理成了两份Markdown文档。
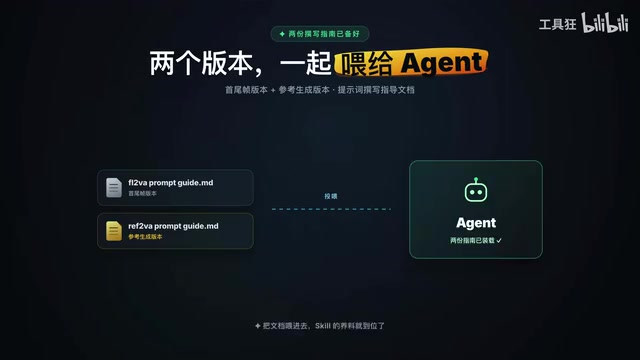
具体做法是:把这两份文档喂给LLM,让Agent创建一个类似「MiniMax H3 Prompt生成器」的技能(skill)。此后无论要做文生视频、图生视频、首尾帧视频还是参考生成视频,只需通过斜杠命令调取该技能并描述需求即可。
举例来说,做图生视频时,粘贴首帧图片后告诉LLM:「画面需要火山剧烈喷发、岩浆流动的声音,无人机以俯冲视角冲到MiniMax巨大文字下方,很惊险,随后感受到文字开始坍塌。」LLM会输出结构化提示词,粘贴回Draw Things即可生成,效果相当出色。
值得期待的下一步
UP主也坦言受时间所限,还有很多细节尚未覆盖。他最期待的方向是:当Draw Things支持音频加图片作为共同输入条件时,就有望创建超过15秒、且声音一致性连贯的短片。这将把当前以短片段为主的生成能力,推向更完整的叙事表达。
对苹果生态用户而言,MiniMax H3在Draw Things上的落地是一次实打实的能力下放:过去被视为需要独立显卡和大量显存的音视频生成,如今在一台16GB内存的iPad上也能跑起来。对于内容创作者,现在或许正是动手实测自己设备边界的好时机。
相关推荐
DeepSeek Harness渗透测试模式实测:AI辅助漏洞挖掘的能力与边界
本文解析基于DeepSeek Harness渗透测试模式与专用SKILLS技能包的AI辅助漏洞挖掘工作流,涵盖信息收集、后门RCE、数据库凭证泄露等实测结果,并探讨其成本控制与安全双刃剑效应。
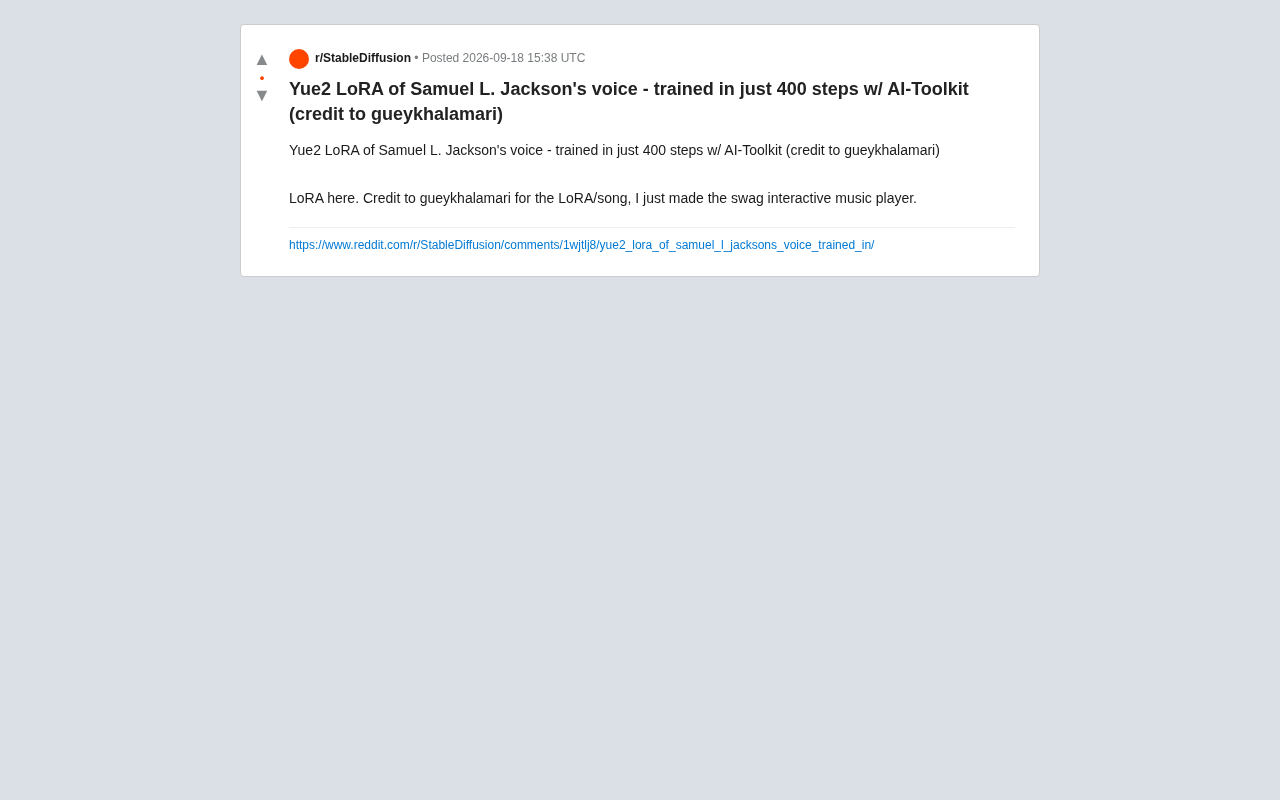
Yue2 音乐模型 LoRA 实测:400 步复刻名人音色
一个基于 Yue2 音乐模型、用 AI-Toolkit 仅 400 步训练出的名人音色 LoRA 在 Reddit 走红。本文解析其技术意义、效果局限与背后的音色克隆版权伦理问题。
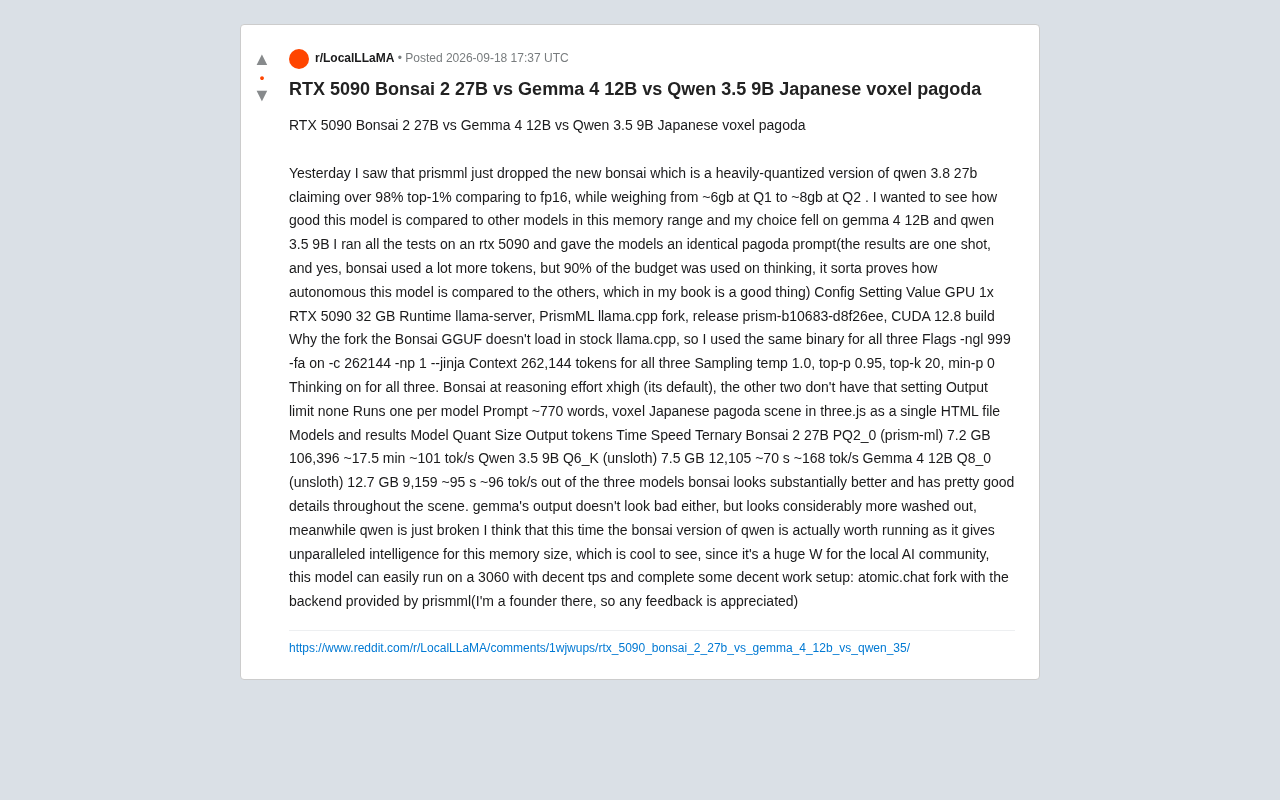
低显存本地大模型对决:Bonsai 2量化版为何胜出
Reddit 用户在 RTX 5090 上横评 Bonsai 2 27B、Gemma 4 12B 与 Qwen 3.5 9B。基于三元量化的 Bonsai 用 7.2GB 显存实现更优的日式体素宝塔渲染效果,展现低显存本地大模型的量化新趋势。