模型置信度校准:智能体决策的关键难题

置信度校准让AI智能体知道"自己何时可能出错",是连接模型能力与自动化决策的关键桥梁。
本文围绕"置信度校准"这一机器学习核心难题展开,指出真正校准良好的置信度分数应精确反映输出正确的概率,而现实中大多数模型要么过度自信、要么过度保守。文章以文档信息抽取为典型场景,说明可信的置信度分数如何驱动"自动处理还是人工复核"的工程决策。通过调节置信度阈值,团队可以在精确率(准确性)与召回率(覆盖率)之间灵活权衡——高阈值保质量,低阈值保覆盖,阈值本质上是一个可按业务风险偏好调节的"旋钮"。文章最终强调:置信度的可信度与模型准确率同等关键,一个"知道自己不知道"的模型往往比盲目自信的高准确率模型更适合生产环境。
为什么模型不确定性是个难题
预测模型的不确定性一直是机器学习工程中最棘手的问题之一。一个真正"校准良好"(calibrated)的置信度分数,本质上应该是对输出正确概率的精确估计——当模型说自己有 90% 的把握时,它就应该在 90% 的情况下是对的。
听起来简单,但现实中大多数模型的置信度都是失真的。它们要么过度自信(给出高分却频频出错),要么过度保守。对于需要自动化决策的系统而言,这种失真会直接转化为业务风险。
校准程度通常用"可靠性图"(reliability diagram / calibration curve)来可视化:将预测置信度按区间分桶,横轴是模型输出的置信度,纵轴是该区间内样本的实际准确率,若两者完美重合则说明模型校准良好。定量指标则常用 ECE(Expected Calibration Error,期望校准误差),它计算各桶置信度与实际准确率之差的加权平均值,越低越好。深度神经网络普遍存在"过度自信"问题——这一现象在 2017 年 Guo 等人的论文《On Calibration of Modern Neural Networks》中被系统记录,研究发现现代深度网络比早期的浅层网络校准更差,主要原因是过度参数化与缺乏正则化。常见的事后校准方法包括温度缩放(Temperature Scaling)、Platt Scaling 和保序回归(Isotonic Regression),它们无需重新训练模型,只在推理阶段对输出 logits 或概率做映射修正。
校准置信度对智能体决策的价值
随着 AI 智能体(agent)开始承担越来越多的自动化任务,置信度校准的重要性被急剧放大。以文档信息抽取(document extraction)为例,这是一个典型的高频、大规模的自动化场景:系统需要从发票、合同、表单中提取字段值。
在这类任务中,模型不仅要给出抽取结果,更要诚实地告诉使用者"我对这个结果有多大把握"。只有当置信度分数真实可信时,下游系统才能据此做出"是否需要人工复核"的决策。这正是校准置信度的核心用武之地——它把一个模糊的概率问题,转化成了可操作的工程决策。
用置信度阈值权衡精确率与召回率
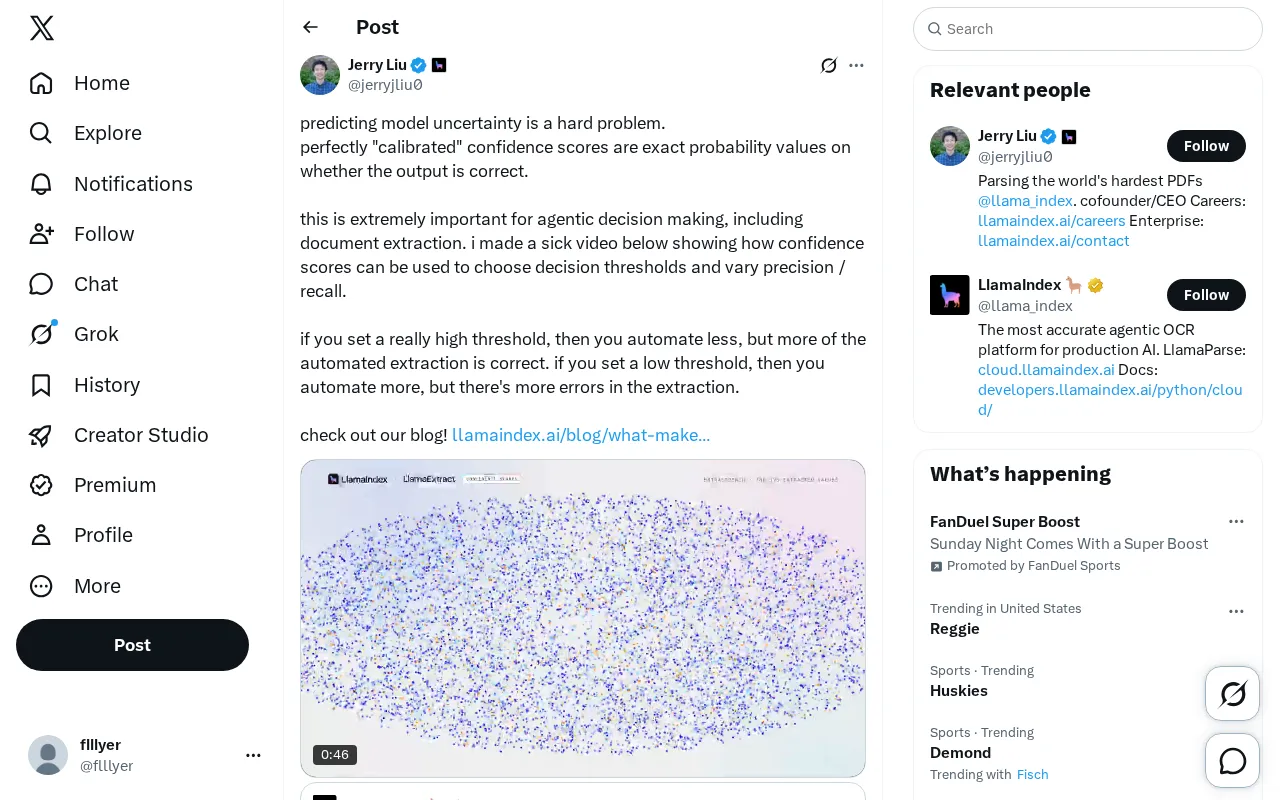
原作者在其分享中演示了一个直观的机制:如何用置信度分数来设定决策阈值,从而在精确率(precision)和召回率(recall)之间做权衡。
这个权衡的逻辑非常清晰:
- 设置较高的阈值:系统只会自动处理那些置信度极高的抽取结果。这意味着自动化的比例下降,但被自动化处理的部分正确率更高。
- 设置较低的阈值:系统会自动处理更多结果,自动化覆盖率提升,但代价是抽取错误的数量也随之增加。
换句话说,阈值本质上是一个业务旋钮。企业可以根据自身对错误的容忍度来调节:金融、法律等高风险场景倾向于设高阈值、保留更多人工审核;而对错误不那么敏感的场景则可以放低阈值、追求更高的自动化率。
精确率(Precision)指模型判定为正例的样本中真正为正例的比例,关注的是"预测为正的结果有多准";召回率(Recall)则指所有真正正例中被模型成功识别的比例,关注的是"有多少正例被找到"。两者通常呈反向关系,可以用 PR 曲线(Precision-Recall Curve)综合展示不同阈值下的权衡轨迹,曲线下面积(AUC-PR)常作为不平衡数据集上的模型评估指标。在文档抽取场景中,"精确率"对应自动化处理结果的正确率,"召回率"对应被自动化覆盖的字段比例——阈值调节本质上是在这条 PR 曲线上选取符合业务需求的操作点(operating point)。F1 分数是精确率与召回率的调和平均,当两者重要性相当时常用作综合衡量指标;若业务上对精确率和召回率的权重不同,可改用 Fβ 分数来体现优先级。
从概率到可落地的自动化策略
这一思路的深层意义在于,它把"模型好不好用"这个抽象问题,落地成了可量化、可调节的自动化策略。校准良好的置信度分数就像一套可靠的仪表盘,让工程团队能够精细地控制自动化流程中"机器处理"与"人工介入"的比例。
对于正在构建智能体系统的团队来说,这提供了一个重要启示:模型的原始准确率固然重要,但置信度的可信度同样关键。一个准确率略低但置信度校准良好的模型,往往比一个准确率更高却"盲目自信"的模型更适合投入生产环境——因为前者知道自己什么时候可能出错。
这种"机器处理 vs. 人工介入"的混合模式在学术上被称为"人机协作"(human-in-the-loop,HITL)或"择机移交"(selective prediction / learning to abstain)。其核心思想是赋予模型"拒绝回答"的权利:当置信度低于阈值时,系统主动将样本路由给人工处理,而非强行给出低质量答案。这在高风险自动化场景中尤为重要——HITL 系统的实际吞吐量和人工成本,可以通过置信度分布直接估算:若 80% 的样本置信度超过阈值,则理论上只需人工处理剩余 20%,从而量化自动化收益与人力成本之间的 ROI。要让这套机制持续有效,还需要定期监控生产环境中的置信度分布,防止因数据漂移(data drift)导致原本校准良好的模型在新数据上重新失准。
小结
置信度校准是连接模型能力与实际业务价值的桥梁。它让 AI 系统不只是给出答案,还能诚实地评估答案的可靠性,进而支撑起精确率与召回率之间的动态权衡。随着智能体在文档处理等场景中的普及,这种"知道自己不知道"的能力,将成为衡量 AI 系统成熟度的重要指标。
注:本文基于一条社交媒体分享整理,作者提到其博客中有更详细的演示视频,感兴趣的读者可进一步查阅原始来源。
相关推荐

AI数字分身实战:用DOT自动追踪Bug与用户反馈
DOTS 团队工程师演示如何用 AI 数字分身 DOT 跨平台收集用户反馈、自动归类问题主题、开线程调查 Bug 根因并直接提交 PR,展示 AI 代理参与缺陷分诊的完整工作流与可审计设计。

晶体管为何不再扁平?从平面到环绕栅极的演进
晶体管从平面到FinFET再到环绕栅极的演进:为何栅极需要从三面包裹到四面环绕,以抑制短沟道效应和泄漏电流,延续摩尔定律。

蜂群思维=单个RL智能体?多臂老虎机等价性证明
一篇论文证明蜂群通过局部模仿进行的集体决策,在数学上等价于单智能体强化学习。N个盲目模仿者相当于N个并行环境采样,有效学习率为1/N。本文解读Maynard-Cross Learning算法的推导与影响。