MQA与GQA详解:KV Cache如何降低大模型推理显存
MQA与GQA通过共享KV缓存大幅降低大模型推理显存占用与带宽瓶颈,已成为主流大模型默认配置。
大语言模型推理时,标准多头注意力(MHA)要求每个注意力头独立缓存键值(KV Cache),随序列变长显存迅速膨胀、带宽成为瓶颈。MQA(多查询注意力,2019)让所有头共享同一份Key和Value,将KV Cache内存削减75%,解码速度从46ms降至3.8ms,代价仅0.3困惑度的质量损失。GQA(分组查询注意力,2023)进一步折中:引入组数参数G,将注意力头分成若干组,组内共享键值。G=1退化为MQA,G=头数退化为MHA,可在内存效率与模型质量之间精确调节。T5实测中GQA速度接近MQA(0.28s vs 0.24s),却几乎完全恢复了MHA的质量。凭借这一出色的权衡,GQA在数月内从研究成果变为LLaMA、Mistral等主流大模型的工程默认配置。
大语言模型在推理时,显存占用和带宽瓶颈一直是绕不开的难题。KV Cache 的引入解决了重复计算的问题——键(Key)和值(Value)只需存储一次便可反复复用。但在标准的多头注意力(Multi-Head Attention,MHA)机制下,每个注意力头都要在缓存里保留独立的一份键值副本。随着序列变长,缓存迅速膨胀,GPU 显存被吃光;即便显存还没撑爆,每一步解码都要搬运这个不断增长的缓存,也会制造严重的带宽瓶颈。
这篇文章围绕 B站 Visual AI 频道的讲解,梳理 MQA(Multi-Query Attention)与 GQA(Grouped-Query Attention)两种优化方案的核心思路、代价与收益,帮助理解它们为何成为当下主流大模型的默认配置。
问题的根源:KV Cache 为何膨胀
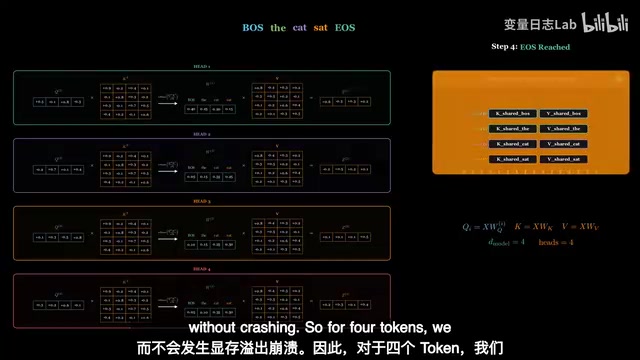
以第一个 token(BOS)为例,假设有 4 个注意力头,那么它一进来就会在显存中产生 4 对键值对。问题随之而来:我们真的需要四份独立的键和值吗?还是说,各个头可以通过各自的查询(Query)保留不同视角,同时共享一份对过去的共同记忆?
关键在于区分 Query 与 Key/Value 的生命周期。Query 不会累积——它们被创建、用于单步解码、然后丢弃。而 Key 和 Value 不同,它们会驻留在显存里,并随着每个新 token 不断增长。这正是 KV Cache 持续变大的根本原因。
在 4 个 token、MHA 的设定下,模型每个 token 要存 8 份头缓存(4 个 Key + 4 个 Value),4 个 token 累计 32 条目。缓存开销随头数线性放大。
KV Cache 的本质是一种以空间换时间的机制。在自回归生成中,模型每次只预测一个新 token,但计算注意力时需要「看到」所有历史 token 的上下文。若不缓存,每生成一个 token 就要重新计算所有历史 token 的 Key 和 Value,计算量随序列长度平方级增长。KV Cache 将这些中间结果保存在 GPU 显存中,使得重复计算降为零,代价是显存占用随序列长度线性增长。
具体来说,对于一个隐藏维度为 d、头数为 h、序列长度为 L 的模型,MHA 的 KV Cache 大小约为 2 × h × L × (d/h) = 2 × L × d。当 d 达到数千、序列长度上万、且同时运行数百个并发请求时,总显存需求轻松超过单张 GPU 的容量。这正是 MQA 和 GQA 要解决的工程核心问题。
MQA:让所有头共享一份键值
多查询注意力(MQA)最早在 2019 年的论文《Fast Transformer Decoding》中提出。它的做法很直接:不再存储四套不同的键值,而是使用一份共享的 Key 和 Value。
推理时,token 依然逐个到达。当 BOS 进来,我们为 4 个头生成 4 个不同的 Query 向量;但在键值这一侧,只写入一条共享条目。每个头用各自的 Query 与共享的 Key 做点积、softmax 得到注意力权重,再对共享的 Value 做加权求和得到输出。此后每个 token 都重复这一过程:生成各异的 Query,却从同一份 Key/Value 读取。
无论添加多少头,每步只向缓存写入一条。缓存的增长只取决于序列长度,而不是头数。于是同样的 4 个 token,MQA 只存 4 条目,而非 MHA 的 16 条——整体 KV Cache 内存削减了 75%。
这不仅是内存上的胜利。每一步解码从显存读取的数据大幅减少,缓解了带宽瓶颈,推理速度也随之提升。论文给出的实测数据相当惊人:MHA 下每步解码约需 46 毫秒,MQA 降到仅 3.8 毫秒;在 Beam4 搜索下差距更大,从 203 毫秒降到 32 毫秒。
MQA 在实现层面的变化非常小,却影响深远。在标准 MHA 中,Q、K、V 三个投影矩阵的形状均为 [d_model, h × d_head];而在 MQA 中,K 和 V 的投影矩阵被压缩为 [d_model, d_head],即只保留单头尺寸,Query 投影矩阵则保持不变,仍为 [d_model, h × d_head]。这意味着 MQA 的参数量变化很小,但 KV Cache 的存储量从正比于头数降为常数。
值得注意的是,MQA 并非凭空「发明」于 2019 年——它更像是对一个已经存在的直觉(头之间的 Key/Value 是否真的需要完全独立?)给出了系统性验证。后续研究发现,在大规模预训练场景下直接使用 MQA 训练比从 MHA 微调转换效果更好,这也影响了后来 GQA 论文中关于「检查点转换」的讨论方向。
代价:共享键值对质量的影响
省了这么多,自然要问一句:让所有头共享键值,到底对模型质量有多大损害?
论文用困惑度(perplexity)来衡量,可以理解为模型预测下一个 token 时的信心程度。在 Billion Word 基准上,标准 MHA 得分 29.9,MQA 得分 30.2——仅上升了 0.3。这确实是真实的代价,但考虑到 KV Cache 被削减到原来的四分之一,这个代价小得惊人。
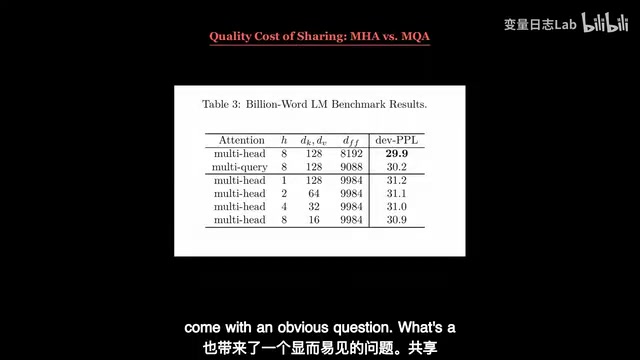
速度收益巨大,质量损失微小,但它毕竟还是一笔开销。于是又引出一个问题:MQA 是否走得太极端了?每个头都被强制塞进同一个共享笔记本,没有任何例外,这真的有必要吗?
GQA:在两极之间找到平衡
分组查询注意力(GQA)由 Google 于 2023 年在论文中提出,它的思路是折中:与其让全部四个头共享同一个笔记本,不如发两个——两个头共享一份键值,另外两个头共享另一份。它在几乎不牺牲内存收益的前提下,把 MQA 丢掉的质量找了回来。
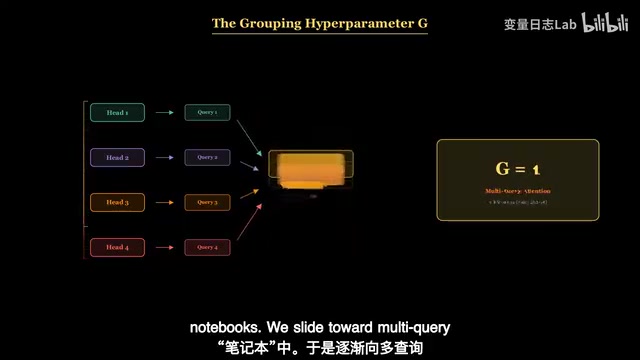
GQA 给了我们一个旋钮:组数 G。把 G 调大,组变小,每个头拥有更多独享的笔记本,逐渐滑向完整的 MHA;把 G 调小,组变大,更多头挤进更少的笔记本,逐渐滑向 MQA。我们不必在两个极端里二选一,而是可以精确决定愿意用多少质量去换速度。
从数学上看,GQA 几乎与标准 MHA 一样,只有一处小改动:对任意查询头 i,它的键值来自所在的组 G(i)。当 G 等于 1,所有头共享单一组,退化为 MQA;当 G 等于头数 h,每个头自成一组,就是标准 MHA。一个参数即可在最高质量与最高速度之间任意滑动。
GQA 论文(Ainslie et al., 2023,Google Research)除了提出分组机制本身,还解决了一个实际工程问题:如何将已经用 MHA 训练好的模型检查点转换为 GQA,而无需从头训练。论文提出的方法是对同一组内的多个 MHA 头的 Key/Value 投影矩阵取均值(mean pooling),然后用少量数据微调以恢复质量。这一「uptrain」策略让现有模型能以相对低廉的成本享受 GQA 的推理收益,也是 GQA 得以快速被工业界采纳的重要原因之一——不必为了推理效率付出重新预训练的巨大代价。
实际效果与行业采纳
生成过程中,BOS 进来时依然生成 4 个独立 Query,但只投影 2 对键值(每组一对)。每个头从自己所属组的笔记本里读取,完成真正的注意力计算。
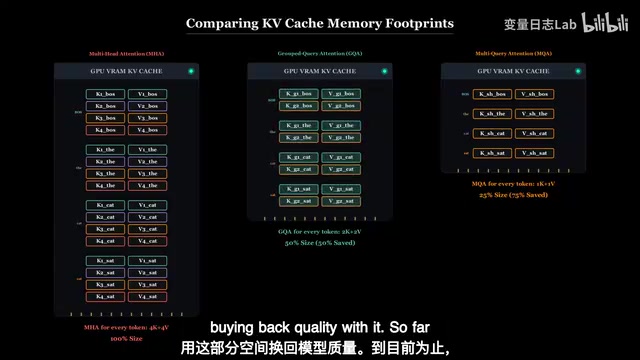
反映到 KV Cache 上很清晰:同样 4 个 token,MQA 只留 4 条、MHA 留 16 条,而 GQA 正好落在中间,缓存持有 8 条。按每 token 计算,MHA 存 8 份头缓存,MQA 降到 2 份,GQA 介于其间为 4 份(2 个 Key、2 个 Value)。在这个四头例子里,GQA 相比完整 MHA 节省 50% 内存,MQA 则节省 75%;随着真实模型头数增多,节省只会更大。GQA 是刻意留下一部分最大节省空间,用来回购质量。
论文并非只在四头的玩具例子上验证,而是用了更大的 T5 模型,头数分成 8 组而非 2 组。结果令人满意:MHA 每步 1.51 秒,MQA 降到 0.24 秒,GQA 落在 0.28 秒——几乎与 MQA 一样快,却恢复了 MHA 几乎全部的质量。
这个权衡足够好,好到在数月之内就从研究好奇心变成了工程标配。LLaMA 采用了它,随后 Mistral 等模型跟进。如今,GQA 已经更接近默认选项,而非例外。
相关推荐

@ai-sdk/vue 3.0.306 补丁发布 同步 [email protected] 更新
@ai-sdk/vue 3.0.306 发布,与 [email protected] 同步更新。这是 Vercel AI SDK 生态的一次常规补丁发布,无公开 API 变更,Vue 适配层保持与核心包版本对齐。

Gemini 4 Argon API发布:百万级输出Token时代来临
Google 正式发布 Gemini 4 Argon,稀疏 MoE 架构支持最高 100 万输出 token,Vals Index 以 68.90% 登顶,覆盖 API、AI Studio 和 Gemini 应用三端。

DukaanAI:用开源AI把商品照片变成库存清单
DukaanAI 是一款面向小零售商的 AI 库存工具,通过 Gemma 3 开源模型将商品照片转为库存条目,支持本地推理、字段编辑与 CSV 导出,探索 AI 辅助商品目录创建的可行路径。