目标驱动的流程变体分类:用LLM连接行为与业务目标
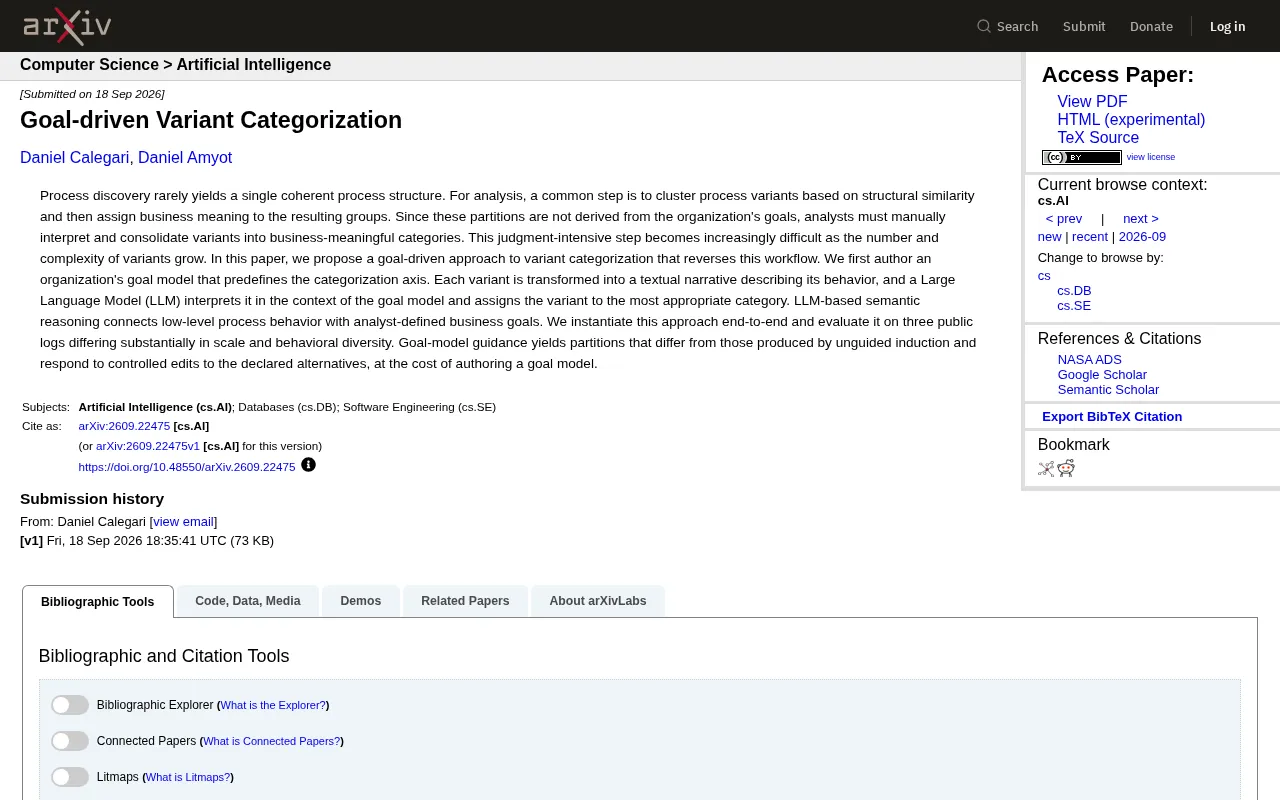
用预定义目标模型加LLM语义推理,替代传统结构聚类来驱动流程变体分类。
这篇arXiv论文针对流程挖掘中变体分类依赖结构聚类、需大量人工解读的痛点,提出了一种「目标驱动」的新范式。其核心是反转传统工作流:先由分析师构建目标模型,预先确定分类维度;再将每个流程变体转化为自然语言叙述,交由大语言模型在目标模型的上下文中完成归类。LLM的语义推理能力充当桥梁,将底层执行行为映射到高层业务目标。研究在三个规模与行为多样性各异的公开事件日志上进行了评估,结果显示目标引导的分区与无引导归纳结果明显不同,且对目标模型的修改有可预期的响应,体现了方法的可控性。代价在于需要额外投入构建目标模型这一前置成本。
流程挖掘中的变体分类难题
流程挖掘(Process Discovery)在实践中很少能产出一个单一、连贯的流程结构。真实业务系统运行时会产生大量流程变体(process variants)——同一个业务流程在执行层面存在诸多细微差异的路径。为了让这些变体可供分析,业界通行做法是先按照结构相似度对变体进行聚类,再为聚类出的每个分组赋予业务含义。
问题在于,这些聚类分区并非源自组织的业务目标,而是从流程数据的结构特征中机械归纳出来的。这意味着分析师必须手动去解读每个分组,并将变体整合成对业务有意义的类别。当变体的数量与复杂度不断攀升时,这一高度依赖人工判断的步骤会变得越来越棘手。
流程挖掘本质上是从事件日志(event log)中自动提取业务流程模型的技术。事件日志由系统记录的一系列带时间戳的活动事件组成,每一条完整的执行记录称为一个案例(case)。当不同案例经历的活动序列存在差异时,便形成了流程变体。在真实的企业信息系统(如ERP、CRM)中,即便是同一个业务流程,也可能因为客户类型、异常处理、人员操作习惯等因素产生数十乃至数百种变体。传统的结构相似度聚类通常依赖编辑距离或控制流图的拓扑相似性来归并变体,这类度量方式只能捕捉执行路径的表面形态,无法感知活动背后的业务含义。这正是纯数据驱动分类方法的根本瓶颈:两个结构相近的变体可能对应完全不同的业务场景,而结构迥异的变体却可能在业务目标上高度一致。
反转工作流:先定义目标,再归类变体
这篇arXiv论文提出的核心思路,是反转传统的分类工作流。传统流程是「先聚类、后赋予意义」,而该研究主张「先定义目标、后归类变体」。
具体做法分为几个环节:研究者首先为组织构建一个目标模型(goal model),这个模型预先定义了分类的坐标轴(categorization axis)——也就是说,分类的维度和标准由业务目标事先确定,而不是从数据中被动发现。随后,每个流程变体会被转化为一段文本叙述(textual narrative),用自然语言描述它的行为特征。
LLM扮演的语义桥梁角色
关键的一步交给了大语言模型:LLM在目标模型的上下文中解读每个变体的文本叙述,并将其分配到最合适的类别。论文强调,正是LLM的语义推理能力,把底层的流程行为与分析师定义的高层业务目标连接了起来。
这种设计的巧妙之处在于,它绕开了纯结构相似度聚类的局限。结构上相近的两个变体,未必服务于相同的业务目标;反过来,结构差异较大的变体,也可能在业务语义上属于同一类。LLM的介入,让分类能够真正围绕「业务意图」而非「数据形态」展开。
目标模型(goal model)是需求工程与业务分析领域的成熟工具,常见形式包括i*框架、KAOS方法等。其核心思想是将组织意图层次化地表达为目标、子目标及其依赖关系,而非直接描述系统行为。在本文语境中,目标模型的作用是预先定义「我们关心哪些业务维度」——例如「案例是否经历了例外审批」「处理路径是否满足合规要求」——从而把分类的坐标轴锚定在业务语义上,而不是留给数据特征自行决定。将流程变体转化为文本叙述的步骤同样关键:这一转换将结构化的活动序列映射为自然语言,使LLM能够利用其预训练中积累的语义知识来理解流程行为,而无需专门针对流程图结构进行特殊适配。
实验评估与发现
研究团队将这套方法端到端地实例化,并在三个公开日志数据集上进行了评估。这三个数据集在规模和行为多样性上差异显著,因此能较好地检验方法的适应性。
评估得出了几个值得关注的结论:
- 目标模型引导产生的分区,与无引导归纳(unguided induction)产生的分区明显不同。这说明目标驱动的方法确实改变了分类结果,而非只是换了种方式复现结构聚类。
- 该方法对声明的备选类别(declared alternatives)的受控修改有响应。换句话说,当分析师调整目标模型中的类别定义时,分类结果会随之相应变化——这体现了方法的可控性与可解释性。
- 代价在于需要额外投入构建目标模型(authoring a goal model)。这是这套方法相较于自动聚类必须付出的前置成本。
方法的价值与局限
从价值角度看,这项工作代表了一个有意义的方向:把LLM的语义理解能力嵌入到流程分析的具体环节中,让机器承担原本需要分析师大量人工判断的解读工作。当变体数量庞大、人工整合难以为继时,这种自动化的语义归类具备实际吸引力。
同时也应清醒看待其局限。构建高质量的目标模型本身需要专业知识和人力投入,这一前置成本是否划算,取决于具体场景的变体规模与分析频率。此外,论文将LLM作为语义推理的核心,其分类结果的稳定性、可复现性以及在不同领域目标模型下的表现,都还需要更广泛的验证。
对于关注流程挖掘、业务流程管理(BPM)与LLM应用交叉领域的读者而言,这篇研究提供了一个清晰的范式样本:用预定义的目标模型约束分类维度,用大模型完成从行为到语义的映射,从而让流程变体分析更贴合组织真正关心的业务目标。
相关推荐
Cohere质疑开源模型与Anthropic IPO同日:巧合还是策略?
Reddit用户发现Cohere批评开源模型的文章与Anthropic提交IPO在同一天发布,引发社区对闭源厂商公共言论商业动机的讨论。本文分析这一时间巧合背后的开源与闭源之争,以及社区反应揭示的信任问题。
纽约ROS开发者聚会:四家机器人公司演讲
纽约ROS开发者聚会将于周四在谷歌办公室举行,Fauna Robotics、Intrinsic、Tangent Robotics、Cohesive Robotics等公司代表将发表演讲,活动免费并提供餐饮,开放报名与演讲征集。
本地AI王者:日耗12M token背后的算力差距与竞争焦虑
Reddit开发者自嘲本地AI王者:日耗12M token,却被每分钟34M token的云端玩家降维打击。文章探讨本地部署与云端自动化的算力差距、token消耗量背后的行业焦虑,以及开发者如何在两种模式间找到平衡。