n8n:可自托管的AI工作流自动化平台深度解析
n8n是可自托管的可视化AI工作流平台,帮助团队连接AI与业务系统、摆脱单一模型厂商绑定。
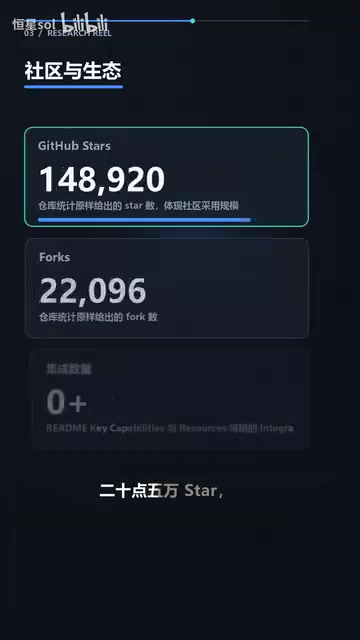
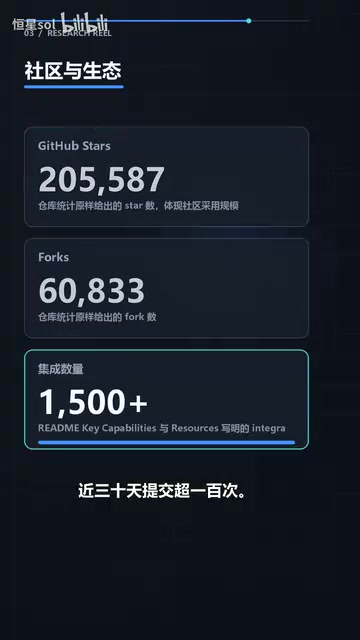
n8n是一个采用Fair-code许可的可自托管工作流自动化平台,以可视化节点拼接的方式将AI能力、业务系统与自动化逻辑串联起来。它支持聊天触发、大模型调用与记忆管理等AI对话所需的核心模块,同时允许在流程中嵌入JavaScript或Python代码,兼顾易用性与灵活性。平台拥有超过1500个第三方集成和9000多个可复用模板,GitHub上积累逾20.5万Star并保持高频更新。其核心价值不在于提供某款具体的AI模型,而在于充当连接AI与企业业务系统的「中枢」——当模型成为流程中一个可随时替换的节点,团队便获得了对整体技术架构的真正掌控权,从而避免被单一模型厂商的接口变动或涨价所被动影响。
在AI应用落地的过程中,越来越多的团队意识到一个问题:过度依赖单一模型厂商的封闭平台,往往会陷入被动。接口一旦变动、定价一旦上调,或者需要接入企业内部系统时,绑定式的方案就显得力不从心。n8n正是在这样的背景下受到关注——它是一个可自托管的工作流自动化平台,把AI能力、业务系统与自动化逻辑用可视化的方式串联起来。
用可视化节点搭建AI工作流
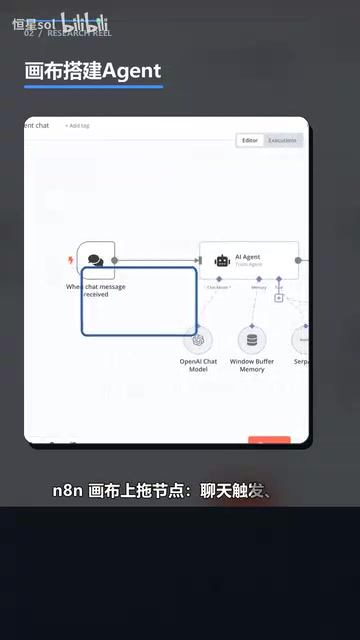
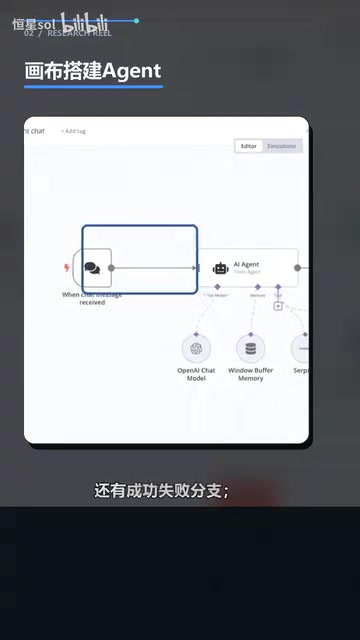
n8n的核心理念是「画」而非「写」。整个自动化流程通过节点(Node)拼接完成,从聊天触发(Chat Trigger)到接入大模型(Chat Model),再到记忆管理(Memory),每一个环节都以可视化的方式呈现。这种设计降低了搭建AI应用的门槛,让不擅长编码的业务人员也能理解和参与流程设计。
对于AI对话类应用来说,Chat Model与Memory的组合尤为关键。前者负责调用底层模型能力,后者则维护对话上下文,让机器人能够记住此前的交流内容。n8n把这些原本需要大量胶水代码才能实现的能力,抽象成了可拖拽的节点,同时保留了成功、失败分支的处理逻辑,方便应对真实业务中不可避免的异常情况。
Memory节点在AI对话应用中承担的是上下文持久化的职责,其底层实现方式直接影响对话质量与系统性能。n8n支持多种记忆后端,包括基于窗口缓冲的短期记忆(Window Buffer Memory,仅保留最近N轮对话)、基于向量数据库的长期记忆(如Pinecone、Supabase Vector),以及基于摘要的压缩记忆。不同方案在Token消耗、检索精度与延迟之间各有取舍:窗口缓冲实现最简单但容易丢失早期信息;向量检索能支持更长的历史回溯,但引入了额外的嵌入计算开销。在搭建多轮对话类应用时,记忆策略的选择往往比模型本身对体验的影响更为直接,这也是n8n将Memory抽象为独立节点而非内置默认行为的原因之一。
低代码不等于没代码
值得肯定的是,n8n并没有为了追求「零代码」而牺牲灵活性。当可视化节点无法满足复杂需求时,用户可以直接在流程中嵌入JavaScript或Python代码块,编写自定义逻辑。这种「低代码为主、代码为辅」的混合模式,兼顾了易用性与扩展能力。
这一点对开发者友好度很高。业务逻辑简单的部分用节点快速搭建,遇到特殊数据处理、复杂计算或第三方接口对接时,再用熟悉的编程语言补足。相比纯代码框架的高门槛和纯低代码工具的天花板,n8n找到了一个务实的平衡点。
庞大的集成与模板生态
一个自动化平台的实用价值,很大程度上取决于它能连接多少外部服务。n8n目前提供超过1500个集成,涵盖常见的数据库、SaaS工具、通信平台以及各类API。这意味着无论是把AI输出推送到企业IM,还是从CRM拉取数据做处理,大多数场景都能找到现成的连接方式。
除了集成数量,n8n还沉淀了9000多个可复用模板。对于刚上手的用户,模板库能显著缩短从零到可用的时间——直接套用相近场景的模板,再按需调整,比从空白画布开始高效得多。这套生态也从侧面反映了社区的活跃程度。
开源、活跃与自托管的自由
n8n在GitHub上已积累超过20.5万Star,近30天的代码提交超过100次,项目保持着高频迭代,最新版本更新到2.39.10。这样的活跃度对于一个需要长期依赖的基础设施类工具而言,是重要的信心来源。
许可方面,n8n采用的是Fair-code许可模式。这与传统的完全开源协议有所区别——它允许自由使用、修改和自托管,但对商业化的托管服务有一定限制。对多数团队来说,最实际的价值在于「自托管或上云都行」的部署灵活性:既可以把整套系统部署在自己的服务器上,保证数据不出域、避免被厂商绑定,也可以选择官方云服务省去运维成本。
Fair-code并非一种标准化的开源许可证,而是n8n创始人提出的一套介于开源与商业软件之间的授权理念。具体到n8n使用的Sustainable Use License与n8n Enterprise License,核心限制在于:任何基于n8n构建并对外提供「工作流自动化即服务」的商业平台,需要获得商业授权;但企业内部自用、修改源码、私有部署均不受限制。这意味着绝大多数使用者——无论是个人开发者还是企业IT团队——在实践中几乎感受不到许可方面的约束。与此形成对比的是,完全采用MIT或Apache 2.0协议的工具(如某些竞品)允许任何人基于其代码构建商业SaaS,代价则是商业主体缺乏可持续的变现动力,长期维护存在隐患。Fair-code模式试图在社区共建与商业可持续之间寻找平衡,理解这一背景有助于评估n8n作为长期基础设施的可靠性。
它适合谁
综合来看,n8n更适合这样几类用户:希望摆脱单一AI厂商依赖、追求方案自主可控的技术团队;需要把AI能力嵌入现有业务流程、且系统众多需要打通的企业;以及既懂一点代码、又不想事事从头造轮子的独立开发者。
它的价值不在于替代某个具体的AI模型,而在于充当连接AI与业务系统的「中枢」。当模型只是流程中一个可替换的节点时,团队对整体架构的掌控力也就随之增强。这或许才是「别再被模型厂商绑死」这句话背后真正的含义。
相关推荐
星辰4.0 29B开源:4B激活参数把Agent安全带进企业内网
国产开源模型星辰4.0 29B采用MoE架构,总参数29B仅激活4B参数,支持私有化部署与国产芯片适配,强化Agent与Coding能力,让企业AI在内网安全落地。
Jev模型爆火:专为Agent设计的极速判断引擎
Jev模型在国内AI圈爆火,搜索热度全球第一。这个专为Agent判断设计的小模型70毫秒出结果、成本便宜几百倍,本文解析其原理、置信度分层策略及四个值得改造的Agent落地场景。
AI没有意图也没有动机:重新理解智能与自主性的边界
Hacker News热议"AI没有意图也没有动机"这一论断。本文剖析大语言模型作为概率预测系统的技术真相,探讨拟人化陷阱、AI安全的正确框架,以及为何清醒认知AI本质对产品设计与公共叙事至关重要。