Next.js缓存升级:Data Cache迁移至Runtime Cache

Vercel 将 Data Cache 正式迁移为 Runtime Cache,代码不变但缓存读写开始按量计费。
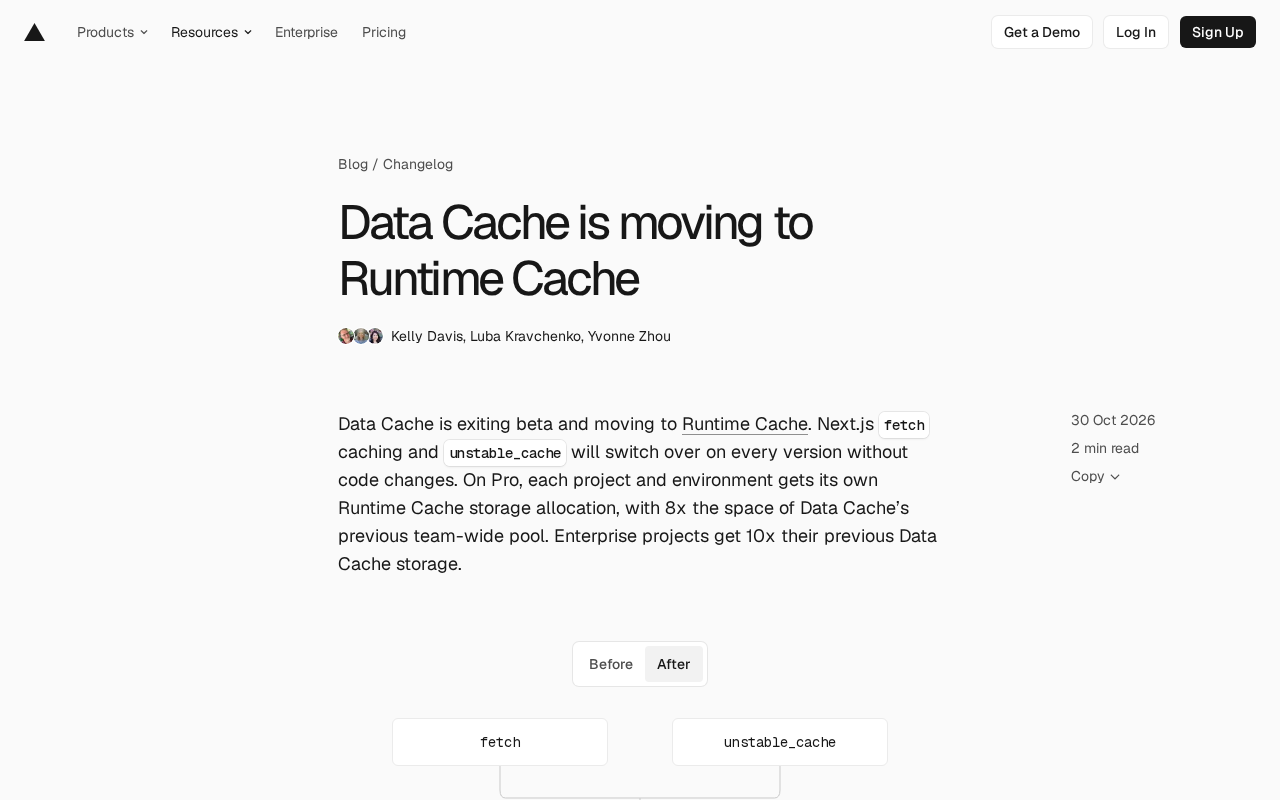
Vercel 宣布 Data Cache 退出 beta 阶段并迁移至 Runtime Cache,Next.js 的 `fetch` 缓存和 `unstable_cache` 在所有版本中自动切换,开发者无需修改代码。真正的变化在于资源与计费:Pro 计划每个项目和环境获得独立存储配额,空间为原团队共享池的 8 倍,Enterprise 为 10 倍;原本免费的缓存读写转为按量计费,读单元每百万 0.40 美元、写单元每百万 4.00 美元,并随区域浮动。Hobby 团队每月有 100 万读单元和 20 万写单元免费额度,Pro 团队从 20 美元基础设施信用额度中扣除。迁移按团队创建时间和计划分批推进,现有 Hobby 和 Pro 团队可从 2026 年 10 月 30 日起提前选择加入。官方建议迁移前用 Observability 审查用量并优化缓存策略。
Vercel 宣布 Data Cache 即将退出 beta 阶段,正式迁移至 Runtime Cache。对于使用 Next.js 的开发者而言,这是一次无需改动代码的底层升级——fetch 缓存和 unstable_cache 会在所有版本中自动切换。但伴随架构调整而来的,是缓存计费方式的根本性变化。
迁移核心:代码不变,存储与计费重构
根据官方公告,迁移后 Next.js 的 fetch 缓存和 unstable_cache 将无缝切换到 Runtime Cache,开发者无需修改任何代码。真正的变化发生在资源分配和计费层面。
此前 Data Cache 采用团队级共享存储池,迁移后 Pro 计划的每个项目和环境将获得独立的 Runtime Cache 存储配额,空间是原团队共享池的 8 倍。Enterprise 项目则获得此前 Data Cache 存储的 10 倍。这一调整意味着缓存资源从“共享池”模式转向“按项目隔离”模式,对于多项目团队而言,资源边界更清晰,但计费颗粒度也更细。
Runtime Cache 与 Data Cache 的关系:Runtime Cache 并非全新独立体系,而是 Vercel 将原本处于 beta 阶段的 Data Cache 正式产品化后的命名。它承载 Next.js 的 fetch 缓存与 unstable_cache 能力,底层仍基于 Vercel 的边缘网络与区域化存储。区别在于,Runtime Cache 引入了按项目和环境隔离的配额模型,并配套独立的仪表盘、计费单元和优化工具。对开发者而言,API 与运行时行为保持一致,变化集中在资源治理与成本可见性上,因此迁移在代码层面是无感的。
计费规则:免费额度与按量付费
迁移后,此前未计费的 Data Cache 读写将按照 Runtime Cache 定价收费。费率起步为每百万读单元 0.40 美元、每百万写单元 4.00 美元,并根据区域有所不同。
Hobby 团队每月在所有项目中获得 100 万读单元和 20 万写单元免费额度。Pro 团队的使用量则从每月 20 美元的基础设施信用额度中扣除,超出部分按区域费率计费。Enterprise 客户需联系客户团队获取定价。
这一变化对高频读写缓存的团队影响较大。官方建议在迁移前通过 Observability 查看项目的 Data Cache 使用情况,并参考优化指南减少不必要的读写。开发者还可以将官方提供的 agent prompt 复制到编码代理中,自动执行优化建议。在 Runtime Cache 仪表盘中,用户也可以选择“Optimize with Vercel Agent”进行智能优化。
读单元与写单元的含义:Vercel 的缓存计费以“读单元”和“写单元”为计量单位,而非直接按请求数或存储字节计费。一次缓存写入通常对应一次 fetch 或 unstable_cache 结果的落盘,读单元则对应缓存命中时的读取操作。读写单价差异(写单元约为读单元的 10 倍)反映了写入在存储与一致性维护上的更高成本。区域费率差异源于不同区域的数据中心与网络资源成本不同,团队可通过 Observability 按区域拆解用量,判断成本主要来自哪些部署区域。
迁移时间线与自主选择权
迁移按团队创建时间和计划类型分批推进:
- 新团队:2026 年 10 月 30 日及之后创建的团队默认使用 Runtime Cache。
- Hobby 团队:已在用 Data Cache 的团队将于 2026 年 11 月 29 日由官方自动迁移。
- Pro 团队:官方将通知迁移日期及计费生效时间。
- Enterprise 团队:客户团队将联系沟通迁移细节。
说个细节,从 2026 年 10 月 30 日起,现有 Hobby 和 Pro 团队可以提前从团队的 CDN 设置中选择加入 Runtime Cache,一旦选择加入,Runtime Cache 定价立即生效。
此外,用户还可以在 CDN 设置中禁用 fetch 和 unstable_cache 缓存。这一操作会将更多请求发送到数据源,但不会阻止迁移进程。
对开发者的实际影响
从技术角度看,这次迁移是 Vercel 缓存架构的一次重要演进。Runtime Cache 提供了更大的存储空间和更细粒度的资源分配,但计费模式从“免费”转向“按量付费”,要求团队更主动地管理缓存策略。
对于缓存读写量大的项目,迁移前进行用量审查和优化至关重要。官方提供的 Observability 工具和优化指南是必要的起点,而 agent prompt 和 Vercel Agent 的引入则降低了优化门槛。对于中小型项目,免费额度可能足够覆盖日常使用;但对于高流量应用,缓存成本将成为需要纳入预算的运维支出项。
总体而言,这次迁移在技术层面是无感的,但在成本和运维层面需要团队提前规划。建议所有使用 Data Cache 的团队在迁移窗口前完成用量评估,并根据自身情况决定是否提前选择加入。
禁用 fetch 与 unstable_cache 缓存的取舍:在 CDN 设置中禁用缓存后,Next.js 的缓存层将不再拦截请求,更多流量会直达数据源。这适合缓存命中率低、数据实时性要求极高或缓存成本高于源站成本的场景。但禁用不会阻止迁移进程,也不会退还已分配的 Runtime Cache 配额,团队仍需按迁移时间线完成切换。对于读写量波动大的项目,更稳妥的做法是保留缓存、通过调整 revalidate 周期和缓存键设计来降低读写频次,而非直接关闭缓存层。
相关推荐

零基础用WorkBuddy做AI漫剧:技能包保姆级安装教程
零基础如何用WorkBuddy制作AI漫剧?本文详解WorkBuddy安装、Skill技能包导入与调用全流程,附剧本生成实操演示与人工修改技巧,帮你跑通AI漫剧从剧本到分镜的第一步。

WorkBuddy智能体一句话跑通GEO数据库挖掘全流程
WorkBuddy智能体实现GEO数据库挖掘全自动化:从数据搜索、下载整理到批次校正、差异分析、共表达网络、特征基因筛选及免疫浸润分析,一句话提示词即可生成完整生信分析报告,大幅降低生信分析门槛。
PC内存被浪费?Hacker News热议集中式数据中心之争
Hacker News用户提出个人电脑内存被浪费、应集中到数据中心的观点,引发关于集中式与分布式计算资源分配的讨论。本文分析该观点背后的逻辑、集中化的代价,以及AI时代内存资源分配的新张力。