NVIDIA Nemotron 3.5 Bolt 74B-A9B 登陆 Ollama:24GB 显存跑本地 VLM

NVIDIA Nemotron 3.5 Bolt 以 MoE 加原生 2-bit 量化把 74B 视觉模型塞进 24GB,登陆 Ollama。
NVIDIA 的 Nemotron 3.5 Bolt 74B-A9B 视觉语言模型正式上线 Ollama,一行命令即可拉取运行。其核心看点不在参数规模,而在于 74B 级多模态模型被压进 24GB 内存:74B 为总参数、A9B 表示推理时仅激活约 9B 参数的 MoE 稀疏架构,配合训练阶段即引入的原生 2-bit 量化,使单张 RTX 4090 或 M 系列 Mac 统一内存即可承载。模型定位为面向截图理解、浏览器操作、桌面自动化等日常 Agentic 任务,并可与其它应用共享内存运行,带来数据不出设备的隐私优势。文章同时提醒,官方未公布基准分数与推理速度,24GB 装得下不等于跑得流畅,实际 Agent 完成度仍待用户实测。
NVIDIA 的 Nemotron 3.5 Bolt 74B-A9B 视觉语言模型(VLM)正式上线 Ollama,官方命令只需一行 ollama run nemotron-3.5-bolt 即可拉取运行。这条消息的核心信息量不在参数规模,而在于一个 74B 参数级的多模态模型被压进了 24GB 内存——这意味着消费级显卡和统一内存设备第一次有了跑本地视觉 Agent 的可行性。
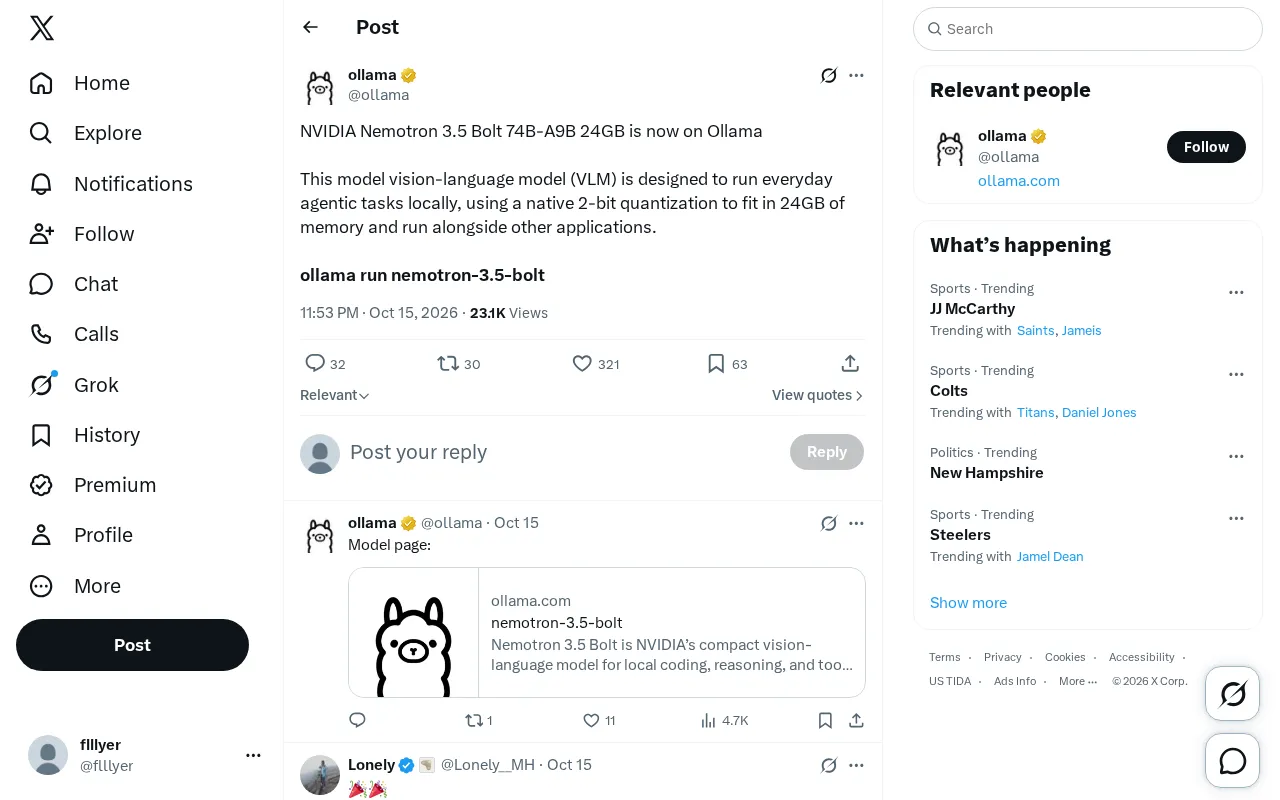
一个 74B 模型如何在 24GB 里跑起来
Nemotron 3.5 Bolt 的命名已经透露了架构取向:74B 是总参数量,A9B 表示推理时激活约 9B 参数——这是典型的 Mixture-of-Experts(MoE)稀疏架构。真正让体积落地的是原生 2-bit 量化(native 2-bit quantization),模型从训练阶段就按低比特精度设计,而非事后压缩。
这个区别值得展开。传统量化是在 FP16 训练完成后做 PTQ 或 QAT,精度损失与位宽往往此消彼长。原生 2-bit 路线把量化约束前移到训练目标里,让权重分布从一开始就适配极低比特表示。NVIDIA 显然把“能在本地跑”当作设计前提,而不是部署阶段的补救措施。24GB 这个数字也很有针对性:单张 RTX 4090 是 24GB,M 系列 Mac 的统一内存起步档位也常落在这个区间。
Mixture-of-Experts(MoE)稀疏架构的核心在于把模型的前馈层拆分成多个并行的"专家"子网络,再由一个路由网络(router)根据每个 token 的表示动态选择激活其中少数几个专家。因此总参数量可以做得很大以提升容量,而单次前向计算只用到被选中的一小部分参数,推理算力与显存带宽开销更接近一个小模型。74B 总参数、9B 激活参数正是这种"大容量、小计算"的典型配比。需要注意的是,MoE 的显存占用仍取决于总参数(所有专家都要驻留),所以稀疏激活本身并不直接降低内存占用——真正把体积压到 24GB 的,是原生 2-bit 量化对全部权重的位宽压缩。
原生 2-bit 量化(native 2-bit quantization,也称量化感知训练前置或 low-bit-native 训练)与常见的训练后量化(PTQ)思路相反:模型在预训练或微调阶段就以 2-bit 权重为目标进行优化,训练过程中通过伪量化算子模拟低比特舍入误差,让网络学会在极低精度下仍保持表达能力。相比先把 FP16 模型训好再压到 2-bit,这种做法通常能显著减小精度损失,但代价是训练流程更复杂、对数值稳定性更敏感。对部署方而言,好处是拿到权重即可直接运行,无需再自行校准或转换。
视觉语言 + Agentic 任务的本地组合
官方描述把使用场景定位在「everyday agentic tasks」(日常智能体任务),并强调模型可以和其他应用共享内存同时运行。这两个限定词决定它的实际价值:视觉输入让 Agent 能读取截图、操作 UI、理解文档版面,而 Agentic 任务意味着模型需要做多步决策而非单轮问答。
把这条线索和 24GB 的门槛放在一起看,指向的应用形态很具体——本地自动化的浏览器操作、桌面应用测试、截图驱动的流程执行。这些场景过去要么依赖云端 API,要么需要远超消费级硬件的显存。本地化带来的不只是成本下降,还有数据不出设备的隐私优势,这对企业内网的 Agent 部署尤其关键。
Agentic 任务与普通对话式推理的区别在于任务闭环:模型需要根据当前观察(如屏幕截图、页面 DOM)决定下一步动作(点击、输入、滚动),调用工具或执行操作后再读取新的观察,如此循环直至目标达成。这对模型提出了多项额外要求——长上下文里保持对目标的记忆、输出结构化且可解析的动作指令、在工具返回失败时具备纠错与重试能力。视觉语言模型在此扮演"感知+决策"的双重角色,把像素级界面理解直接转成动作序列,省去传统 UI 自动化中脆弱的元素定位脚本。也正因如此,多轮工具调用的稳定性、动作格式的可靠性,往往比单轮问答的准确率更能决定这类模型的实际可用性。
Ollama 生态的模型策略变化
从平台角度看,这次上架的信号意义大于单个模型。Ollama 长期以中小参数、易运行的本地模型为主,Nemotron 3.5 Bolt 这类带 MoE + 原生低位宽设计的大模型进入官方库,说明本地推理生态在往「更大的有效能力」方向走。对开发者而言,一行命令即可验证一个 74B 级 VLM 在自己的机器上是否可用,试错成本被压到了最低。
需要冷静看待的是,官方推文没有给出具体的基准分数、每秒 token 生成速度、2-bit 量化后的精度对比数据。参数规模和内存占用是可以确认的事实,但「日常 Agent 任务」的实际完成度仍取决于真实评测。24GB 能装下和 24GB 上跑得流畅是两个问题,长上下文下的显存峰值、多轮工具调用的稳定性都还有待用户实测反馈。
本地多模态 Agent 的临界点
一个 74B 参数、原生 2-bit、带视觉能力的模型放进 24GB,这件事的行业含义在于硬件门槛与模型能力的交叉点正在下移。当消费级设备能承载具备 Agent 执行能力的 VLM,本地优先的 AI 应用设计会获得更大的想象空间。真正的检验标准很简单:拉下来跑一遍,看它在你的实际任务上省下了多少次 API 调用。
相关推荐

M&M's斥资数百万换掉人工蓝色素,为什么这么难?
玛氏公司投入数百万美元,试图用螺旋藻天然色素替代M&M豆中的人工蓝色素,却因物料浓稠堵塞管道、残留物引发霉菌风险而被迫改造整条产线。本文解析这场配方迁移背后的工程难题、消费者与监管推力,以及"无人工色素不等于健康"的清醒判断。

Meta全球AI开发者黑客松组队需求:计算机视觉与医疗AI方向
Reddit开发者发帖为Meta Global AI Developer Hackathon招募队友,方向聚焦计算机视觉与医疗AI。本文分析这一组队信号背后的赛道逻辑、技能互补需求与黑客松选题策略。

Claude 多个模型报错:Fable 5.1、Sonnet 5.5、Haiku 5.5 故障复盘
Claude Fable 5.1、Sonnet 5.5、Haiku 5.5 及 Opus 5.5 fast mode 出现错误率升高,官方 17 分钟内完成定位与恢复。本文梳理故障时间线、多模型连带故障的技术原因,以及对开发者重试与降级策略的实际启示。