NVIDIA携手HuggingFace:开源AI基础设施如何实现普惠
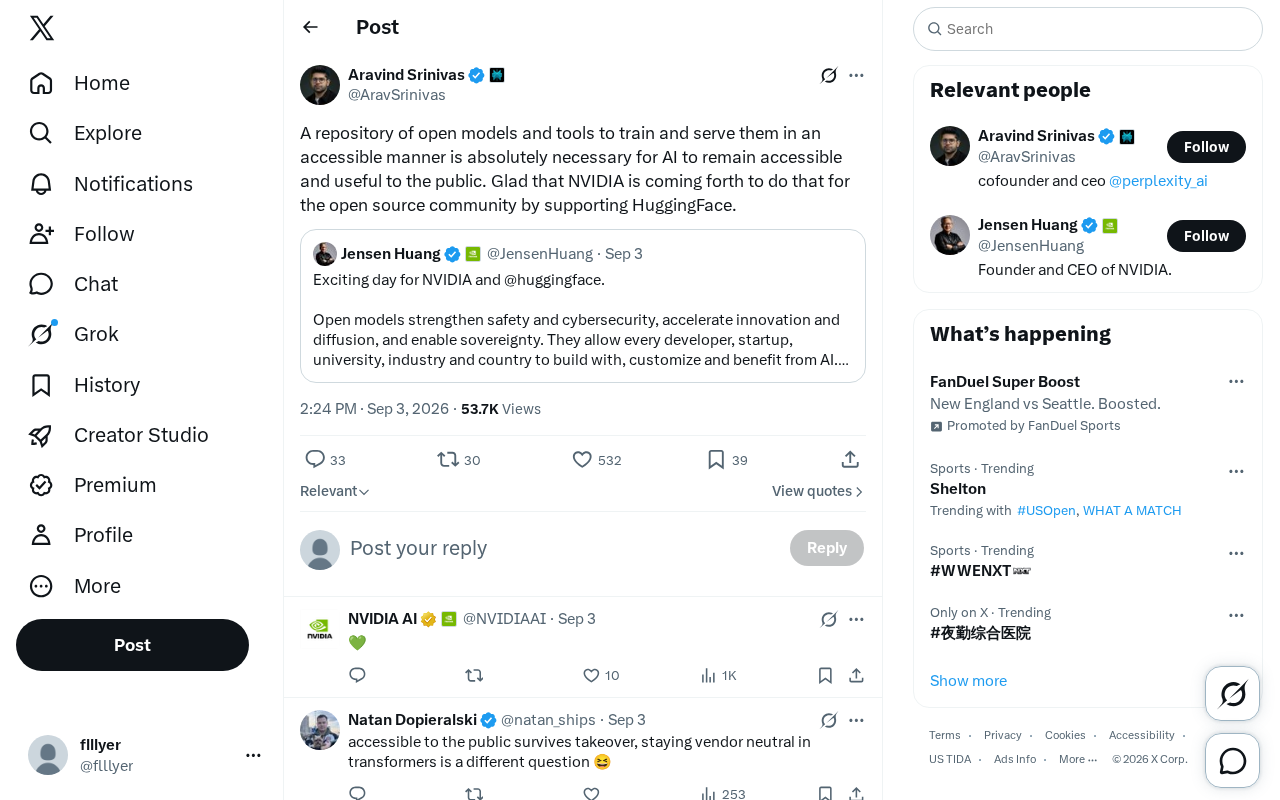
开源模型仓库:AI普惠的基石
人工智能技术高速发展的当下,一个核心问题逐渐凸显:AI能力是否会被少数科技巨头垄断?近期行业讨论指出——包含开源模型及配套训练、部署工具的仓库,是保持AI公众可及性和实用性的关键基础设施。
这一观点直击当前AI生态的痛点。大模型训练成本持续攀升,动辄数百万美元的算力投入让多数研究者、初创企业和学术机构难以企及。当前训练一个前沿大语言模型(如GPT-4级别)的算力成本已达到数千万甚至上亿美元,这些成本主要来自GPU集群的采购或租赁、电力消耗、数据中心冷却以及工程团队的人力投入。以NVIDIA H100 GPU为例,单卡售价约2.5-4万美元,而训练一个千亿参数级别的模型通常需要数千张这样的GPU协同工作数周甚至数月。
除了这些直接的硬件和电力成本外,大模型训练还涉及大量隐性成本。数据收集与清洗通常占据整个项目周期的40%-60%,高质量的训练数据集(如经过人工标注的指令微调数据)成本极高。此外,训练过程中的实验迭代——包括超参数调优、架构探索、失败实验的算力浪费——往往使实际总成本远超单次训练的理论值。Epoch AI研究机构的数据显示,顶级AI模型的训练计算量每6-10个月翻一番,远超摩尔定律的节奏,这意味着算力壁垒正在以加速度扩大。
这种资本密集型的特征正在形成显著的行业准入壁垒,缺乏开源基础设施支撑,AI技术很可能演变为资本与算力的竞赛,将公众排除在外。
NVIDIA支持HuggingFace的战略价值
NVIDIA正通过支持HuggingFace来服务开源社区,这一举动背后有着深层战略考量。
算力与模型生态的深度融合
NVIDIA作为全球AI算力核心供应商,其GPU是训练大模型的事实标准。NVIDIA目前占据AI训练芯片市场约80%-95%的份额,其CUDA(Compute Unified Device Architecture)编程平台自2007年推出以来,已构建起深厚的软件生态护城河——几乎所有主流深度学习框架(PyTorch、TensorFlow等)都以CUDA为首要支持平台。除硬件本身外,NVIDIA还提供TensorRT(推理优化引擎)、Triton Inference Server(模型服务框架)、NeMo(大模型训练框架)等一系列AI软件工具,形成了从芯片到应用的完整技术栈。
HuggingFace则是最重要的开源模型托管与分发平台。这家成立于2016年的公司,截至2024年平台上已托管了超过100万个模型、20万个数据集和30万个演示应用(Spaces),已成为AI领域的"GitHub"。其核心开源库Transformers支持PyTorch、TensorFlow和JAX三大深度学习框架,提供统一的API接口来加载和使用各类预训练模型。此外,HuggingFace还开发了Datasets(数据加载)、Accelerate(分布式训练)、PEFT(参数高效微调)等一系列配套工具,形成了从数据处理到模型部署的完整开源工具链。
HuggingFace的影响力不仅体现在模型托管规模上,其Hub的Git-LFS架构设计使得大文件版本管理成为可能,支持模型权重文件的增量更新和版本回溯。Safetensors格式的推出解决了PyTorch原生pickle格式的安全隐患(pickle反序列化可能执行任意代码)。此外,HuggingFace的Inference Endpoints服务和Text Generation Inference(TGI)引擎正在成为开源模型商业化部署的重要基础设施,后者实现了PagedAttention等前沿推理优化技术的工程化落地。
两者结合,本质上是算力供给方与模型生态方的战略联盟。对开源社区来说,这意味着更流畅的模型训练与部署链路。开发者无需在硬件适配、推理优化等底层环节耗费精力,可以专注模型创新本身。
大幅降低AI应用准入门槛
真正的开源不仅是公开模型权重,更需要完整的工具链——微调框架、量化工具、推理引擎和部署方案。其中,量化(Quantization)是一项至关重要的技术,它将模型参数从高精度浮点数(如FP32或FP16)转换为低精度表示(如INT8、INT4甚至更低),可以大幅减少模型体积和推理所需的计算资源。例如,一个70亿参数的模型在FP16精度下约需14GB显存,经INT4量化后仅需约3.5GB,使其可在消费级GPU上运行。常见的量化方法包括GPTQ、AWQ、GGUF等,HuggingFace平台上已有大量经过量化处理的模型版本。推理优化则涵盖更广泛的技术,包括KV Cache优化、Flash Attention、投机采样(Speculative Decoding)、连续批处理(Continuous Batching)等,这些技术共同作用以提升模型服务的吞吐量和降低延迟。
只有工具足够易用,中小团队才能将开源模型转化为实际生产力。NVIDIA的加入,将在软硬件协同优化层面为工具链注入强劲性能保障,让「以可及的方式训练和部署模型」成为现实。
开源与闭源:AI发展路线之争
这一合作是当前AI行业开源与闭源路线之争的重要注脚。
闭源模式的优势与局限
以OpenAI、Anthropic为代表的闭源阵营,凭借先发优势和巨额投入在模型能力上保持领先。但闭源模式也带来透明度不足、可控性差、成本高昂等问题,企业和研究者对模型「黑箱」的担忧日益加剧。
所谓"黑箱"问题,是指用户无法了解闭源模型的训练数据来源、模型架构细节、安全对齐策略以及潜在偏见等关键信息。这在企业级应用中引发了多层面的担忧:首先是合规风险——在金融、医疗、法律等受监管行业,使用不可解释的AI系统可能违反监管要求;其次是数据隐私——调用闭源API意味着敏感数据需要传输至第三方服务器;第三是供应商锁定——企业的核心业务逻辑与特定闭源API深度绑定后,面临价格调整或服务变更时将极为被动。欧盟《人工智能法案》等新兴监管框架也对AI系统的透明度和可解释性提出了明确要求,这进一步凸显了开源模型在合规层面的优势。
开源力量的快速崛起
Meta的Llama系列、Mistral以及众多HuggingFace社区模型为代表的开源力量正在加速追赶。Meta于2023年2月发布Llama,随后推出Llama 2和Llama 3系列,逐步开放了从7B到405B参数规模的多个版本。Llama系列的开源策略深刻改变了行业格局——它证明了开源模型在性能上可以接近甚至在特定任务上超越闭源竞品。Mistral AI是另一股重要的开源力量,这家法国初创公司推出的Mixtral 8x7B模型采用了混合专家(Mixture of Experts, MoE)架构,以较低的推理成本实现了优异性能。MoE架构的核心思想是将一个大模型拆分为多个"专家"子网络,在推理时只激活其中一部分。例如Mixtral 8x7B虽然总参数量达到约467亿,但每次推理仅激活约130亿参数(2个专家),因此推理成本与一个130亿参数的稠密模型相当,而模型容量则远超同等推理成本的稠密模型。路由机制(Router)负责决定每个输入token应该分配给哪些专家处理,这是MoE架构的关键组件。这种"以大模型的能力、小模型的成本"运行的特性,使MoE成为开源社区追求性价比的重要技术路径。
此外,阿里的Qwen、DeepSeek、01.AI的Yi等中国团队的开源模型也在全球开源生态中扮演着越来越重要的角色。这些模型在HuggingFace上被社区进一步微调、量化和适配,衍生出数以万计的变体版本,形成了繁荣的开源模型生态。
值得注意的是,"开源"在AI领域的定义远比传统软件复杂。Meta的Llama系列采用的是自定义许可证而非标准开源许可证,对月活超过7亿的企业有额外限制。开源促进会(OSI)于2024年正式发布了"开源AI定义",要求同时开放模型权重、训练代码和充分的数据信息。按此标准,许多自称"开源"的模型实际上只是"开放权重"(Open Weight)。这种许可证层面的差异对企业的商业决策有直接影响——采用真正宽松许可证(如Apache 2.0)的模型,在商业化自由度上远优于附带限制条件的模型。
开源模型的核心优势在于透明、可定制、可私有化部署,对注重数据安全和成本控制的企业极具吸引力。当NVIDIA这样的算力核心厂商明确支持开源生态,无疑为开源阵营注入强心剂,也在一定程度上平衡了行业力量格局。
开发者和企业的实际收益
从实践角度看,这一合作可能带来多方面直接价值:
- 训练效率大幅提升:NVIDIA针对HuggingFace生态的深度优化,让模型训练在其GPU上更快更高效。具体而言,这包括对HuggingFace Transformers库的CUDA内核级别优化、针对不同GPU架构(如Hopper、Ada Lovelace)的自动混合精度训练适配,以及分布式训练通信效率的提升
- 部署流程简化:从模型到服务的最后一公里往往最棘手,硬件厂商支持将显著简化这一流程。通过TensorRT与HuggingFace模型的无缝集成,开发者可以一键将训练好的模型转化为高性能推理服务,无需深入理解底层优化细节
- 生态正向循环:更多开源模型和工具的涌现,将形成良性循环,让整个社区受益。当开发者发现在NVIDIA硬件上使用HuggingFace工具链的体验足够流畅,他们会更积极地贡献代码、分享模型和撰写教程,这反过来又吸引更多用户加入,形成网络效应
AI普惠的未来在于开放基础设施
人工智能的未来是走向集中垄断还是开放共享,很大程度上取决于开源基础设施能否持续发展。NVIDIA支持HuggingFace的举动,虽然具体成效仍需时间验证,但至少传递了积极信号:AI的公共可及性正在被行业头部玩家重视。
值得注意的是,这种"开放"并非没有边界和张力。NVIDIA的CUDA生态本身具有高度锁定效应,其对开源社区的支持在推动AI普惠的同时,也在巩固自身在AI基础设施中不可替代的地位。CUDA的锁定效应根植于十余年的生态积累——超过400万注册开发者、数以万计的优化库和学术论文中的CUDA代码。AMD的ROCm虽然在技术上正在缩小差距(其MI300X芯片在部分基准测试中已接近H100),但软件生态的兼容性和稳定性仍是痛点。Intel的oneAPI以及各类AI专用芯片(如Google TPU、各类国产AI芯片)都在尝试打破这一垄断,但目前软件生态的成熟度仍有明显差距。
与此同时,一些新兴项目正在从另一个维度推动AI的去中心化。PyTorch 2.0引入的torch.compile和Triton编译器在一定程度上提供了硬件抽象层,有望降低对特定硬件平台的依赖。此外,GGML/llama.cpp等项目通过纯CPU推理和Apple Metal支持,为消费级设备上的模型部署开辟了CUDA之外的路径——用户甚至可以在笔记本电脑和手机上运行经过量化的大语言模型,这也是AI普惠的重要补充力量。
真正的AI普惠,或许不仅需要模型层面的开源,还需要算力基础设施层面更充分的竞争与开放。对广大开发者和企业而言,一个健康、开放、工具完备的模型生态,才是让AI技术真正落地、服务大众的根本保障。这场关于AI普惠的较量,才刚刚拉开序幕。
核心要点
核心要点
相关推荐

LynnReal-Omni:32B统一视频扩散模型开源,四步生成多任务全覆盖
LynnReal-Omni 是基于 MiniMax H3 架构的 32B 统一视频扩散模型,支持文生视频、图生视频、姿态引导、视频修复等多任务,四步快速生成,Flash 版单张 H100 上 377ms 完成 540p 视频,权重与 ComfyUI 节点已开源。

Anthropic联合创始人:AI"紧急停止开关"或应强制立法
Anthropic联合创始人向BBC表示,AI系统的"紧急停止开关"(kill switch)可能需要通过法律强制推行。本文分析这一呼吁背后的产业逻辑、技术挑战以及监管与创新之间的张力。

AI数据中心建设热潮,正冲击工业创伤深重的城市
AI数据中心建设热潮正与曾受重工业创伤的城市社区激烈碰撞。以费城为例,全国性反对声浪聚焦能耗、水资源与环境公平问题,揭示AI增长与地方利益的结构性冲突。