OctLLM:用八叉树让大模型看懂3D几何结构

OctLLM用八叉树显式序列承载3D几何,并以独立参数分支引入3D能力,实现多模态扩展而不损原有语言能力。
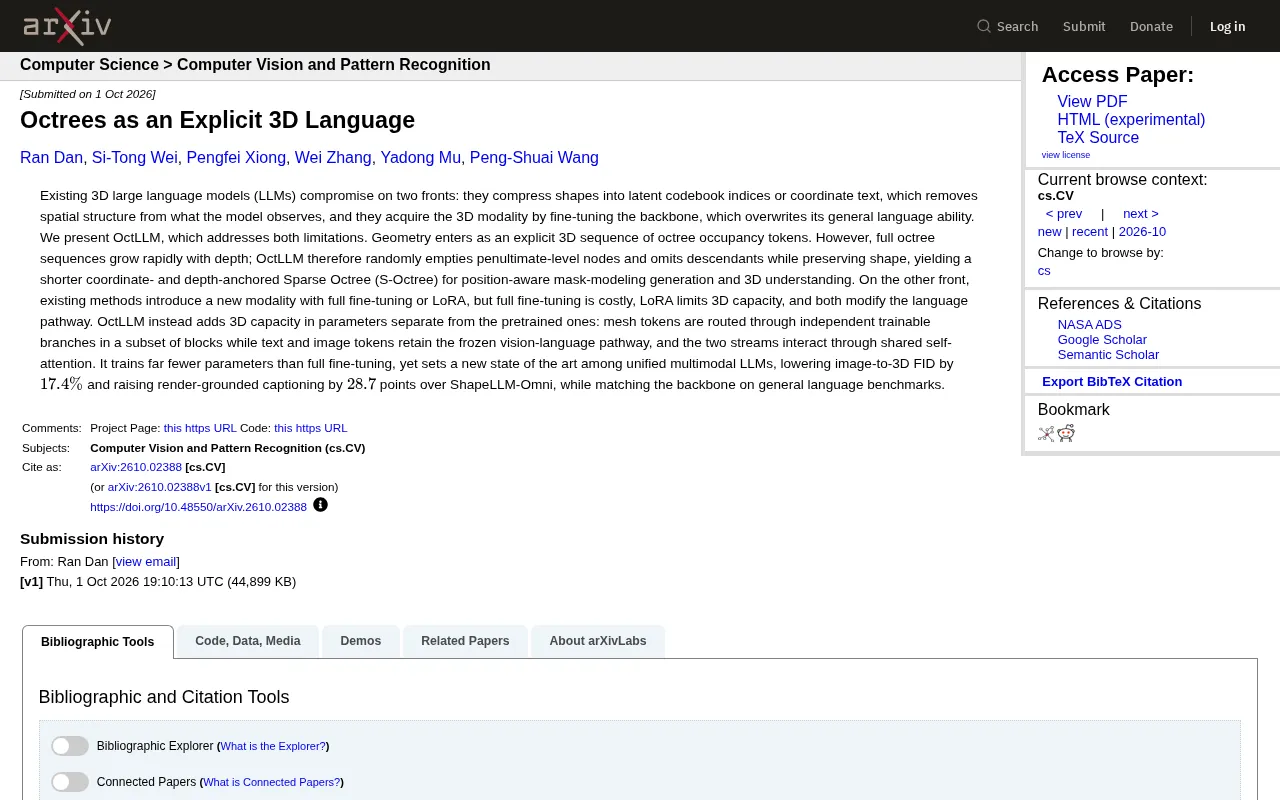
现有3D大语言模型面临两个结构性缺陷:几何信息被压缩成失去空间结构的码本索引,以及微调过程破坏原有语言能力。OctLLM针对这两点提出系统性解法:一是用显式的稀疏八叉树(S-Octree)占用令牌序列承载几何,通过随机清空倒数第二层节点控制序列长度,同时保留坐标和深度锚点;二是将3D能力引入与预训练权重完全独立的可训练参数分支,文本和图像令牌流经冻结的原始通路,两路数据仅通过共享自注意力交互。实验显示,相比ShapeLLM-Omni,OctLLM在图像生成3D的FID上降低17.4%,渲染描述分数提升28.7分,且通用语言基准与原主干持平,验证了"扩展新模态无需牺牲旧能力"的可行性。
3D大模型的两难困境
当下的3D大语言模型(3D LLM)普遍面临两个结构性妥协。一方面,它们往往把三维形状压缩成潜在码本索引(latent codebook indices)或坐标文本,这种做法会抹掉模型实际观察到的空间结构——换句话说,模型拿到的不再是真正的几何信息,而是一串失去空间关系的符号。另一方面,为了让模型获得3D这一新模态,常规做法是对主干网络进行微调(fine-tuning),但这往往会覆盖掉模型原有的通用语言能力,形成"学会了3D,忘了说话"的尴尬局面。
arXiv最新论文《Octrees as an Explicit 3D Language》提出的 OctLLM,正是针对这两处痛点给出的解法。它的核心思路可以概括为两点:用显式的八叉树(octree)序列替代被压缩的隐式表示,并通过独立参数分支引入3D能力,从而不破坏预训练的语言通路。
把几何变成显式的3D语言序列
OctLLM 的第一个关键设计,是让几何信息以显式的八叉树占用令牌(occupancy tokens)序列进入模型。八叉树是一种经典的三维空间划分结构,它天然保留了形状的空间层次关系,而不是像码本索引那样把空间结构"打平"。
问题在于,完整的八叉树序列会随着深度增加而迅速膨胀,令牌数量过多会严重拖累计算效率。OctLLM 为此设计了稀疏八叉树(Sparse Octree, S-Octree):它随机清空倒数第二层(penultimate-level)的节点并省略其后代,但在整体上保留形状轮廓。这样得到的是一个更短、同时带有坐标和深度锚定(coordinate- and depth-anchored)的序列。
这种稀疏化处理不是简单的降采样,而是服务于后续的位置感知掩码建模(position-aware mask-modeling)——既支持生成任务,也支持3D理解任务。保留坐标与深度信息,意味着模型在生成和理解时都"知道"每个令牌对应的空间位置,这正是显式表示相较隐式压缩的优势所在。
八叉树(Octree)是一种将三维空间递归细分的树状数据结构:每个节点将当前空间均分为8个子空间,被物体占据的子空间继续细分,空白子空间则停止。这一过程持续到预设的最大深度为止。相比均匀体素网格,八叉树能以指数级更少的节点数表达同等精度的几何信息,因为它只在形状边界附近进行密集划分。将八叉树序列化为令牌序列时,每个节点可以携带其在空间中的绝对坐标、所处深度以及占用状态(occupied/empty),这三类信息共同构成了模型理解"该令牌对应空间哪里"的锚点。与之对比,码本索引(codebook indices)是将连续几何特征量化后的离散编号,本质上是一种有损压缩,索引之间不携带任何空间邻近或层级关系,模型必须完全依赖码本解码器才能还原几何含义,空间关系的感知因此退化为隐式的统计关联。
独立参数分支:加3D能力而不动语言通路
OctLLM 的第二个创新针对模态引入方式。现有方法通常走两条路:全量微调(full fine-tuning)或 LoRA。前者成本高昂,后者限制了3D容量,而且两者都会修改语言通路本身,从而损害通用语言能力。
OctLLM 的做法是把3D能力放进与预训练参数相互独立的新参数里。具体来说,网格令牌(mesh tokens)会被路由到部分 Transformer 块中独立的可训练分支,而文本和图像令牌则保留在冻结的视觉-语言通路中。两条数据流通过共享的自注意力(shared self-attention)机制交互。
这种"分流+共享注意力"的架构有几个直接好处:训练参数远少于全量微调,降低了成本;语言和图像能力因为通路被冻结而得以完整保留;同时3D令牌通过独立分支获得了足够的建模容量,不受 LoRA 那样的低秩约束。可以说,它在参数效率、能力保留与3D表达力之间找到了一个较优的平衡点。
LoRA(Low-Rank Adaptation)是当前最主流的参数高效微调方法:它在预训练权重矩阵旁并联一个低秩矩阵分解(W = W₀ + BA,其中B和A的秩r远小于原矩阵维度),只训练这对低秩矩阵,从而以极少参数近似全量微调的效果。然而低秩假设本身是一种容量上限:当新模态(如3D几何)所需的特征变换不能被低秩矩阵有效捕捉时,模型的3D表达力就会受到硬性限制。更关键的是,LoRA的低秩矩阵仍然作用于原始权重矩阵,意味着它与语言通路共享同一参数空间,并非真正解耦。OctLLM的独立分支设计则从根本上规避了这一约束:3D令牌流经专属的可训练参数,参数规模不受低秩限制,同时原始语言-视觉权重完全冻结,两条数据流仅在自注意力阶段通过共享的注意力核进行信息交换。
实验表现:刷新统一多模态LLM的SOTA
论文给出的实验结果颇具说服力。在统一多模态大模型的范畴内,OctLLM 以明显更少的训练参数达到了新的最优水平(state of the art)。
与此前的 ShapeLLM-Omni 相比,OctLLM 将图像生成3D的 FID 指标降低了 17.4%(FID 越低表示生成质量越好),并把基于渲染的图像描述(render-grounded captioning)提升了 28.7 分。更重要的是,它在通用语言基准上与原始主干模型持平——这意味着引入3D模态没有以牺牲语言能力为代价,直接验证了独立参数分支设计的有效性。
这组数据背后传递的信号是:3D多模态能力的加入,不必是一场"零和游戏"。通过显式几何表示与参数解耦,模型可以在不退化既有能力的前提下扩展新模态。
FID(Fréchet Inception Distance,弗雷歇起始距离)是评估图像生成质量的标准指标,由Heusel等人于2017年提出。其计算方式是:将真实图像和生成图像分别通过预训练的Inception网络提取深层特征,然后将两组特征的分布分别拟合为多元高斯分布,计算两个高斯分布之间的弗雷歇距离。FID越低,表示生成图像在特征空间中的分布与真实图像越接近,即生成质量越高、多样性越好。在3D生成评估中,通常将生成的三维模型渲染为多视角图像,再对这些渲染图计算FID,以此间接衡量3D生成的视觉保真度。OctLLM将FID降低17.4%意味着其生成的3D模型在渲染后,与真实参考图像的分布差异显著缩小,体现了八叉树显式表示在保留几何细节方面的优势。
对3D多模态方向的启发
OctLLM 的价值不仅在于指标,更在于它重新审视了3D LLM 的两个基础假设。其一,几何信息应当以保留空间结构的显式形式进入模型,而非被压缩成失去结构的符号;其二,引入新模态不应以修改和覆盖原有通路为代价。
从方法论角度看,八叉树作为"显式3D语言"的思路,为如何在序列化框架下承载三维结构提供了一个可借鉴的范式。而稀疏化策略则回答了一个现实问题——如何在保留空间信息的同时控制序列长度。参数解耦的设计,也呼应了近年来多模态领域对"能力不互相干扰"的持续探索。
当然,作为一篇新发布的预印本,OctLLM 的实际泛化能力、在更大规模数据和更复杂3D任务上的表现,仍有待后续工作和社区复现来检验。但它所指出的方向,对正在构建统一多模态系统的研究者而言,无疑具有参考意义。
相关推荐
触屏MacBook与混乱的苹果:一场刻意为之的冒险
The Vergecast 深入讨论触屏 MacBook Pro 的发布逻辑、ProLed 命名争议、iPad 被 iPhone 与 Mac 两头挤压的困境,以及苹果在 AI 时代如何靠高端硬件维持竞争力。

研究权力50年:Robert Caro的写作与权力洞察
Robert Caro研究权力50年,在访谈中谈Lyndon Johnson的说服力与杠杆、Robert Moses从理想主义到冷酷的变迁、大规模建设的困境,以及传记写作中压缩主题与孤独专注的方法。

2万美元的机器人能替你干家务吗?实测结果令人意外
一段YouTube实测视频展示2万美元机器人如何响应洗碗、关灯、倒垃圾、喂狗等指令。本文分析其真实能力边界、语音交互技术现状,以及家务机器人距离普及还有多远。