Ollama v0.40.0发布:Apple Silicon默认启用MLX运行时

Ollama v0.40.0 在 Apple Silicon 上默认启用 MLX 运行时,Mac 用户无需配置即可获得原生加速推理体验。
Ollama 发布 v0.40.0 预发布版本,核心变化是在搭载 Apple Silicon 的设备上,将 MLX 设为支持架构模型的默认推理运行时。MLX 是 Apple 专为 M 系列芯片统一内存架构设计的机器学习框架,能更充分地调度 CPU、GPU 和神经引擎资源,在内存利用率和推理吞吐上优于通用后端。此次更新意味着 Mac 用户无需额外配置,即可自动获得针对苹果芯片深度优化的推理性能,Qwen3 等主流模型已在支持范围之内。由于该版本仍处于预发布阶段,Ollama 采用渐进式策略,逐步扩展 MLX 支持的模型架构列表,以在性能提升与稳定性之间取得平衡。
Ollama 作为目前最流行的本地大模型运行工具之一,在 GitHub 上已积累超过 18.2 万 Star。其最新的 v0.40.0 预发布版本(Pre-release)带来了一项针对 Apple 设备的重要改进:在 Apple Silicon 芯片上,默认启用 MLX 运行时来执行模型推理。
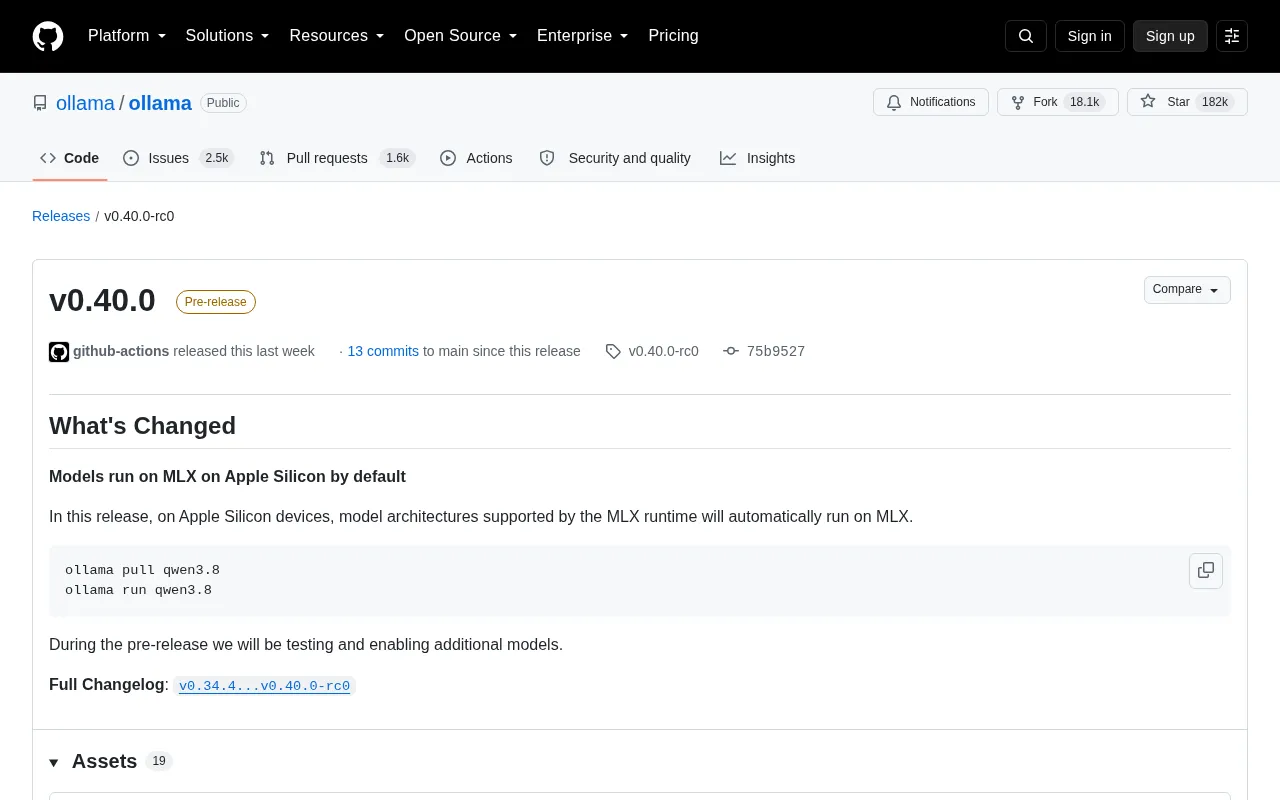
MLX 成为 Apple Silicon 默认运行时
这次更新的核心变化是:在搭载 Apple Silicon 的设备上,凡是 MLX 运行时支持的模型架构,将自动切换到 MLX 上运行。对于 Mac 用户来说,这意味着无需额外配置,即可享受到针对苹果芯片深度优化的推理性能。
MLX 是 Apple 推出的机器学习框架,专为 Apple Silicon 的统一内存架构设计。相比通用的推理后端,它能更充分地调度 M 系列芯片的 CPU、GPU 和神经引擎资源,在内存利用率和推理吞吐上通常有更好的表现。Ollama 将其设为默认,反映出团队对 Mac 平台作为本地推理重要场景的重视。
官方给出的使用示例非常简洁,用户通过熟悉的命令即可拉取并运行模型:
ollama pull qwen3.8
ollama run qwen3.8
从示例可以看出,Qwen3 系列等主流模型已经在支持范围之内。
Apple Silicon 的统一内存架构(Unified Memory Architecture,UMA)是理解 MLX 优势的关键背景。传统 PC 中,CPU 和 GPU 拥有各自独立的内存池,数据在两者之间传输会产生带宽瓶颈和延迟。而 M 系列芯片将 CPU、GPU、神经引擎(Neural Engine)和内存集成在同一封装内,所有计算单元共享同一块高速内存,数据无需跨总线复制即可被不同计算单元直接访问。这对大模型推理意义重大:模型权重只需加载一次,即可在 CPU 和 GPU 之间无缝共享,内存带宽可以得到充分利用而不被复制开销消耗。MLX 框架正是围绕这一架构特性从底层设计,能够智能地在不同计算单元间调度张量运算,而通用推理后端(如基于 CUDA 思路移植的方案)通常无法充分发挥这一架构红利。
预发布阶段的渐进式推进
值得关注的是,v0.40.0 目前标记为 Pre-release(预发布)版本。Ollama 官方明确表示,将在预发布阶段持续测试,并逐步启用更多模型对 MLX 运行时的支持。
这种渐进式的策略较为稳妥。不同模型架构对运行时的适配程度各异,默认切换运行后端如果处理不当,可能导致部分模型出现兼容性或精度问题。通过预发布阶段先覆盖已验证的架构,再逐步扩展支持列表,可以在性能提升与稳定性之间取得平衡。
对于普通用户而言,这也意味着在正式稳定版发布前,如果遇到某些模型尚未走 MLX 路径,属于预期之内的过渡状态,可以继续关注后续版本的更新说明。
推理后端的兼容性挑战主要源于模型架构的多样性。不同的模型在注意力机制、激活函数、归一化方式上存在差异(例如 GQA 分组查询注意力、RoPE 旋转位置编码、SwiGLU 激活等),每种变体都需要运行时框架提供对应的算子实现。MLX 的算子库目前仍在持续完善中,对于某些较新或非主流的架构,可能尚未提供经过充分验证的实现。若强行在不支持的架构上使用 MLX,轻则性能下降(回退到低效路径),重则出现数值精度偏差,导致模型输出质量异常。因此 Ollama 采用架构白名单的方式,只对已验证的模型架构自动启用 MLX,其余架构继续沿用原有的 llama.cpp 后端,这是在新特性引入时保障用户体验稳定性的常见工程策略。
对本地推理生态的意义
本地大模型运行正在成为越来越多开发者和个人用户的选择,既出于数据隐私考量,也因为无需支付云端 API 费用。Ollama 凭借其简洁的命令行体验和广泛的模型支持,在这一领域占据了重要位置。
此次将 MLX 设为 Apple Silicon 默认运行时,进一步降低了 Mac 用户获得高性能本地推理的门槛。过去,想在 Mac 上充分利用 MLX 往往需要使用专门的工具链或手动配置,如今这一能力被整合进了 Ollama 的默认行为中。
从社区反馈来看,这次发布获得了积极响应——发布页面收获了大量点赞、庆祝和火箭表情,共有 28 人参与互动。这从侧面说明 Mac 用户对原生性能优化的期待一直存在。
小结
Ollama v0.40.0 是一次聚焦平台优化的版本更新,核心亮点在于让 Apple Silicon 用户默认获得 MLX 加速的推理体验。作为预发布版本,它仍在完善对更多模型架构的支持。对于使用 Mac 进行本地 AI 实验和开发的用户,这无疑是一个值得升级尝试的方向,建议结合官方 Changelog 跟进支持模型的范围变化。
相关推荐

Claude国内使用与充值全攻略:三种方式对比及防封控指南
整理Claude国内使用与会员充值的三种方式:海外信用卡直充、苹果美区ID与安卓Google Play内购、网站自助充值,对比各自门槛、成本与封控风险,并给出固定设备、稳定IP、不共享账号等五条降低封号概率的使用习惯。

从ChatGPT内容限制到Eval、可观测性与Guardrail实战
通过电子商店订单Agent实战,讲解ChatGPT内容限制背后的工程逻辑,以及Eval评估、Observability可观测性和Guardrail护栏如何协作,避免同名用户数据泄露与提示注入风险。

LangChain4j决策模型:本地校验Java工具调用
LangChain4j社区提出决策模型方案,在本地对Java工具调用进行校验,将控制逻辑从LLM拉回应用侧,提升工具调用的可靠性与可调试性。