Ollama v0.40.5 发布:同步升级 llama.cpp 至 b11669
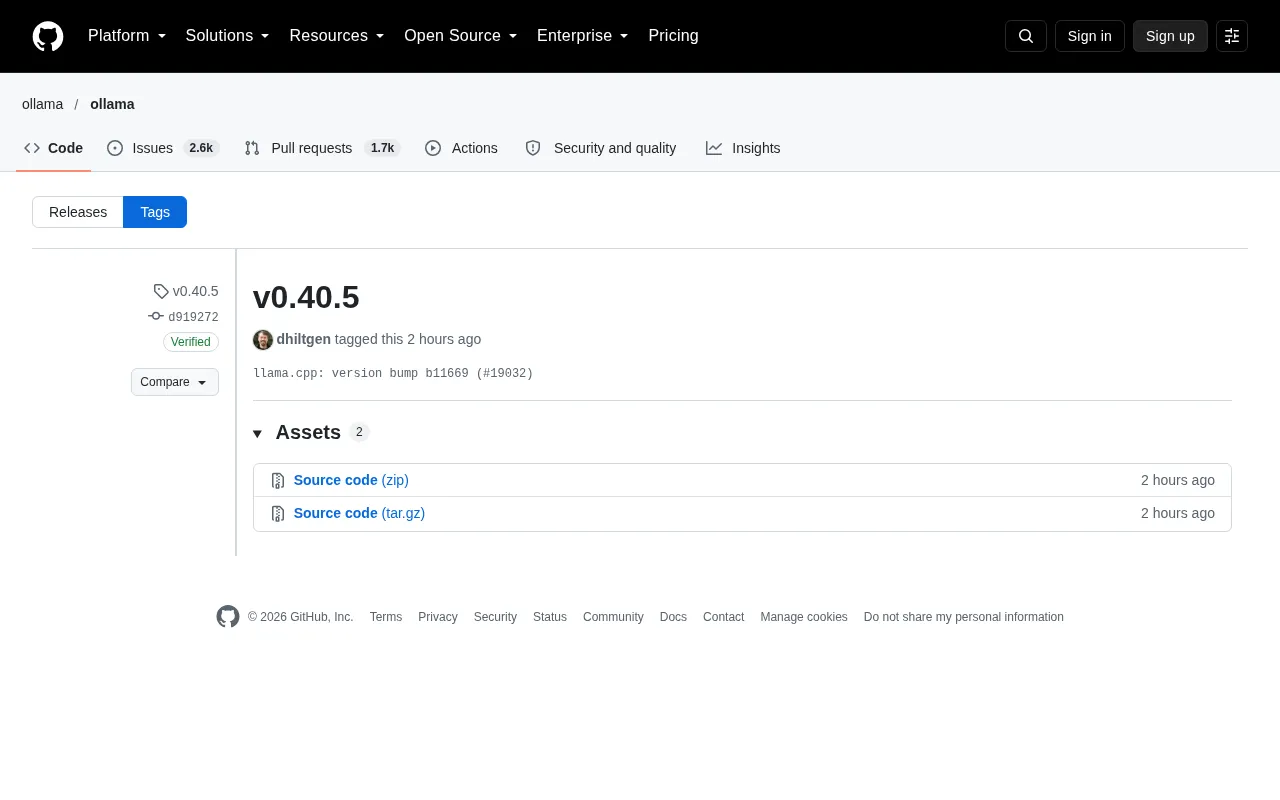
Ollama v0.40.5 发布,唯一实质变更是将推理引擎 llama.cpp 升级至 b11669。
Ollama 发布 v0.40.5,这是一次维护性小版本更新,核心内容是把内置的推理引擎 llama.cpp 从旧版本同步到 b11669,对应 commit d919272 与 PR #19032,由维护者 dhiltgen 于 10 月 15 日打标签。文章解释了 Ollama 并不自行实现推理,而是依赖 llama.cpp 提供底层能力,因此通过定期跟随上游构建来获得性能修复、新模型支持与推理行为改进。这类升级通常不影响 API 接口,但可能改变推理速度、显存占用、量化支持、模型兼容性与采样输出稳定性,因此生产环境升级前建议先做验证。获取方式与以往一致,Release 页面提供两个平台安装包,macOS/Windows、Linux 与 Docker 用户均可按常规路径升级。
Ollama 发布了 v0.40.5 版本,这是一次小版本迭代,核心改动是同步上游推理引擎 llama.cpp 的版本。
版本号背后的更新逻辑
根据 GitHub 提交记录,v0.40.5 对应的 commit 为 d919272,由维护者 dhiltgen 于 10 月 15 日 16:11 打上标签。提交说明只有一行:llama.cpp: version bump b11669 (#19032)。
这意味着本次发布的唯一实质性变更是把内置的 llama.cpp 从旧版本升级到 b11669。Ollama 并不自己实现模型推理,而是把 llama.cpp 作为底层引擎,通过定期跟随上游 commit 来获得性能修复、新模型支持和推理行为的改进。
语义化版本(SemVer)通常约定“主版本号.次版本号.修订号”的结构,分别对应不兼容变更、向后兼容的新功能和向后兼容的缺陷修复。Ollama 的版本号大致遵循这一约定,但它的“修订”往往不是自己代码的修复,而是把上游 llama.cpp 的累积改动打包进来,因此版本号的递增更多表示同步节奏而非功能语义。这类做法在依赖快速演进上游的项目中十分常见,好处是用户能通过简单的版本判断大致了解新旧程度,代价是单看版本号无法直接判断是否引入了影响自身用例的推理行为变化。
为什么 llama.cpp 版本同步值得关注
llama.cpp 是当前本地大模型推理生态中最活跃的项目之一,它的更新节奏非常快。Ollama 选择以版本号递增的方式打包这些上游变更,让用户可以用一次 ollama pull 或升级安装包就拿到最新的推理能力。
对使用者来说,这类版本号跳跃通常不会带来接口层面的破坏性变化,但可能影响以下几个方面:
- 推理速度与显存占用:llama.cpp 的算子优化、量化格式支持会随版本演进而调整
- 模型兼容性:新版本往往加入对新架构(如新的 MoE 或注意力变体)的支持
- 输出稳定性:采样逻辑的细微修正可能改变同一 prompt 下的生成结果
如果你在生产环境中依赖固定的输出行为,升级前建议在测试环境验证关键 prompt 的表现。
llama.cpp 最初由 Georgi Gerganov 于 2023 年 3 月发起,目标是用纯 C/C++ 实现 Meta LLaMA 模型的高效推理,并借助 ggml 张量库在消费级硬件(CPU、Apple Silicon、普通 GPU)上跑动大模型。它最广为人知的贡献是 GGUF 模型格式与配套的量化方案(如 Q4_K_M、Q5_K_M、Q8_0 等),把原本需要数十 GB 显存的模型压缩到单机可运行的体积,同时尽量维持输出质量。由于社区贡献者众多、合并频繁,llama.cpp 每天可能产生多个构建(build)编号,例如文中提到的 b11669,就是按构建序号排列的版本标识。正因迭代如此密集,下游项目若想持续获得新模型架构支持和新硬件优化,就必须定期跟进这些上游构建,而不是只在重大版本发布时同步。
如何获取这个版本
GitHub Release 页面提供了 2 个 asset(对应不同平台的安装包),这是 Ollama 一贯的发布结构。升级方式与往常一致:
- macOS / Windows 用户可直接下载安装包覆盖安装
- Linux 用户可通过官方安装脚本或包管理器更新
- Docker 用户可以拉取对应 tag 的镜像
说个细节,页面上的 "Compare" 和 tag 筛选区域出现了加载错误提示,这是 GitHub 前端在渲染大量 tag 时的常见现象,不影响实际下载。
Docker 用户可参考官方在 Docker Hub 上维护的 ollama/ollama 镜像,它同时提供 latest 和带版本号(如 0.40.5)的 tag,生产环境建议固定版本 tag 以避免自动升级带来的行为变化。使用 docker run 时通常需要挂载模型存储卷(如 -v ollama:/root/.ollama),否则容器重启后已拉取的模型会丢失。若容器内需要访问宿主机 GPU,还需配合 --gpus=all 并安装 NVIDIA Container Toolkit。对于 Kubernetes 或其它编排环境,社区也有对应的 Helm Chart 与 Operator 可供参考,但都建立在同一镜像之上。
小结
v0.40.5 是一个典型的维护性更新:没有新功能公告,没有 API 变化,价值全部来自 llama.cpp 上游的累积改进。对于关注本地推理性能的用户,跟随 Ollama 的小版本升级是低成本保持引擎最新的方式;对于追求稳定的部署场景,则可以等社区反馈后再决定是否跟进。
相关推荐
Mistral Large 4开源万亿参数,微软6万员工自愿离职
Mistral Large 4 开源万亿参数多模态模型,编码智能体评测得分 48;闪迪财报显示 AI 推理重塑 NAND 需求;谷歌 Gemini 上线应用内文件编辑,OpenAI 上调 Codex 额度,微软向 6 万员工提供自愿离职方案。
Mistral Large 4开放权重,AI早报盘点模型与生态新动向
Mistral Large 4开放权重,1万亿参数MoE架构支持MacStudio本地运行;Meta测试生成技术进入生产环境;税务基准测试头名通过率仅10.8%;加拿大政府入股Cohere;豆包工作开放第三方模型调用。本期AI早报盘点模型、生态、资本与政策动向。

Mistral Large 4开源:1T参数欧洲版千问挑战DeepSeek
Mistral Large 4正式开源,1T总参数、52B激活参数,主打编程与网络安全,NVFP4量化版本权重约610G。本文解析其与DeepSeek V4 Flash的对比、API定价、Demo真实性与本地部署价值。