OpenAI Agents API 公测上手:托管沙箱、Artifacts 与 Skills 实测
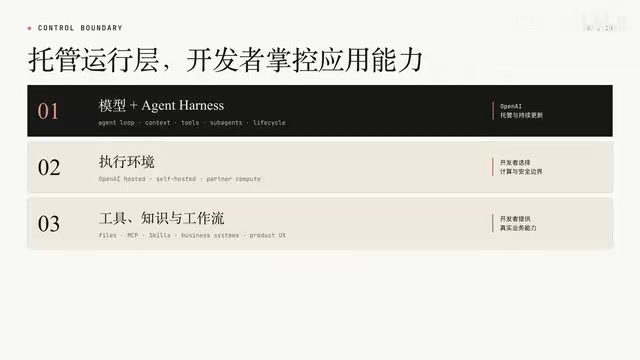
OpenAI Agents API 将 Codex 背后的 Agent 运行层开放给开发者,支持托管沙箱与自有环境的灵活组合。
OpenAI 公测版 Agents API 将此前驱动 Codex 的 Agent Harness 作为托管运行层对外开放,开发者可通过 `/v1/agents/sessions` 接口提交任务,由 OpenAI 服务端管理完整的 Agent Loop,包括工具调用、上下文压缩、SubAgent 协调等。执行环境可自由选择:OpenAI 托管沙箱、自有 VPC 或第三方计算资源,工具与业务能力仍由开发者自主提供。API 采用 Session / Turn / Items 三层结构支持长任务的可观测与可恢复,任务产物以 Artifact 形式通过专用接口下载。通过上传打包为 zip 的 Skill 文件,开发者可为同一任务注入可复用的方法规范,实测证明 Skill 确实被 Agent 读取并影响了最终输出结构,同时生成了 JSON 与 Markdown 两种格式报告。
OpenAI 近期发布了处于公开测试阶段的 Agents API,把此前藏在 Codex 背后的 Agent Harness、Session、托管沙箱、文件处理和 Skills 等能力通过 API 开放给开发者。B站UP主小木头对这套 API 进行了首次上手实测,用两个真实请求验证了它的完整工作流程。本文基于其演示内容,梳理 Agents API 的架构设计与实际用法。
Agents API 到底提供了什么
与以往一次性生成文本的模型调用不同,Agents API 面向的是「需要持续推进的任务」。开发者提交自己的目标和运行配置,Agent 就可以在一个 Session 中调用工具、运行命令、处理文件、生成数据(这些产物被称为 Artifact),并把整个工作过程持续返回给应用。
这套 API 最核心的价值在于:OpenAI 把 Codex 背后的 Agent Harness 作为托管能力开放了出来。Harness 可以理解为模型之外的 Agent 运行层,它负责组织模型调用与工具调用,把工具结果送回模型,管理长任务中的上下文,在需要时压缩历史,协调 SubAgent,并维护 Session 从创建、执行、等待到继续的整个生命周期。
模型负责判断下一步做什么,Harness 负责让这个判断连续地变成行动——发起工具调用、记录结果、更新上下文、处理失败,再进入下一轮。这些环节共同构成了一个 Agent Loop,而 OpenAI 在服务端运行并维护这一层。
Agent Loop 是 Agent 系统运行的核心机制,其基本模式为:模型接收当前上下文 → 决策下一步行动(调用工具或输出结果)→ 工具执行并返回结果 → 结果写入上下文 → 进入下一轮决策。这个循环在任务完成前持续运行。早期开发者需要自己实现这一循环,包括错误重试、上下文长度管理、SubAgent 协调等复杂逻辑。OpenAI 将这套通用逻辑托管化,意味着开发者不再需要从零搭建 Agent 框架,而是直接在其之上定义任务目标和能力边界。
MCP(Model Context Protocol) 是 Anthropic 提出、逐渐成为行业标准的工具调用协议,定义了模型如何发现并调用外部工具或服务。Agents API 支持通过 MCP 服务扩展 Agent 的工具集,开发者可以把自己的内部系统包装成 MCP 服务后挂载进来,而无需修改 Harness 本身。
托管 Harness,但执行环境仍归开发者
Agents API 的分工设计值得关注:OpenAI 托管的是通用的运行层,而执行任务的环境仍然由开发者自行选择。
最直接的方式是使用 OpenAI 托管的 Hosted Sandbox,由官方负责创建和连接 Linux 工作区,开发者只需配置网络权限、环境变量、依赖包和文件,适合快速启动。任务也可以运行在开发者自己的基础设施里,连接企业 VPC、自定义镜像、内部数据、密钥系统和特殊硬件资源;还可以选择第三方合作伙伴提供的计算环境,根据 CPU/GPU、内存、地理区域和价格做取舍。
工具、MCP 服务、业务知识和工作流则继续由开发者提供——他们决定 Agent 能访问哪些系统、遵守什么规则、以及最终怎样进入真实产品。这种分工带来的直接变化是:开发团队可以减少维护通用 Agent Loop 的工作,把更多精力放在任务设计、权限安全和业务能力上。换句话说,Agents API 提供的是一套可组合的 Agent 基础设施。
第一个请求:文件进入工作区并生成 Artifact
Agents API 的入口是 /v1/agents/sessions。请求头需要包含 API Key、OpenAI-Beta: agents=v1 标记以及 application/json 内容类型,请求体里指定模型、执行环境、输入文件、任务指令,并开启流式返回。
在演示中,小木头选择了 OpenAI Hosted 沙箱并关闭网络访问,把 amounts.csv 以内联文件的形式放进 Workspace。内联文件包含三个关键字段:type 为 inline、path 决定文件在沙箱里的位置、data 保存经过 Base64 编码的文件内容。这里的 Base64 只是传输形式,Agent 启动后看到的是普通 CSV 文件。对于更大的输入,也可以先通过 Files API 上传,再在环境配置里引用 File ID。
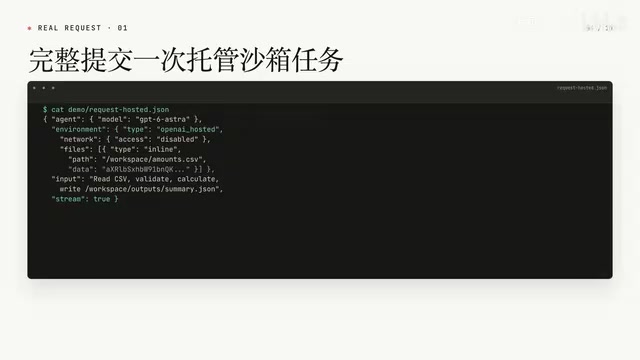
任务本身很简单:读取 CSV、检查 amount 列、计算行数和总额,写入 summary.json。Curl 发出后返回 HTTP 201 并创建 Session,后续的命令执行、工具结果、最终回答以及 Artifact 都归属于这次 Session。
由于设置了 stream: true,服务端会持续返回 SSE 事件。事件流从 Agent Session Created 开始,随后是 Turn Started,Agent 每产生一项工作都会有对应事件(例如一条命令会以 Command Execution 加入并携带执行状态和输出),最后是 Turn Completed 和 Session 回到 Idle。
这里存在三个清晰的层次:Session 是持续存在的任务容器,Turn 是其中的一次推进或迭代,Items 是推进过程中产生的消息、命令、工具结果和最终输出。对于需要执行几十秒甚至更久的任务,这种结构比只等待一段最终文本更容易观察、恢复和接入产品界面。
从执行到下载:闭环是怎么形成的
Session 创建后,输入文件已出现在工作区。Agent 先用 pwd 确认工作目录,再用 cat 查看 CSV 内容——三行数据分别是 Alpha 10、Beta 20、Gamma 30。
关闭网络访问后,Agent 仍能使用已挂载的输入和沙箱自带的 Python 完成工作:用 DictReader 读取 CSV,把 amount 转换成整数求和得到 60,创建 output 目录并写入 JSON,最后再次用 cat 读取结果做校验。小木头特别强调,画面中保留的是真实请求记录,没有用截图代替或省略实际输入输出。
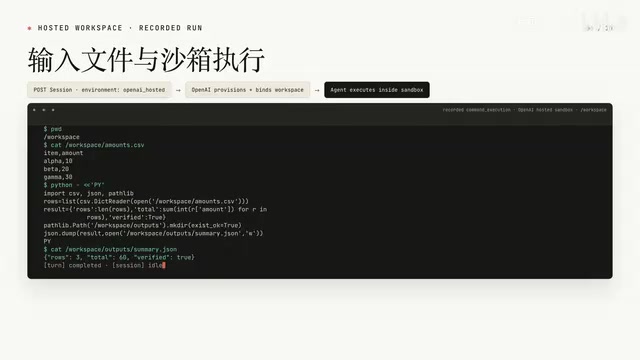
任务完成后,summary.json 会作为 Artifact 发布。有意思的是,文件不会因任务结束就出现在本机,应用需要明确调用 Artifact API 把它取回来:先调用 Session 的 Artifact 接口拿到 Artifact ID、文件名和大小,再调用 Content 接口下载到本地。这样,输入文件、执行命令、生成文件、Artifact 下载和本地复合就形成了一个完整闭环。
SSE(Server-Sent Events) 是一种基于 HTTP 的服务器推送技术,允许服务端在连接保持期间持续向客户端发送事件,而无需客户端轮询。与 WebSocket 不同,SSE 是单向的(服务端到客户端),实现更轻量,适合任务执行日志、进度推送等场景。Agents API 的流式返回正是基于 SSE:每当 Agent 完成一条命令、产生一条消息或进入新的状态,服务端就推送一个结构化事件,应用端可以实时渲染执行过程,而不必等到任务全部完成才能得到任何反馈。对于耗时数十秒乃至数分钟的任务,这一机制对用户体验和系统可观测性都至关重要。
第二个请求:上传 Skill 改变任务行为
第二次请求给同一个 CSV 任务增加了一个 Skill。这个 CSV-report Skill 里有真实的 skill.md 文件和输出格式规范,要求既生成 JSON 也生成 Markdown 报告,还要在结果里标记实际使用的 Skill 名称。
Skill 进入 API 请求的方式是:把整个 Skill 目录打包成 zip,请求体中的 skills 数组使用 base64 类型,media_type 为 application/zip,data 是 zip 的编码内容。input 则明确要求使用 CSV-report 这个 skill。
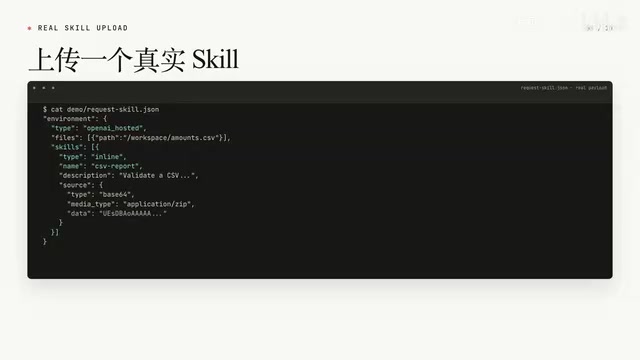
请求返回 HTTP 201 后,skill 被挂载到工作区的 .managed_agents/.skills/CSV-report 路径。小木头列出了四个证据确认 skill 确实生效:Session 返回的环境信息中包含 CSV-report;托管环境出现对应的 managed skills 路径;事件流记录了 Agent 读取 skill.md 并按要求验证字段和生成两种格式;最终 JSON 中出现了 skill_used: CSV-report,Markdown 报告也使用了 skill 规定的结构。
这次生成了两个 Artifact——summary.json(81 字节)和 report.md(221 字节)。对比可见:没有 skill 时只生成基础 JSON,加载 skill 后同时生成结构更完整的 JSON 和 Markdown 报告,两者对同一份 CSV 给出一致的三行总额 60,验证状态都为 true。这说明 Skill 确实被上传、加载并影响了任务结果。
Skill 在 Agents API 的语境中,本质上是一份随任务一起注入执行环境的结构化说明文档,通常包含 skill.md(描述任务方法、输出规范、字段要求等)以及可选的模板或示例文件。与 System Prompt 的区别在于:Skill 以文件形式存在于工作区,Agent 在执行过程中主动读取它,而不是在请求发起时就写入上下文。这种设计使 Skill 可以携带较长的规范说明而不占用初始上下文窗口,也方便版本管理和复用——同一套 Skill 可以在不同任务、不同模型或不同执行环境中共享,团队只需维护 Skill 文件本身,而非修改每次的 Prompt。
上手要点与后续展望
第一次认识 Agents API,可以抓住四个动作:创建 Session、把文件放进托管沙箱、让 Agent 在 workspace 执行任务、把结果作为 Artifact 下载回来。而 Skill 则把一套可复用的方法和输出规范一起装进了执行环境。
责任边界也很清晰:OpenAI 托管 Agent Harness 和可选的 Hosted Sandbox,开发者仍然决定任务指令、输入文件、Skills、网络权限,以及最后如何消费得到的数据或文件。
小木头表示,下一期将把执行环境切换到开发者自己的 Sandbox 或 VPC,演示同一套 Agents API 如何连接自己的基础设施。对于关注 Agent 工程化落地的开发者来说,这套「托管运行层 + 可选执行环境 + 自有能力层」的组合方式,或许是理解 OpenAI Agent 战略的一个重要切口。
相关推荐
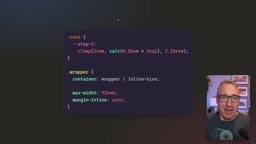
修复流式排版难题:容器查询与@property的组合技
流式排版在容器达到最大宽度后字号仍持续增长、多容器下字号不一致,是 CSS Fluid Typography 的常见痛点。本文讲解如何用容器查询单位配合 @property 注册自定义属性,锁定统一字号,兼顾响应式布局与设计一致性。
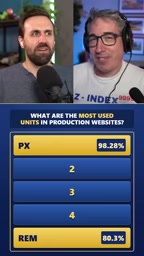
生产环境网站最常用的CSS单位排名揭晓
生产环境网站最常用的CSS单位排名出炉:px居首,em以91.3%覆盖率超越rem,而degrees和seconds竟排进前四。本文解析这份榜单背后的前端现实。
在对象存储上运行Git:重构Packfile的技术思路
探讨如何通过重新生成Packfile让Git运行在S3等对象存储之上。分析Git存储模型与对象存储的兼容难点、打包策略的优势,以及一致性与写放大等现实权衡。