OpenAI Agents SDK 实战:把 Agent 当作工具调用(Agents as Tools)

OpenAI Agents SDK 中「Agents as Tools」模式详解:主 Agent 调用子 Agent 作为工具,实现可控的多智能体协作编排。
本文详细介绍了 OpenAI Agents SDK 中「Agents as Tools」模式的原理与实现。与 Handoff 模式将对话控制权完整移交不同,Agents as Tools 让主 Agent 始终保持主导,把专项子 Agent 通过 `.as_tool()` 方法转换为可调用的工具函数。文章从基础用法出发,依次讲解了默认的单字段输入、通过 `dataclass` 实现结构化参数传递、以及通过 Custom Output Extractor 对工具输出进行加工提取。全程使用 `scripted model` 进行低成本离线验证,最后接入真实 OpenAI API 完成 live 调用,验证了整套机制的可行性。核心认知是:直接运行的 Agent 是协调者,被转换成工具的才是真正的专家 Agent。
什么是 Agents as Tools
在 OpenAI Agents SDK 的生态中,多智能体协作有两种主流模式:Handoff(移交)和 Agents as Tools(智能体即工具)。这两者看似相似,实则在控制流上有本质区别。
当你使用 Handoff 时,原始 Agent 会把整段对话上下文完整地交给另一个专家 Agent,由那个 Agent 直接返回最终答案给用户,控制权发生了转移。而 Agents as Tools 则不同——原始 Agent 始终保持主导地位,它把另一个 Agent 当成一个普通的「工具函数」来调用,拿到子 Agent 的执行结果后,再由自己做后续处理,最终由原始 Agent 返回响应。
换句话说,Agents as Tools 模式下,被调用的「专家 Agent」只负责干活,不负责和用户对话;真正和用户交互的仍然是那个发起调用的原始 Agent。这是理解整套机制的关键。
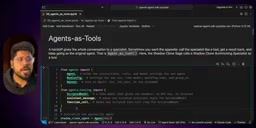
在视频示例中,作者使用了 scripted model、assistant message 和 function call 来构造固定的测试响应,这样可以在不消耗真实 LLM 调用的情况下,模拟并验证整个工具调用链路是否按预期工作。
Handoff 模式在底层会将完整对话历史(包括 system prompt、历史消息等)传递给目标 Agent,目标 Agent 拥有完整上下文并直接生成最终响应,控制权不会再回到原始 Agent。这种模式适合「一次性移交」的场景,例如客服机器人把投诉案例彻底交给专项处理团队。Agents as Tools 则更像函数调用:主 Agent 构造一个结构化请求,子 Agent 在隔离的上下文中执行并返回结果,主 Agent 拿到结果后自行决定下一步。这种模式的优势在于主 Agent 可以串联多个子 Agent、对结果做后处理、或在失败时做重试,整个编排逻辑由主 Agent 掌控,更适合需要多步骤组合的复杂工作流。
把一个 Agent 转换成工具
实现的第一步是正常创建一个 Agent。示例中创建了一个名为 shadow clone summoning specialist 的专家 Agent,其指令是「从被击败的敌方忍者中召唤影分身并报告其等级」,变量名为 shadow_clone_agent。
关键一步是调用 .as_tool() 方法,把这个 Agent 转换成工具:
tool_name:summon_shadow_clonetool_description:对工具功能的描述- 返回的工具对象赋给
summon_tool
转换完成后,这个专家 Agent 就变成了一个可以被其他 Agent 调用的工具。
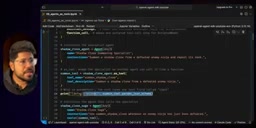
查看工具 Schema 时会发现一个细节:如果不显式传入任何参数,工具默认会接收一个名为 input 的文本字段。这是 SDK 的默认行为,理解它有助于后续处理结构化输入。
接着再创建第二个 Agent shadow clone sage,它的指令是「每当敌方忍者被击败时,使用 summon shadow clone 工具」,并在 tools 参数中传入前面生成的 summon_tool。这样第二个 Agent 就能把第一个 Agent 当工具来用了。
scripted model(脚本化模型)是 OpenAI Agents SDK 提供的测试工具,允许开发者预先定义一组固定的「响应序列」,运行时 SDK 会按顺序返回这些预设响应,而不会发起任何真实的 LLM API 调用。这类似于单元测试中的 mock/stub 机制——你可以在本地、离线、零成本地验证 Agent 的控制流、工具调用顺序和参数传递是否符合预期,而不必每次都等待并付费于真实的 GPT 请求。assistant message 用于模拟 LLM 给出的文本回复,function call 则用于模拟 LLM 决定调用某个工具时产生的调用指令,二者组合可以完整还原一次真实的工具调用交互过程。
运行与验证调用链路
作者编写了一个异步函数 demo_as_tool,用 scripted model 构造了一组模拟操作序列:先是一个 function call(即工具调用 summon,默认 input 作为参数),然后是工具返回的断言消息「summoning successful, rogue ninja zone in」,最后是 LLM 的消息「the rogue ninja shadow clone has joined your ranks」。
通过 await runner.run() 传入 shadow_clone_sage、查询语句「the rogue ninja has been defeated」,以及包含 scripted model 和 workflow name 的 run config,即可执行。

运行结果显示,最终输出为「the rogue ninja shadow clone has joined your rank」,没有任何报错,说明一个 Agent 被成功地当作工具调用了。这里能看到默认传入的 schema 以及正确的最终输出,验证了整条链路的可行性。
传入结构化参数(Typed Input)
默认的单一 input 字段往往不够用。实际场景中,我们希望向被转换的工具传入结构化参数。这时需要借助 dataclass。
示例中定义了一个数据类 shadow_clone_input,包含 enemy_name 和 enemy_rank 两个字段。核心思路分三步:
- 定义数据类:描述输入结构
- 编写 input builder 回调:接收这些结构化输入后,拼接成一段 prompt 字符串(如「summon a shadow clone from enemy_name and enemy_rank」)传给 LLM
- 在 as_tool 中传入:通过
shadow_clone_input作为参数类型,input_builder作为转换函数
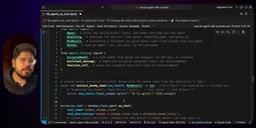
运行后,最终输出依然是「the rogue ninja shadow clone has joined your ranks」,但关键变化在于:工具的 properties 从默认的 input 变成了 enemy_name 和 enemy_rank。这证明结构化输入被正确传递。需要注意的是,这套机制依赖固定的结构,任意字符串输入未必能直接适配。
在 Python 中,dataclass(数据类)是通过 @dataclass 装饰器定义的轻量级结构体,编译器会自动生成 __init__、__repr__ 等方法,省去手写样板代码。在 Agents SDK 的 as_tool() 上下文中,传入 dataclass 类型后,SDK 会自动将其字段映射为 JSON Schema 中的 properties,供 LLM 在生成 function call 时使用——这正是工具的 Schema 从单一 input 字段变成 enemy_name、enemy_rank 两个字段的原因。input_builder 回调则承担「结构化数据 → 自然语言 prompt」的桥接职责:LLM 填好结构化字段后,回调函数将其拼接成一段可读的指令文本,再传给子 Agent 执行,从而兼顾了类型安全与 LLM 的文本理解能力。
用 Custom Output Extractor 加工工具输出
SDK 还允许在把工具(即被转换的 Agent)的输出传回原始 Agent 之前,对其进行自定义加工,这通过 custom output extractor 实现。
作者定义了一个异步提取函数 extract_enemy_name,接收类型为 RunResult 的参数,从 final_output 中提取信息。由于示例构造的输出有固定结构(如「summoning successful: rogue ninja zone」),可以按冒号 split、取相应索引、strip 清理,最终提取出「rogue ninja」这部分并返回。
这样一来,工具调用后返回给原始 Agent 的内容就不再是原始完整输出,而是经过提取加工后的精简结果——「tool output after extraction」显示为 rogue ninja。
RunResult 是 SDK 中封装单次 Agent 运行结果的对象,包含 final_output(最终输出文本或结构化数据)、messages(完整消息历史)、last_agent(最后执行的 Agent 实例)等字段。Custom Output Extractor 的设计动机在于:子 Agent 的原始输出往往是面向人类可读的完整句子(如「summoning successful: rogue ninja Zabuza zone A」),而主 Agent 后续逻辑可能只需要其中的关键实体(如「Zabuza」)。通过在工具层面做提取而非让主 Agent 自行解析,可以降低主 Agent 的上下文负担,同时让提取逻辑集中、可复用、易测试。提取函数为异步(async)设计,意味着其中可以进行额外的异步操作,例如调用另一个 API 做实体验证或格式转换。
真实 LLM 调用下的实战
前面的例子都用 scripted model 做离线模拟。最后作者演示了接入真实 OpenAI API 的 live 调用。
流程是先加载 OpenAI API Key,定义一个 live 版的 output extractor extract_name_live,把 run_result.final_output 转为字符串文本并提取出忍者名字。在 demo_live 函数中先检查 API Key 是否可用,可用则走真实调用,否则退回到固定结构提取。
Agent shadow clone page 的指令是「每当敌方忍者被击败时使用 summon shadow clone」,工具参数传入作为 tool 的 specialist Agent。查询语句为「team 7 just defeated the zone rank rogue ninja Zabuza as mission 05」。
运行结果显示:last agent 是 shadow clone stage,提取后的工具输出为「Zabuza」(正确),最终输出为「shadow clone summoned from defeated rogue ninja is Zabuza」。真实 LLM 调用下,Agent 作为工具的协作同样正常工作。
一个关键认知:谁才是「专家 Agent」
视频最后强调了一个容易混淆的点:你直接 runner.run() 运行的那个 Agent 不是专家 Agent,被你转换成工具、作为 tool 传入的那个才是专家 Agent。
在示例里,直接运行的是 shadow clone sage/page,它负责和用户交互;而 shadow clone summoning specialist 被转成工具后传入,它才是真正干专项活的专家 Agent。理清这个层级关系,才能在构建多智能体系统时正确地分配职责。
小结
Agents as Tools 为多智能体编排提供了一种更可控的模式:主 Agent 保持对话主导权,把专项任务委托给被封装成工具的子 Agent。配合 typed input 和 custom output extractor,开发者可以精细控制输入输出的格式与加工逻辑,既能用 scripted model 低成本调试,也能无缝切换到真实 LLM 环境。
相关推荐

拆解华硕ROG 20周年限定全家桶:史上最稀有PC装机实录
LTT拆解华硕ROG 20周年纪念版全套硬件:镀金主板、256GB内存、RTX 5090 Astral显卡与骨架机箱。深度观察顶级旗舰的过度工程、品牌营销与真实装机困境。

OpenAI SDK v3.27.0 发布:新增预热托管环境
OpenAI 官方 SDK 发布 v3.27.0 版本,核心新增预热托管环境(prewarmed hosted environments)特性,有助于降低托管推理的冷启动延迟。本文解读该版本更新内容与开发者升级建议。

AI长期记忆新思路:5000万Token窗口能否比重算更快更省
一则 Reddit 讨论提出构建 5000 万 Token 的 AI 长期记忆窗口,声称比传统重算更快更便宜。本文解析其技术意涵、可能实现路径及对 AI 应用的影响,并对相关宣称保持审慎分析。