OpenAI 推出 Decisions API:让 AI 在毫秒间做决定

OpenAI 推出 Decisions API,用约束式输出将大模型变成百毫秒级高速决策器,覆盖文本分流、视觉判断与机器人控制等场景。
OpenAI 演示的 Decisions API 基于 GPT-6 Luna 模型,通过将输出空间限定为少数预设选项,将响应速度提升近十倍、服务端延迟压缩至 100 毫秒以内。它同时支持文本与图像输入,适用于工单分流、销售线索分类、实时车道判断等高频决策场景,也可与语音接口及机器人硬件结合,驱动角色表情切换或机器人头部朝向控制。关键亮点在于其对模糊语义指令的理解——能区分"苹果"与"更好玩的东西"——体现了语义级权衡而非简单像素匹配。目前相关性能数据尚无第三方验证,但其"低延迟决策 API"的产品思路代表了将 AI 从内容生成推向实时决策的重要方向转变。
什么是 Decisions API
当应用需要在极短时间内完成智能判断——路由一次请求、分类一张图像、或者决定智能体下一步动作时,常规的大模型推理往往太慢。OpenAI 在最新演示中推出的 Decisions API,正是针对这类场景设计的轻量级决策接口。
据演示介绍,Decisions API 基于名为 GPT-6 Luna 的模型运行,核心思路是让模型只专注于少数几个候选选项,从而把响应速度提升近十倍。使用方式相当直接:开发者传入一段文本或一张图片,设定好问题与一组可选答案,模型就能在零点几秒内返回选中的结果。
这种"约束式输出"的设计并不追求开放式生成,而是把模型当成一个高速分类器与决策器来用。它同时保留了图像理解、多语言支持以及安全防护等能力,适合嵌入到对延迟敏感的交互链路里。
"约束式输出"在大模型领域并非全新概念,其技术根源可追溯到受限解码(Constrained Decoding)与结构化生成(Structured Generation)方向。传统自回归语言模型每次生成时需要在整个词表(通常数万乃至数十万个 token)上做 softmax 采样,计算开销随词表规模线性增长。当输出空间被限定为几个离散选项时,模型可以跳过大量不必要的候选,仅对指定选项的 logit 进行比较,从而大幅压缩单次推理的计算量与内存带宽需求。这种做法类似于把开放式问答题变成单选题——模型仍然需要理解语义,但"答题"本身的成本大幅下降。业界已有 Outlines、Guidance、LMQL 等开源框架实现类似机制,Decisions API 可视为 OpenAI 将这一思路产品化并针对延迟场景专项优化的结果。
文本场景:从非结构化内容到自动分流
演示中最基础的用法,是从长段非结构化文本中提取表单字段。但真正体现价值的是进一步的自动分流——比如把支持工单归类分发,或者把入站销售线索精准派发给对应团队。
演示现场展示了多条随意的用户输入被迅速归类为销售线索,而且据称这还没有经过任何加速处理,服务端响应时间不到 100 毫秒。对于需要在后台实时处理海量文本流的业务来说,这种延迟水平意味着可以把 AI 决策直接放进主流程,而不必担心拖慢整体体验。
视觉场景:实时画面驱动的决策
Decisions API 更令人意外的能力在于图像输入。演示用一个小游戏说明:API 实时抓取道路与障碍物画面,快速判断小车该留在当前车道还是向左、向右变道。即便把车速提上去,它依然能操控小车驶入正确车道,耗时只是传统推理模型的一小部分。
这类能力自然指向了基础的"计算机使用"任务——截取屏幕、迅速返回操作指令。演示方也坦言,面对极其复杂的计算机或浏览器操作,仍需要专门的 Astra 能力来支撑,Decisions API 更适合那些选项有限、需要高频快速判断的环节。
将视觉模型用于实时控制决策,在工程上面临两个关键瓶颈:图像编码延迟与推理吞吐量。主流视觉语言模型(VLM)通常先用视觉编码器(如 ViT 系列)将图像转化为高维特征向量,再交给语言模型部分解读,整个流程端到端延迟往往在数百毫秒到数秒不等,难以满足实时控制需求。Decisions API 声称的"传统推理模型一小部分"延迟,意味着其很可能对视觉编码路径也做了专项裁剪——例如降低图像分辨率、使用更小的视觉主干,或针对分类任务跳过逐 token 生成环节,直接输出候选项得分。这与工业界在自动驾驶感知、机器人抓取等领域采用的"轻量感知头 + 重量级规划模型"分工思路高度吻合,即用快速但专用的模块处理高频感知决策,复杂推理交由更慢但更强的模型离线或低频执行。
与语音、机器人结合的多模态玩法

演示把 Decisions API 与语音模态结合,用 GPT Live 1 处理语音对话,由 Decisions API 实时决定动画角色在对话中该使用哪种表情。角色会从一组预设表情里挑选,让细微反应自然融入对话节奏。
更有意思的是机器人演示。借助 Hugging Face 提供的一台即将推出的 MicroDuck 样机(昵称 Lavender),团队用 GPT Live 提供语音智能,用 Decisions API 根据摄像头画面决定机器人头部朝向。
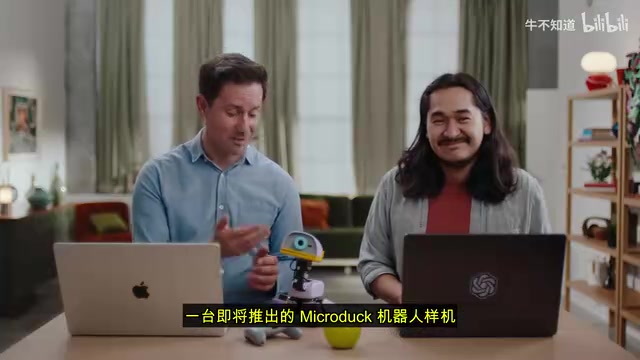
决策选项非常简单——头向左转还是向右转。摄像头每隔几帧的画面都交给 Decisions API 分析,由它判断哪个物体是"苹果",并驱动机器人看向目标。
MicroDuck 是 Hugging Face 旗下面向开发者的低成本开源机器人项目系列之一,定位于提供可编程、易上手的实体 AI 实验平台。Hugging Face 近年来持续投入具身智能(Embodied AI)领域,旗下 LeRobot 项目已开源多款机械臂与移动机器人的训练框架与数据集,目标是让研究者用消费级硬件复现机器人操控实验。将 Decisions API 这类低延迟决策层与实体机器人结合,正好填补了"大模型太慢、传统控制算法太死板"之间的空白——语义理解交给语言模型,高频动作决策交给约束输出接口,底层电机控制仍由嵌入式系统负责,形成三层分工架构。这一思路与近期学术界流行的"快慢系统"机器人控制框架(Fast-Slow Systems)在理念上高度一致。
概念理解与模糊指令
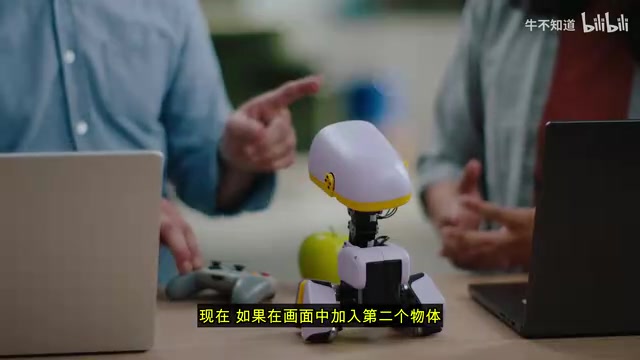
真正展现模型理解力的,是对模糊指令的处理。当操作者说"盯着水果"时,Lavender 能理解概念并追踪对应物体;当画面里同时出现苹果和游戏手柄,提问"哪个更好玩"时,机器人看向了手柄——因为手柄显然"更好玩"。即便交换物体位置,它依然能做出一致判断并持续跟随。
这说明 Decisions API 并非简单的像素匹配,而是在候选选项之间进行带有常识与语义理解的权衡。对于机器人、交互玩具、辅助设备等需要"轻量判断 + 实时反应"的场景,这种能力相当有想象空间。
一点冷静思考
Decisions API 的定位清晰:用约束输出换速度,把大模型变成一个可嵌入主流程的高速决策器。它既支持文本、视觉输入,也能配合语音交互,覆盖了从工单分流到机器人控制的多种用例。
不过需要注意的是,上述内容来自单一演示来源,GPT-6 Luna 等模型名称与性能数据暂无第三方独立验证,实际延迟、准确率以及复杂场景下的表现仍有待观望。对开发者而言,真正值得关注的是这种"低延迟决策 API"所代表的产品思路——把 AI 从"生成内容"推向"直接做决定",可能会催生出一批全新的实时交互应用。
相关推荐

本地模型为何在Doom游戏决策中击败Jev AI API?
YouTube视频对比显示,本地模型GLiNER在Doom游戏中以12毫秒响应和8.8次/秒决策频率,大幅超越Jev AI API的2.5次/秒,得分翻倍。

Screen Studio 4.0 发布:玻璃放大镜、摄像头抠像与文本式剪辑
Screen Studio 4.0 发布,带来玻璃放大镜、文本式剪辑、摄像头抠像等新功能,并提升导出性能。这款 Mac 屏幕录制工具在 Product Hunt 排名第一,致力于简化视频制作流程。

ClawsGO Science:自带云端实验室的AI科研智能体
ClawsGO Science 是 Product Hunt 上线的 AI 科研智能体,自带云端实验室,集成 500+ 工具和 90+ 数据集,可调度 Claude 与 GPT 智能体集群连续运行数天,从提问自动生成带引用的论文。