ClawsGO Science:自带云端实验室的AI科研智能体

ClawsGO Science 试图用云端实验室与长时程多智能体调度,把科学问题直接变成带引用的论文。
ClawsGO Science 在 Product Hunt 排名第二,主打端到端自动化科研:用户输入科学问题,系统在自有云端实验室中完成实验与写作,输出带引用的论文。其卖点包括 500+ 工具与 90+ 数据集的一体化环境,以及能让 Claude 和 GPT 智能体集群连续运行数天的长时程调度框架。文章肯定其把「提问—实验—写作」串成完整链路的价值,同时指出自动论文在可复现性、实验设计合理性和引用准确性上仍缺乏第三方验证,概念热度与科研可用性之间尚有距离,成败取决于输出能否经得起同行审视。
科研自动化正在从「辅助工具」走向「端到端执行者」。Product Hunt 上排名第二的新品 ClawsGO Science 提出了一个颇具野心的定位:把一个问题直接推进到可引用的论文。
它到底在做什么
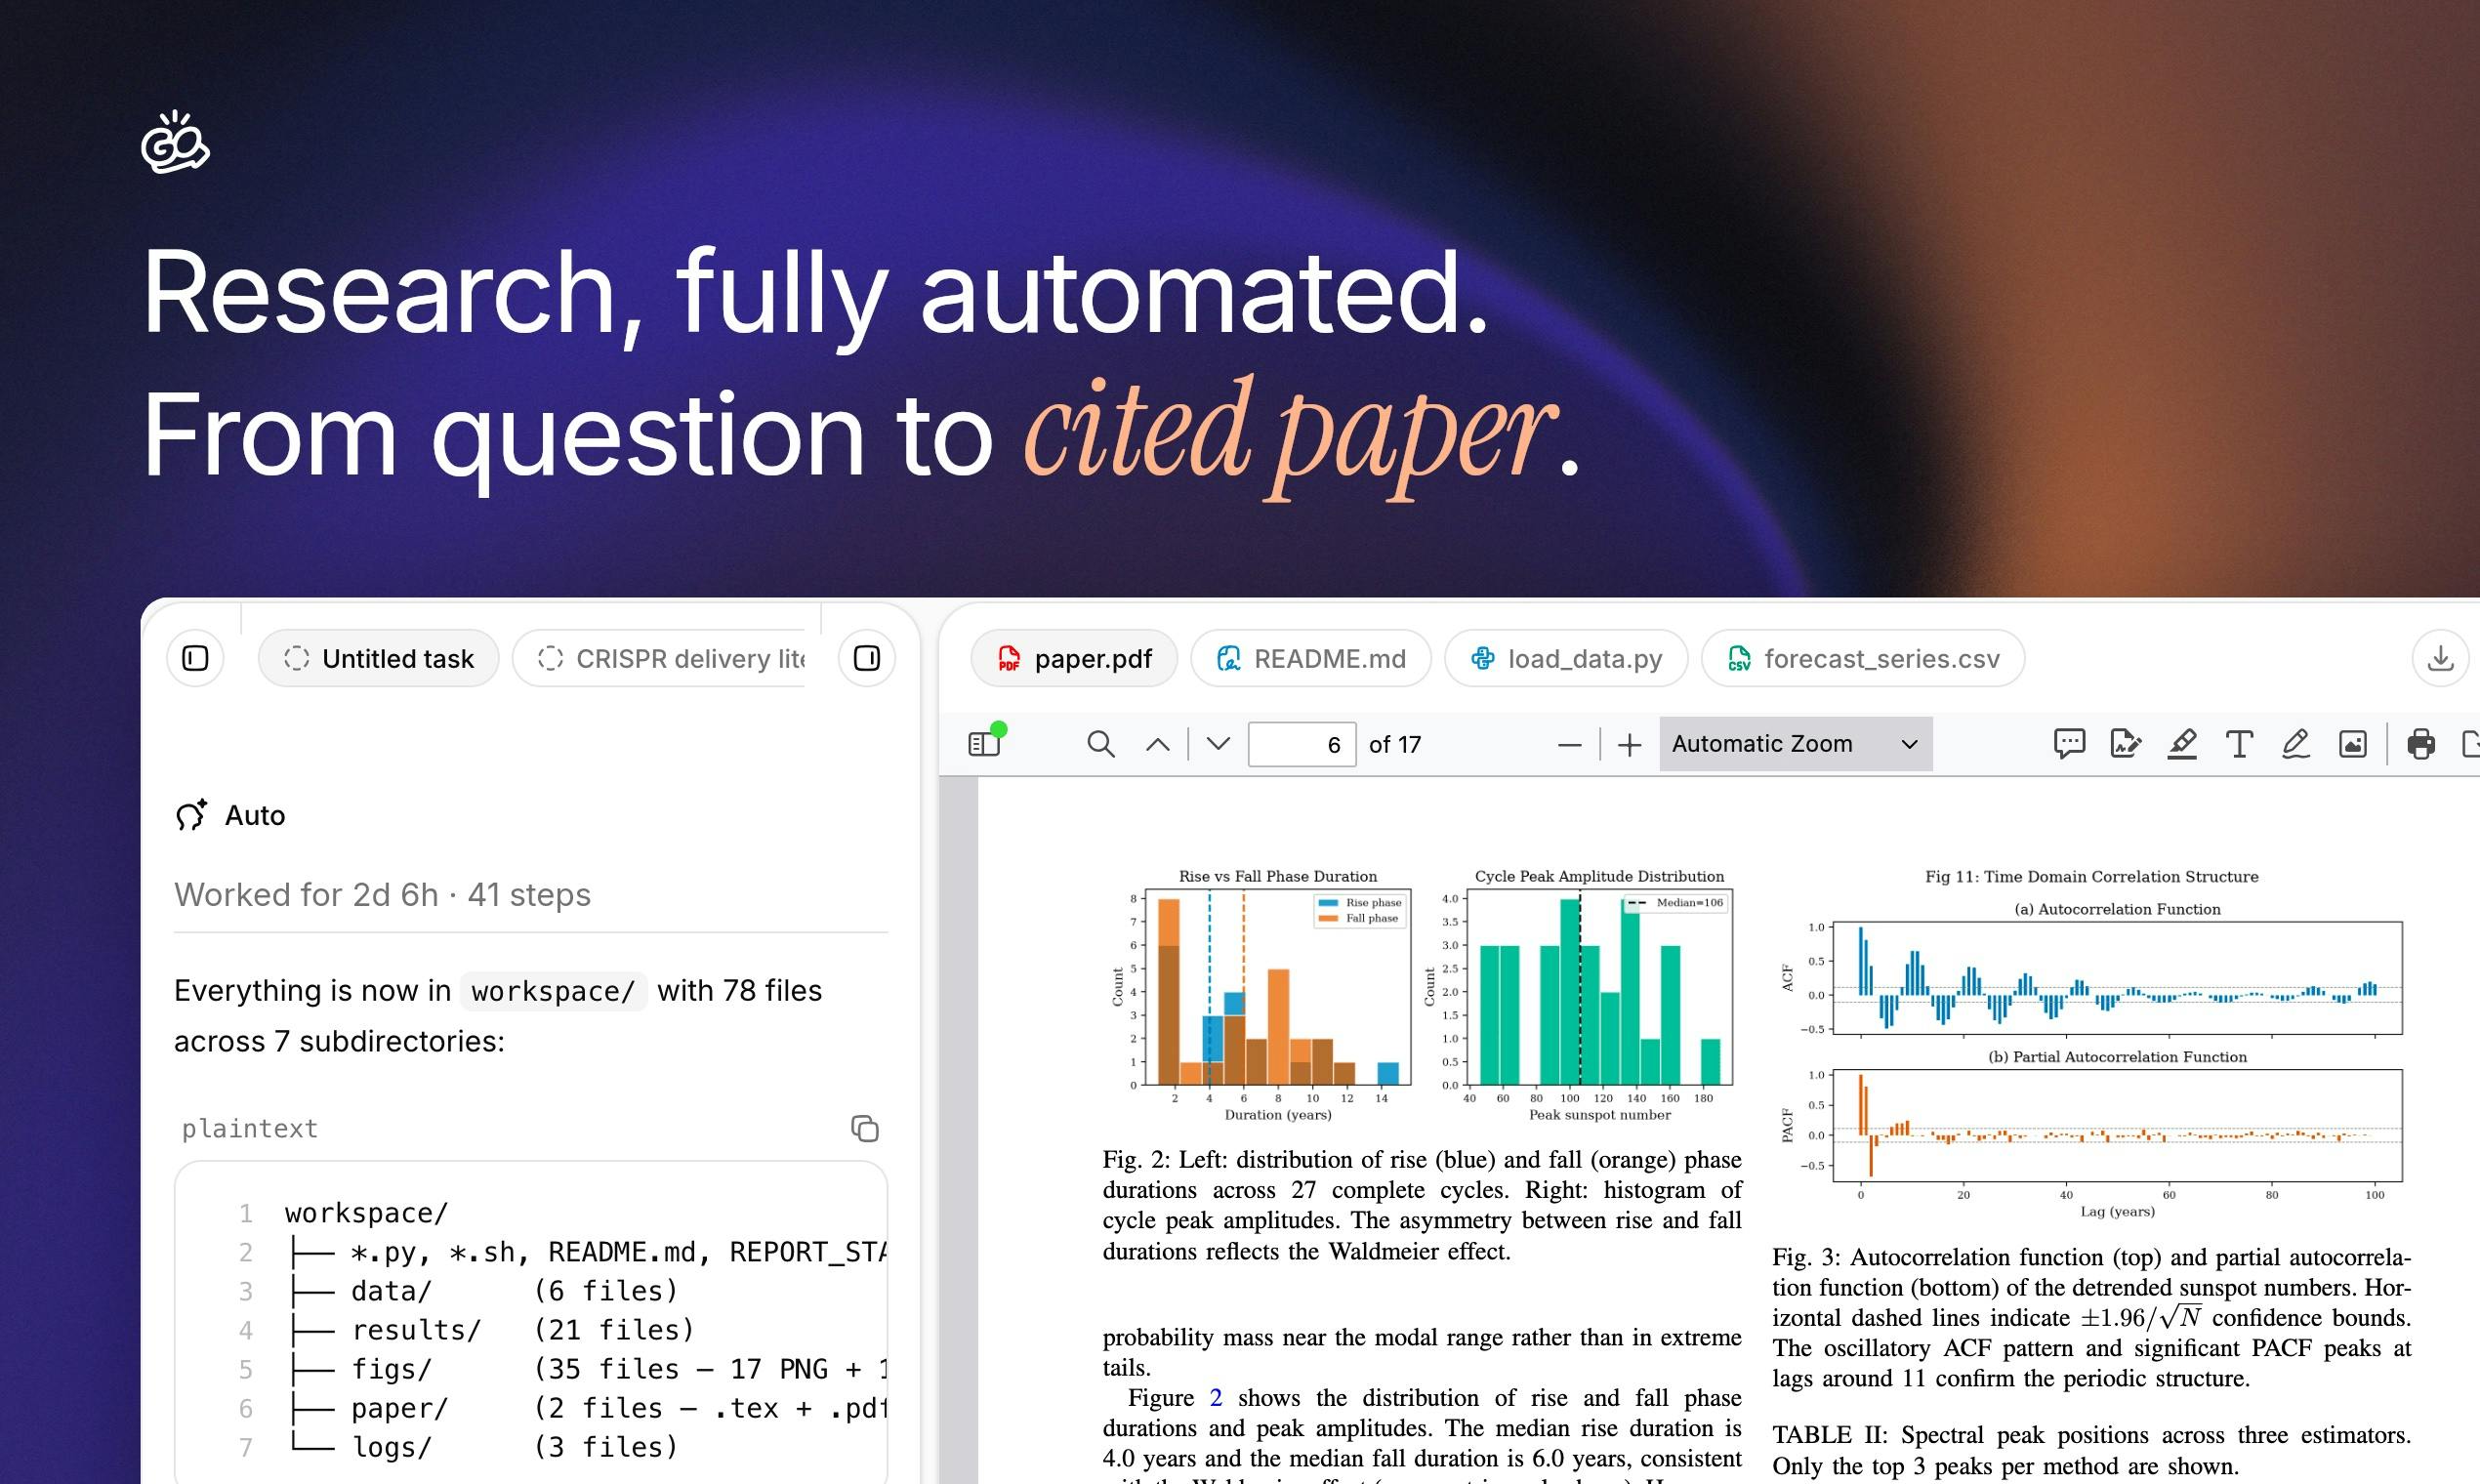
ClawsGO Science 的自我描述很直接——「Research, fully automated」。用户输入一个科学问题,系统在自有云端实验室中完成研究流程,最终输出一篇带有引用的论文。
这套流程的关键不在于某一步的自动化,而在于把「提问—实验—写作」串成一条完整链路。传统 AI 科研助手大多停留在文献检索或代码生成,ClawsGO 试图覆盖的是整条研究流水线。
云端实验室:500+ 工具与 90+ 数据集
据产品页面信息,ClawsGO 的云端实验室内置了 500 多个工具和 90 多个数据集。这意味着智能体可以在同一环境内调用计算资源、数据处理能力和分析工具,而不必依赖外部拼装。
把工具和数据集中托管,理论上解决了两类问题:一是智能体在长任务中频繁切换外部服务带来的不稳定性,二是数据与算力之间的权限和格式摩擦。对于需要反复迭代的实验型研究,这种一体化环境的价值更明显。
云端实验室(cloud lab) 在这里不是指远程操控真实湿实验设备,而是指托管在云端的软件化科研环境集合,包括计算 notebook、数据管道、分析库和模型服务。它与「拼装式」方案的区别在于统一身份认证、统一数据格式和统一调度接口。这类环境的风险点在于供应商锁定:研究流程一旦深度绑定某家平台的工具链和数据集,迁移成本会很高,而科研恰恰强调可迁移与可验证。此外,工具数量本身并不等同于能力覆盖,500 多个工具中真正被高频调用的可能只是少数,评估时应关注工具之间的编排质量而非绝对数量。
长时程调度框架:让智能体「跑几天」
ClawsGO 另一个值得关注的设计是它的 long-horizon harness。官方称它能调度 Claude 和 GPT 智能体集群连续运行数天。
这一点触及了当前 AI Agent 的核心瓶颈。多数智能体在短任务上表现尚可,但一旦任务跨度拉长到数小时甚至数天,就会出现上下文漂移、目标遗忘和错误累积。用集群方式分摊长任务,是业界正在探索的方向之一,ClawsGO 把它作为产品卖点,说明其对多智能体协作调度有一定工程积累。
Long-horizon harness 指的是为超长任务设计的调度外壳(harness 原意为马具,在软件中指包裹并驱动某组件的执行框架)。它通常包含任务分解器、状态持久化存储、检查点与回滚机制、以及跨会话的记忆压缩模块。与普通 Agent 框架相比,长时程 harness 的核心难点在于:如何把数天的执行历史压缩成有限的、可重放的上下文,如何在子任务失败时局部重试而非全局重启,以及如何在多智能体之间建立统一的进度账本。业界常见做法包括用外部向量库保存中间结论、用结构化计划文件替代长对话记忆、以及设置周期性「健康检查」子智能体来纠正目标漂移。ClawsGO 声称能连续运行数天,意味着它至少要在上述某几个环节给出工程解。
从工具到「范式」的跳跃
ClawsGO 在宣传语中用了「The next paradigm for science」这样的表述。这种说法需要审慎看待。
一方面,端到端自动化科研确实可能改变研究者的工作方式——把重复性实验和初稿撰写交给智能体,人专注于问题定义和结果判断。另一方面,自动生成的论文在可复现性、实验设计合理性和引用准确性上仍需严格验证。目前公开信息中,没有看到关于输出质量的第三方评测或案例细节。
在 Product Hunt 上,该产品获得 132 票、18 条评论,位列当日第二,说明社区对其概念有相当兴趣。但概念热度与实际科研可用性之间,还有不小的距离需要产品自己证明。
可复现性(reproducibility) 是判断自动化科研产出的第一道硬门槛。它要求论文中的每一条实验记录都能被第三方在相同条件下重跑并得到一致结果。对 AI 生成论文而言,这意味着系统必须完整记录工具版本、数据集快照、超参数、随机种子和执行轨迹。目前多数端到端科研智能体只输出最终文本,中间过程被压缩成对话历史,难以审计。另一个相关概念是实验设计合理性——自动化系统容易产生「能跑通但无科学意义」的对照实验,比如缺少必要的阴性对照或样本量不足。引用准确性则涉及引用幻觉问题:模型可能生成看似合理但并不存在的文献条目,这在学术场景中属于致命错误。这三项构成了外部评审对自动论文的基本检验清单。
谁适合关注它
对于需要快速做探索性分析的研究团队,ClawsGO 这类工具可以作为前置筛选器——先用自动化流程跑一轮假设,再由人类判断哪些方向值得深入。对于工程团队,它的多智能体长时程调度思路也具备参考价值。
真正决定这类产品成败的,不是工具数量或数据集规模,而是输出论文能否经得起同行审视。这一点,ClawsGO 还需要用实际案例来回答。
相关推荐

beacon.sh:为AI编程助手装上自我进化记忆
beacon.sh 是一款开源、可自我进化的 AI 编程代理记忆层,支持 Claude Code、Cursor、Codex 等 20 多个 harness,把代理会话转化为复利式知识层,解决跨工具记忆断层问题。

Xmind 2027发布:思维导图进化为AI思考伙伴
Xmind 2027 在 Product Hunt 发布,主打「AI 思考伙伴」定位。新增 Xmind Agent 支持基于本地文档与导图做研究,并通过 MCP 将导图上下文接入 ChatGPT、Claude 等 AI 工作流。本文解析其产品逻辑、差异化优势与待验证的问题。

UnleashX:像雇人一样雇佣AI员工,对话直接交付成果
UnleashX在Product Hunt上线,主打像雇人一样雇佣AI员工:选角色、连CRM和工具、设规则,端到端执行工作流,人类仅在必要时介入。本文分析其产品定位、配置逻辑与人机协作边界。