OpenAI被曝悄悄重启Codex对话数据训练,用户隐私再引担忧
OpenAI被指静默重启Codex聊天数据训练,引发开发者对代码隐私与透明度的担忧。
文章基于Hacker News社区讨论,指出OpenAI可能在未明确公告的情况下重新将Codex聊天数据纳入模型训练,而此前OpenAI曾承诺不使用这些数据以缓解开发者顾虑。社区反应集中在两点:对“静默”操作的不满,以及对专有代码、API密钥等敏感信息被用于训练的警惕。文章回顾了OpenAI在ChatGPT数据政策上“先默认使用、后提供退出选项”的先例,分析Codex数据对提升编程能力的高价值与知识产权风险并存的矛盾,并建议开发者定期审查数据政策、企业用户在合同层面明确数据不被训练或选择本地化部署。事件真实性尚待官方确认,但已凸显AI厂商透明度与用户信任的平衡难题。
据Hacker News社区讨论,OpenAI似乎正在悄悄重新启用对Codex聊天数据的模型训练。这一发现引发了开发者社区对数据隐私和透明度的新一轮担忧。
事件回顾:从关闭到“静默”重启
Codex是OpenAI推出的代码生成模型,曾作为GitHub Copilot的底层引擎。此前,OpenAI曾表示不会使用Codex的聊天数据来训练模型,以缓解开发者对代码泄露的顾虑。然而,近期有用户发现,OpenAI可能已在未明确公告的情况下,重新将Codex对话纳入训练数据管道。
Hacker News上的讨论帖标题直指“OpenAI似乎正在悄悄重新启用对Codex聊天的模型训练”,尽管帖子本身只有简短的标题和30点热度、14条评论,但足以在开发者圈层中激起涟漪。
Codex与GitHub Copilot的关系:Codex是OpenAI基于GPT-3微调而来的代码生成模型,2021年首次发布。GitHub Copilot在早期版本中正是以Codex(具体为OpenAI Codex的一个变体)作为底层引擎,通过IDE插件为开发者提供代码补全和生成功能。OpenAI后来将Codex的能力整合进GPT-3.5/GPT-4系列模型,并逐步以API形式对外提供服务;Codex作为独立模型的品牌逐渐淡出,但其技术血脉延续在后续的代码相关能力中。理解这一沿革有助于判断“Codex聊天数据”具体指什么——它通常指开发者通过Codex相关接口或产品提交的提示词与生成内容,这些对话中常包含大段专有代码。
社区反应:信任赤字与透明缺失
在Hacker News的评论区,用户情绪集中在两点:一是对“静默”操作的不满,二是对代码数据可能被用于训练的警惕。有评论指出,OpenAI的服务条款和隐私政策往往留有解释空间,普通用户很难及时察觉数据用途的变化。
这种“先承诺、后调整”的做法并非OpenAI首次。此前在ChatGPT的数据使用政策上,OpenAI也曾因默认使用对话数据训练模型而受到批评,后来才逐步推出用户选择退出的选项。此次Codex的变动,再次凸显了AI公司在数据利用与用户信任之间的微妙平衡。
为什么Codex数据如此敏感?
Codex面对的是开发者群体,对话内容往往包含专有代码、API密钥、业务逻辑等敏感信息。一旦这些数据被用于模型训练,不仅可能引发知识产权争议,还可能让企业客户对使用AI编程工具产生顾虑。
从技术角度看,代码数据对提升模型编程能力极具价值。OpenAI若确实重启训练,动机不难理解——在AI编程助手竞争白热化的当下,高质量代码对话是稀缺资源。但问题在于,这种数据利用是否经过了用户的明确知情同意。
专有代码与API密钥的风险机制:开发者在使用AI编程助手时,往往会将报错日志、函数实现、配置文件片段甚至环境变量直接粘贴进对话框,以便模型给出针对性建议。这些内容中可能混有API密钥、数据库连接字符串、内部服务地址等凭据。一旦此类对话被纳入训练数据管道,理论上存在两种风险路径:其一,模型在生成时可能“记忆”并复现训练语料中的敏感片段(已有研究证明大模型可逐字吐出训练数据);其二,数据在存储与处理环节的访问控制若不够严格,可能扩大泄露面。对企业而言,这不仅是知识产权问题,还涉及合规审计与供应链安全。
对开发者的影响与建议
对于依赖Codex或类似AI编程工具的开发者,此次事件提醒我们:需要定期审查所用工具的数据政策,尤其是涉及代码内容的服务。企业用户应考虑在合同层面明确数据不被用于训练,或选择提供本地化部署、数据隔离的方案。
同时,这也给AI厂商敲响警钟:在数据驱动的商业模式下,透明度和用户控制权正成为核心竞争力。静默调整政策或许能短期获益,但长期看会侵蚀用户信任。
数据隔离与本地化部署方案:面对云端AI编程工具的数据用途不确定性,企业可考虑几类替代路径。一是选择明确承诺“不使用客户数据训练”的企业版API,并在合同中写入数据删除与审计条款;二是采用支持本地化部署或私有云部署的代码模型(如部分开源代码模型的商业发行版),使代码不出内网;三是在IDE层面配置敏感信息过滤规则,阻止密钥、内网地址等模式的内容被发送至外部服务。此外,定期审查服务商的隐私政策变更记录、关注其数据使用开关的默认状态,也是成本较低的防护手段。
结语:透明度不应是事后补救
目前OpenAI尚未对此事做出公开回应,事件真实性仍有待官方确认。但即便最终证明是误解,社区的反应已经说明问题:在AI深度融入开发流程的今天,任何关于数据用途的变动都不应“静默”发生。用户需要的是提前告知和真正的选择权,而非事后解释。
(本文基于Hacker News社区讨论,OpenAI官方尚未置评。)
相关推荐
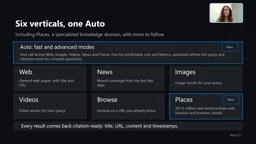
微软WebIQ:为AI Agent提供可验证的实时网页接地
微软WebIQ为AI Agent提供实时、可引用的网页接地能力,覆盖网页、新闻、图片、视频、Places等来源,P95延迟164毫秒,同等质量下token用量减少50%,支持Scopes来源控制与MCP接入。
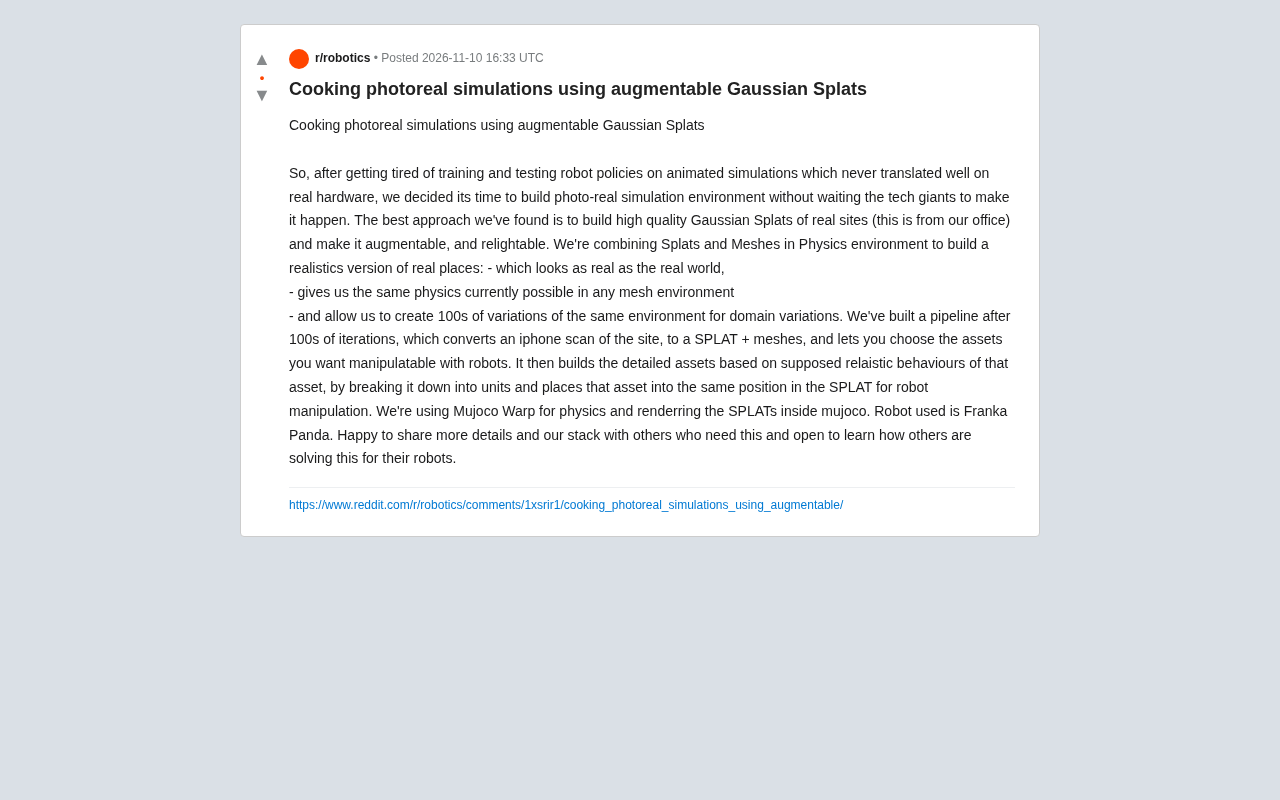
可增强高斯泼溅:打造机器人训练的照片级仿真环境
团队用高斯泼溅与网格混合构建照片级真实感机器人仿真环境,结合 MuJoCo Warp 物理引擎与 Franka Panda 机器人,实现可增强、可重打光的真实场地仿真,缩小仿真到现实的视觉差距。

Gemini 4 Carbon发布:一年内从Gemini 3到Gemini 4的飞跃
Google发布最新前沿模型Gemini 4 Carbon,距离Gemini 3不到一年。官方演示中Carbon一次性完成Theme Park二进制逆向工程、添加DeepMind主题新设施并移植到Web,展示了模型在长链路工程任务上的能力进展。