OpenAI构建AI Agent的三种方式:如何选对技术层级

OpenAI提供三层Agent构建路径,核心权衡是控制力与托管便捷性的取舍,数据合规是关键选型门槛。
OpenAI为开发者提供三种构建AI Agent的路径,分别是底层的Responses API、中间层的Agents SDK,以及全托管的Agents API,三者本质上是在控制权与便捷性之间做出不同取舍。Responses API给予最大自主权但工程负担最重;Agents SDK将运行循环内置于开发者自己的应用中,保留编排控制的同时省去底层循环实现;Agents API则托管了持久会话、编排、上下文压缩和故障恢复等全套运行时能力,落地成本最低。但Agents API存在显著限制:目前仅支持美国数据驻留,且不符合ZDR(零数据保留)资格,对有严格合规要求的企业构成硬性障碍。选型的核心判断标准是:数据控制需求是否与托管方案兼容,提前厘清这一约束,才能避免后续陷入不必要的工程复杂度。
构建AI Agent时,技术选型往往决定了后续工程的复杂度。OpenAI提供了三条不同的路径来构建智能体,而选错层级意味着要承担不必要的工程负担。这三种方式分别对应从底层控制到完全托管的不同抽象级别,理解它们的差异是做出正确决策的前提。
三条路径:从底层到托管
OpenAI的三种构建方式本质上是在控制权和便捷性之间做权衡。层级越低,开发者掌握的控制越多,但需要自己处理的工程细节也越多;层级越高,运行时的大量"管道工作"被平台接管,但灵活性和数据控制权相应减少。
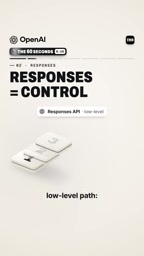
Responses API:最底层的控制
Responses API 是最低层的路径,核心构成是模型加上托管工具与自定义工具。这条路径把最大的控制权交给开发者——你直接面对模型调用,自行组织工具的使用逻辑。适合那些需要高度定制、不希望被框架约束的场景,但代价是需要自己搭建更多的基础逻辑。
Agents SDK:在你的应用内运行循环
Agents SDK 把智能体的运行循环放在你自己的应用内部执行。这意味着工具调用、agent 之间的任务交接(handoffs)、状态管理策略以及审批流程(approvals)都由开发者自己掌控。
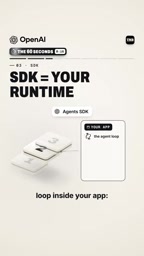
这种模式适合希望保留对执行流程完全掌控、但又不想从零开始搭建一切的团队。它在控制与便利之间取得了中间平衡——框架帮你处理了循环机制,但关键的编排决策仍握在你手里。
"运行循环"(agentic loop)是智能体架构中的核心概念,指模型在完成任务过程中反复执行"感知—决策—行动"的迭代过程:模型接收输入,决定是否调用工具,获取工具返回结果,再将结果纳入上下文继续推理,直至任务完成或满足终止条件。这个循环的管理涉及相当多的工程细节,包括如何追踪对话历史、何时截断上下文、出错时是否重试、多个 agent 之间如何传递控制权(handoffs)等。Agents SDK 的价值正在于将这套循环机制抽象封装,让开发者只需关注业务逻辑——定义工具、编写 handoff 规则、配置审批节点——而无需从头实现循环调度本身。
Agents API:托管式的完整方案
Agents API 走的是另一个极端:它运行一个托管的 codex harness,提供持久会话(durable sessions)、编排(orchestration)、上下文压缩(compaction)和故障恢复(recovery)等能力。换句话说,大量原本需要工程团队自行实现的运行时能力,都被平台直接接管了。
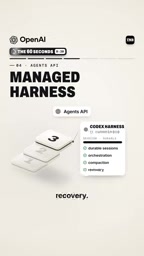
它的优势相当明显:出色的工具集成能力、沙箱环境、成熟的多智能体协作模式,以及极低的运行时管道搭建成本。对于想快速落地复杂通用型智能体的团队来说,这是最快捷的路线之一。
需要权衡的代价
便捷性从来不是免费的。Agents API 的主要权衡在于托管运行时的耦合——你的应用会与 OpenAI 的托管运行时深度绑定。
更关键的是数据合规层面的限制:Agents API 目前仅支持美国数据驻留(US residency only),并且不符合 ZDR(Zero Data Retention,零数据保留)资格。对于有严格数据控制和合规要求的企业,这两点可能是硬性门槛。
ZDR(Zero Data Retention,零数据保留)是 OpenAI 面向企业合规场景提供的一项数据处理承诺:在 ZDR 模式下,用户发送的请求内容和模型返回的响应不会被 OpenAI 留存用于任何目的(包括模型训练或安全审查之外的用途),数据在处理完毕后立即丢弃。这对金融、医疗、法律等高度监管行业尤为关键,因为这些行业的数据合规要求往往明确禁止敏感信息在第三方系统中留存超出必要时长。Agents API 当前不支持 ZDR,意味着在托管运行时处理过程中产生的数据可能按 OpenAI 标准策略保留,企业在使用前需评估这是否与自身的隐私协议、监管要求或客户合同条款相符。
如何选择适合的层级
归纳来看,三种方式对应三种不同的工程哲学:
- Responses API:追求最大控制,愿意自建逻辑的团队
- Agents SDK:希望在应用内保留编排控制权,同时省去底层循环实现
- Agents API:追求最快落地、最低运行时负担,且数据合规约束可接受
选型的核心判断标准其实是一个问题:你的数据控制需求是否与托管方案兼容? 如果数据驻留和保留策略能够满足要求,Agents API 是通往复杂通用智能体最快的路径之一;如果不能,则需要退回到 SDK 或 API 层级,用额外的工程投入换取更强的掌控力。
对于正在规划 Agent 架构的团队而言,提前识别自己所处的约束条件——合规、控制粒度、工程资源——比急于动手更重要。选对层级,才能避免后续被不必要的工程复杂度拖累。
相关推荐

Claude Sonnet 6疑泄露,Anthropic内部模型加速惊人
Anthropic疑似泄露Sonnet 6,Meter报告称其AI研发加速1.9倍;OpenAI发布GPT-6 Cyber,GPT-6.2 Astra或将至;Google Gemini Omni 1.2 Flash登顶视频生成榜;Meta stealth模型与实时头像亮相;市场波动下Google仍投170亿美元建数据中心。

科幻小说对AI的预测有多准?
科幻小说对AI的预测有多准?本文结合Hacker News讨论,分析科幻作品在AI发展中的远见与盲区,探讨其真正价值在于启发思考而非精准预测。

SwarmEvolve:潜空间智能体集群加速进化搜索
SwarmEvolve框架让数百个低成本智能体在潜空间中集群推理,通过KV缓存共享信息,在数学发现和科学计算问题上实现快速进化搜索,中位数仅3-8分钟达到其他框架60分钟的最佳分数。