OpenAI组建数学与AI顾问团:为AI成果把关

OpenAI设立独立数学顾问团,对AI数学成果进行第三方评审与传播把控。
OpenAI宣布与一个独立的"数学与人工智能顾问团"合作,职责覆盖AI数学成果的技术评审与对外传播两个环节。数学因具有明确的对错标准,既是衡量AI推理能力的理想基准,也是最容易被过度宣传的领域——近年来多起AI"解决"数学难题的报道后来被证明存在评测瑕疵。引入外部数学专家,旨在发布前核查方法严谨性并规范表述口径,弥合工业界快速迭代与学术界严谨验证之间的鸿沟。目前顾问团成员、运作方式与评审标准均未公开,其实质效果仍有待观察。
OpenAI设立独立数学与AI顾问团
OpenAI宣布正与一个独立的"数学与人工智能顾问团"(Advisory Group on Mathematics and Artificial Intelligence)展开合作,用以指导新兴AI成果的评审与对外传播。这一举措虽然公开信息有限,但其背后反映出AI研究机构在面对日益复杂的模型能力时,正在建立更严谨的第三方审查机制。
随着大型语言模型在数学推理、定理证明等高难度任务上不断刷新表现,如何客观、准确地评估并向公众传达这些结果,成为一个绕不开的问题。OpenAI选择引入独立顾问团,正是希望在成果发布环节增加一层专业把关。
为什么数学领域需要独立评审
数学是检验AI推理能力的一块"试金石"。与开放式的自然语言生成不同,数学问题往往有明确的对错标准,这既让它成为衡量模型能力的理想基准,也让任何夸大或误读的风险变得格外敏感。
近年来,业界不乏关于AI"解决"某类数学难题的报道,但其中部分结论后来被证明存在评测方法上的瑕疵,或对结果的表述过于乐观。一个由数学专家组成的独立顾问团,可以在结果对外公布前,帮助核查方法的严谨性、界定成果的真实边界,避免过度宣传。
评审与传播并重
值得关注的是,OpenAI明确指出该顾问团的职责同时覆盖"评审"(review)与"传播"(communication)两个环节。这意味着顾问团不仅参与技术层面的结果核验,还会介入成果如何被表述和公开的过程。在AI能力被频繁热炒的当下,这种对传播口径的把控,有助于让公众获得更准确的认知。
近年来典型的评测争议包括:部分模型被宣称"解决"了国际数学奥林匹克(IMO)题目,但仔细审查后发现模型答案存在逻辑跳跃,或依赖训练集中泄露的题目变体。另一类常见问题是"污染"(data contamination)——当测试题目已出现在预训练语料中,模型的高分表现更接近记忆而非推理。这些案例说明,仅凭基准分数难以判断模型是否真正掌握了数学推理能力,需要具备领域专业知识的人类专家对解题过程逐步核查,而非只看最终答案是否正确。
独立性意味着什么
"独立"(independent)是这条消息中的关键词。相比企业内部的自我评估,外部专家团队在利益关系上更为中立,其结论也更具公信力。这种做法在学术界并不陌生——同行评审正是科学研究可信度的基石之一。
将类似机制引入企业AI研究,某种程度上是在弥合工业界快速迭代与学术界严谨验证之间的鸿沟。对于OpenAI这类处于舆论焦点的机构而言,主动接受外部监督,也是重建和维护外界信任的一种策略。
学术界的同行评审(peer review)通常由期刊编辑邀请匿名专家,对论文的方法、数据和结论进行独立审核,是科学知识被认可为可信的核心程序。企业AI研究的发布节奏远快于学术期刊,且商业利益可能影响结果呈现方式,因此外部独立顾问团可视为一种"轻量化同行评审"的替代机制。其有效性高度依赖顾问的真实独立性(无利益冲突)、评审结论是否公开透明,以及顾问团是否拥有实质否决或修改发布内容的权力,而非仅充当背书角色。
对行业的潜在影响
如果这一模式运行良好,可能会为其他AI实验室提供参考。当模型能力逐渐逼近甚至在特定领域超越专业人类水平时,缺乏独立验证的"成果宣称"将越来越难以令人信服。建立面向特定学科的专家顾问机制,或将成为前沿AI成果发布的一种新范式。
需要说明的是,目前OpenAI公开的信息仍相当有限,顾问团的具体成员、运作方式与评审标准均未详细披露。这些细节将决定该机制究竟是实质性的质量保障,还是象征性的公关举措。后续进展值得持续观察。
相关推荐
用Claude Code写代码,先考了个网管:AI编程的配置之痛
Claude Code被吐槽配置门槛高:看八个教程一行代码没写,先被账号、网络、地区限制绕晕。本文分析AI编程工具的配置之痛、远程Mac mini方案的思路与边界,以及开发者该如何务实选择。
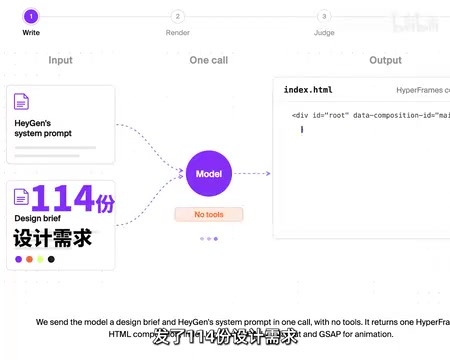
27款模型代码写视频实测:Claude Opus 5.5登顶,性价比之王竟是它
Artificial Analysis 的 Code2Video Benchmark 让27款模型用纯代码写HTML视频,Claude Opus 5.5 以1536分登顶,GPT 6.1 用约十分之一成本排名第四,揭示AI视频生成的审美与性价比之争。
Jev实战:用单次Prefill替代逐token解码的决策模型
拆解Jev推理范式:跳过逐token解码,仅用一次prefill前向传播输出选择、序数评分与布尔判断。对比编码器与解码器两条实现路线,解析多问题掩码设计、重复token陷阱,以及RLCD结合GRPO的概率校准训练方法。