OpenCode遭大规模攻击:蒸馏攻击与AI安全新税
OpenCode 遭蒸馏攻击,1.4% 用户受损,揭示 AI 安全正成为百万美元级固定成本。
开源 AI 编程助手 OpenCode 确认遭遇大规模蒸馏攻击,影响 1.4% 的 Console 用户,部分用户损失数百至上千美元。攻击者通过窃取可信账号,批量调用 Claude 等强模型获取输出与思维链,用于训练更小的模仿模型,手法包括伪装调试会话和翻译任务。OpenCode 不得不 24/7 运行 AI 安全代理防御,日成本数千美元,年成本可达百万美元级别。OpenAI 提供 Daybreak Blue 蓝队模型协助防御,但事件定性及蒸馏行为的道德性仍存争议。事件表明 AI 安全正从可选项变为企业固定成本。
事件回顾:OpenCode Console 遭大规模攻击
据 YouTube 科技频道报道,开源 AI 编程助手 OpenCode 在社交媒体上确认了一起安全泄露事件,称其遭遇了「大规模蒸馏攻击」,影响了 1.4% 的 OpenCode Console 用户。OpenCode Console 是用于部署团队级策略、控制行为、跟踪用量和预算的管理平台,带有明显的企业级属性。
事件曝光后,多位用户报告了数百至上千美元的经济损失。Anthropic、OpenAI 甚至 Google 均表示正在与 OpenCode 合作处理后续事宜。Google 尤其积极,主动联系使用 Gemini 的受影响用户,承诺 5 到 10 个工作日内通过 Google Cloud Billing Support 提供反馈。这种多方联动的响应速度,侧面印证了事件的严重性。
什么是蒸馏攻击?为何防不胜防
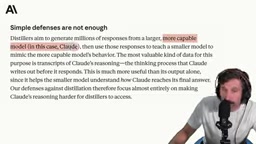
蒸馏攻击的核心逻辑并不复杂:攻击者通过大量调用能力更强的大模型(如 Claude),收集其输出乃至推理过程,再用这些数据训练一个更小的模型,使其模仿大模型的行为。Anthropic 对此的定义被广泛引用——蒸馏者希望生成数百万条响应,不仅获取最终答案,更想拿到模型得出答案的思维链。
据 OpenCode 方面的解释,攻击者并非直接注册新账号,而是先窃取一批「干净」的、已有信任历史的账号,再用这些账号发起蒸馏请求。由于账号本身可信,攻击可以持续一段时间才被检测和封禁。Anthropic 曾公开过一些真实的攻击提示词,例如伪装成调试会话要求模型「逐字输出推理过程」,或假扮翻译任务要求将「工作记忆」转写为日语片假名。这些手法一度奏效,直到平台加强日志审查。
模型蒸馏(Model Distillation) 是一种模型压缩与知识迁移技术,最早由 Hinton 等人在 2015 年提出。其原理是训练一个参数量较小的「学生模型」,使其输出分布尽可能逼近参数量大、能力强的「教师模型」。传统蒸馏通常需要访问教师模型的完整输出概率(logits),但在黑盒 API 场景下,攻击者只能获得最终文本,于是演变为「黑盒蒸馏」——用大量输入输出对做指令微调。
蒸馏本身是中性的技术手段,被广泛用于把大模型能力迁移到端侧小模型。争议在于:未经授权、通过批量调用商业 API 收集数据来训练竞争模型,可能违反服务条款,并被认为是对模型提供方研发投入的搭便车。这也是「蒸馏攻击」一词带有价值判断色彩的原因。
思维链(Chain-of-Thought, CoT) 指模型在给出最终答案前生成的中间推理步骤。OpenAI 的 o 系列、DeepSeek广告-R1 等推理模型会显式输出这类过程,而部分商业 API 出于安全考虑会隐藏或摘要化原始推理内容。
对蒸馏者而言,思维链的价值远高于最终答案:它把「如何得到答案」的过程也暴露出来,使小模型不仅模仿结论,还能模仿解题路径,从而在数学、代码等任务上获得更强泛化。这正是攻击者伪装调试会话、要求「逐字输出推理过程」的动机,也是平台加强日志审查、限制推理内容暴露的直接原因。
防线成本:每年百万美元的「AI 安全税」
OpenCode 方面在受访时透露,现代攻击高度自动化、并行化,会扫描所有可能的漏洞并快速跳转,人力防御已不现实。团队不得不 24/7 运行 AI 安全代理,持续摄入信号以尽早发现攻击。这套系统每天至少花费数千美元,按此估算年成本可达百万美元级别。
这引出了一个更广泛的行业问题:当攻击者使用前沿模型发起攻击时,防守方也不得不使用同等甚至更强的模型来对抗。对于任何有一定规模的公司,这意味着一笔持续的安全支出。有观点认为,这正在形成一种隐性的「AI 安全税」——无论是否直接采购某家厂商的服务,企业都不得不为模型安全能力付费。
AI 安全代理(AI Security Agent) 指由大模型驱动的自动化防御系统,能够持续摄入登录日志、API 调用模式、提示词内容等信号,实时识别异常行为并做出响应。与传统基于规则的 WAF 或风控系统相比,它的优势在于能理解语义层面的攻击意图,例如识别伪装成翻译或调试的越狱提示词。
但其代价也显而易见:需要持续调用模型进行推理,产生高昂的 token 费用;同时攻击者可以并行发起海量试探,防守方必须以同等甚至更高的吞吐量应对。这种「用模型对抗模型」的军备竞赛,正是安全成本从一次性投入转变为持续性运营支出的根源。
多方响应与争议焦点
事件中,OpenAI 向 OpenCode 提供了名为 Daybreak Blue 的蓝队安全模型,用于增强防御。但并非所有人都对此买账。有评论质疑「蒸馏攻击」的定性是否准确,认为这更像是一起典型的凭证泄露和滥用事件。同时,关于蒸馏行为本身的道德讨论也被重新点燃——部分人指出,大型模型训练数据本身便涉及对全网知识的「蒸馏」,此时指责他人蒸馏存在双重标准。
据多个来源交叉印证,受影响账号确实因「蒸馏行为」被 Anthropic 和 OpenAI 封禁,平台方在封禁时向用户发送了相关通知。OpenCode 表示,公开这一细节是因为用户已先收到平台邮件,隐瞒反而会造成混乱。
对开发者和企业的启示
这起事件揭示了 AI 时代安全的新常态:攻击面从传统系统扩展到模型调用链路,凭证管理、用量监控和异常检测需同步升级。对于使用第三方 AI 服务的企业,建议建立独立的 API 密钥轮换机制,设置用量上限告警,并关注服务商的安全通告。对于工具提供方,OpenCode 的经历表明,企业级功能(如团队策略和预算控制)在提升便利性的同时,也可能成为攻击者的跳板,安全设计需要前置而非事后补救。
更深层的影响在于,AI 安全正在从「可选项」变为「固定成本」。无论这一成本最终由厂商、企业还是终端用户承担,围绕模型能力的攻防博弈都将长期存在。
凭证泄露与账号接管(Account Takeover, ATO) 是本次事件中值得单独理解的风险类型。攻击者并不注册新账号,而是通过撞库、钓鱼、恶意软件或第三方泄露数据获取已有账号的登录凭证。由于这些账号带有正常的历史行为和信任积累,基于信誉的风控模型往往难以在早期识别异常。
对企业而言,防御重点应放在:强制多因素认证、短周期密钥轮换、按最小权限原则分配 API 密钥,以及对单账号调用量和调用模式设置基线告警。这也解释了为何评论者认为事件本质更接近凭证滥用而非单纯的「蒸馏攻击」——定性不同,对应的防御优先级和责任人也会不同。
相关推荐
TikTok官方MCP服务器上线:AI助手可直管广告账户
TikTok推出官方MCP服务器,AI助手可接入广告账户完成报告查询、预算调整和广告创建。本文解析MCP协议原理、400个工具的能力边界,以及广告学习期和预算风险下的安全使用策略。
美国大行封杀AI代理:你的钱,AI不能碰?
摩根大通、花旗、美国银行、嘉信理财等美国大行据报封堵AI代理访问客户账户。本文分析银行封杀AI代理的原因、身份边界问题,以及对AI理财助手落地的影响。

AI Agent安全实战手册:防注入、防MCP投毒与零点击泄露
AI Agent安全实战指南:从致命三要素与提示注入原理出发,结合Copilot零点击泄露、Slack AI、MCP投毒、恶意NPM包、Glassworm隐形字符与OAuth供应链攻击六起真实案例,给出最小权限、沙箱、默认拒绝、出口监控等九层防御控制,以及个人、团队、企业三档落地路线与事件响应第一个小时清单。