Pauta:完全离线的私人会议记忆库

Pauta 主打全程离线的会议转写与摘要,用本地处理换取数据控制权。
Pauta 是一款在 Product Hunt 上曝光的 AI 会议记录工具,核心差异在于架构:录音转写、摘要生成和行动项提取全部在本地设备完成,数据不上传云端,仅在用户主动选择时才连接外部 AI。它覆盖会议、访谈、语音笔记三类场景,但原文未披露所用模型、转写准确率和支持语言等关键参数。其“可选云端 AI”开关允许用户按内容敏感度分级处理,兼顾隐私与质量。文章指出,本地化 AI 工具受合规压力和端侧算力进步双重驱动,但面临性能与迭代速度的天花板。产品目前处于早期阶段,社区反馈样本仅 5 条评论,实际质量与稳定性仍需验证。
Pauta:你的每场对话,都有私人记忆
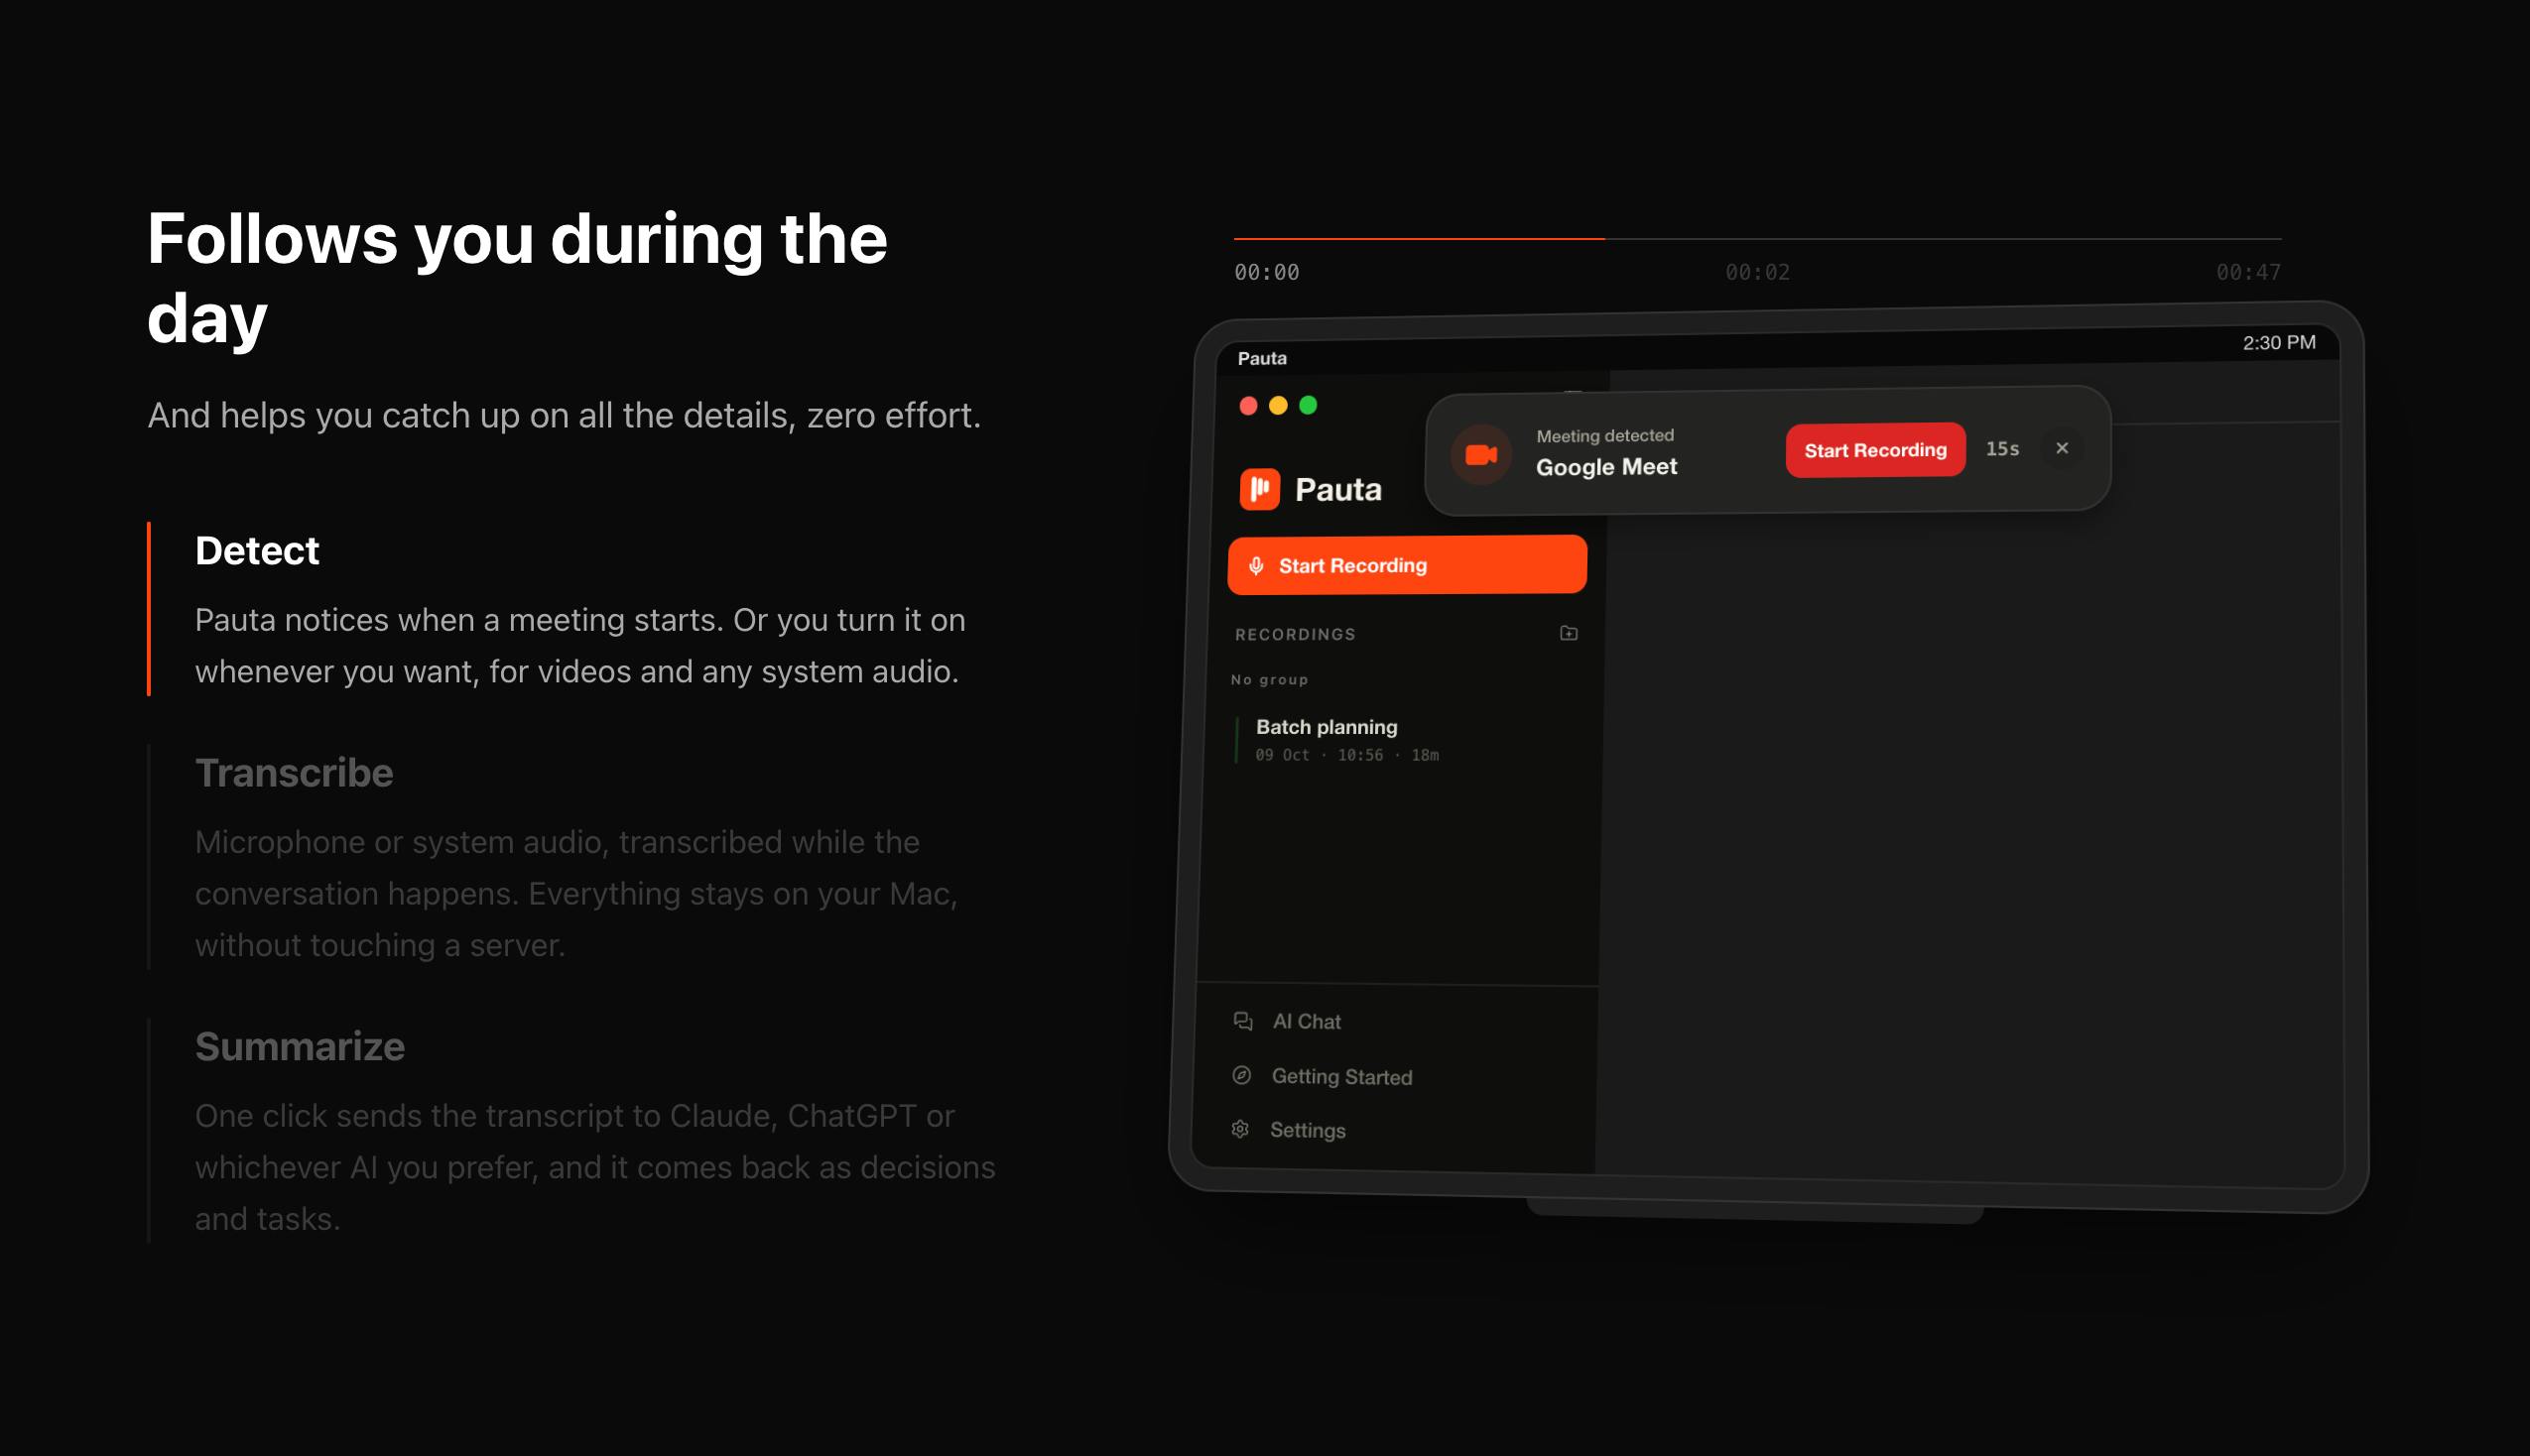
在AI会议记录工具普遍依赖云端处理的当下,Product Hunt上出现了一款反其道而行之的产品——Pauta。它的主张很直接:记录、转写会议、访谈和语音笔记,并提炼摘要与行动项,但全程离线运行,数据只留在你的设备上,只有你主动选择时才连接外部AI。
这款产品在Product Hunt获得66票支持、5条评论,排名当日第11位,归类于隐私、人工智能与音频三个方向。对于在意数据主权的用户来说,这个定位本身就值得关注。
离线优先,把隐私当作产品架构
Pauta最核心的差异点不是功能列表,而是架构选择。绝大多数同类工具的工作流是:录音上传云端 → 服务端转写 → 大模型生成摘要 → 结果回传。这条链路意味着你的会议内容至少经过第三方服务器一次,甚至可能被用于模型训练。
Pauta把这条链路整体搬到了本地。转写和摘要生成在设备上完成,数据不出设备。官方描述中明确写道"works fully offline",并且"only connects to external AI if you choose"——外部AI是可选增强项,而非必经环节。
这种设计思路解决的是一个真实痛点:企业会议、医生访谈、律师咨询、媒体采访,这些场景的音频内容往往涉及商业机密或个人信息,很多组织根本不允许把录音上传到外部服务。Pauta给出的答案是,与其在隐私政策上做文章,不如让数据物理上不离开设备。
端侧推理(On-device Inference) 是理解 Pauta 架构的关键概念。它指在用户设备(手机、笔记本)本地运行 AI 模型完成计算,而非将数据发送到云端服务器。其技术基础包括模型量化(将大模型压缩到设备可承载的规模)、专用推理框架(如 llama.cpp、ONNX Runtime、Core ML)以及利用 NPU/GPU 的硬件加速。端侧推理的最大优势是数据不出设备,天然满足隐私与合规要求;代价是模型规模受限、推理速度依赖设备性能,复杂任务的质量通常低于云端大模型。Pauta 将转写与摘要放在本地执行,正是端侧推理的典型应用。
转写、摘要、行动项:一条完整的本地流水线
从功能上看,Pauta覆盖了会议记录工具的标配三件套:
- 录音与转写:处理会议、访谈、语音笔记三类输入场景。
- 摘要生成:把长对话压缩成可快速浏览的要点。
- 行动项提取:从对话中识别待办事项,这是会议工具真正产生工作价值的一环。
区别在于这三步都在本地执行。原文没有披露具体使用的转写模型或摘要模型,也没有给出准确率、支持语言数量等参数,因此无法判断其转写质量与云端方案的实际差距。考虑到本地算力通常弱于云端GPU集群,转写精度和长音频处理速度可能是需要实际测试才能确认的变量。
你可能没注意到,Pauta保留了"可选连接外部AI"的开关。这意味着用户可以按场景分级:涉密内容纯本地处理,非敏感内容调用更强的云端模型换取质量。这种混合策略比纯粹的二选一更务实。
语音转写(Speech-to-Text, ASR) 是把音频信号转换为文字的技术,主流方案已从传统声学模型转向端到端神经网络(如 Whisper 系列及其蒸馏、量化版本)。评价转写质量的核心指标是词错误率(WER),而影响 WER 的因素包括口音、背景噪声、专业术语和多说话人重叠。云端方案通常使用大参数量模型并配合说话人分离(diarization),本地方案则需在模型大小与准确率之间折衷。行动项提取 属于信息抽取任务,通常由大语言模型从转写文本中识别“谁在什么时间前完成什么事”,其准确性高度依赖转写文本的质量和上下文理解能力。原文未披露 Pauta 采用的具体模型,因此这些指标只能通过实测评估。
隐私AI工具正在形成一条独立赛道
Pauta的出现并非孤例。从本地运行的大语言模型,到端侧推理的语音助手,"数据不出设备"正在从极客玩具变成一类明确的产品主张。驱动因素有两个层面:
合规压力。各地区的个人信息保护法规对数据跨境、第三方处理提出了越来越细的要求,企业采购工具时开始把数据流向作为硬性门槛。
算力下沉。终端设备的推理能力持续增强,让过去必须依赖云端的转写和摘要任务有了本地化的可能。Pauta这类产品的可行性,本质上建立在端侧算力进步之上。
不过这条赛道也有明显的天花板。本地处理意味着无法享受云端大模型的规模优势,功能迭代速度、多语言覆盖、复杂场景鲁棒性都可能落后。Pauta能否在"足够私密"和"足够好用"之间找到平衡点,决定了它能否从隐私细分市场走向主流。
数据跨境与第三方处理 是隐私合规中的核心概念。以欧盟 GDPR 为例,个人数据转移到境外或交由第三方处理者处理,需满足特定法律条件并签订数据处理协议;医疗、法律等行业的录音还可能构成敏感个人信息,处理门槛更高。这意味着企业采购会议记录工具时,不仅要看隐私政策措辞,还要审查数据流向、存储位置和保留期限。Pauta“数据物理上不离开设备”的设计,直接绕开了第三方处理和跨境传输的合规链条,这也是它对受监管行业用户具有吸引力的结构性原因。
谁应该关注Pauta
从产品定位看,Pauta的目标用户画像比较清晰:对数据流向敏感的专业人士和小团队。典型场景包括需要保密的商业会议、涉及个人隐私的访谈记录、以及不方便上传云端的语音备忘。
对于普通用户,如果只是记录日常会议且不在意云端处理,成熟云端工具在转写准确率和协作功能上大概率更有优势。Pauta的价值主张是取舍:用可能的性能妥协,换取确定的数据控制权。
产品目前处于Product Hunt早期曝光阶段,评论数仅5条,社区反馈样本还很小。转写质量、本地资源占用、长会议稳定性这些关键指标,还需要更多真实使用数据来验证。对于隐私优先的会议记录需求,它是一个值得列入候选清单的新选项,但下定论还为时过早。
相关推荐
 科技前沿
Caro揭秘:LBJ如何用伪装骗过种族隔离派
罗伯特·卡罗在LBJ传记中记录前参议员塔尔梅奇的采访:约翰逊初入参议院时刻意迎合南方保守派,塔尔梅奇称未察觉其民权倾向。掌权后约翰逊推动1964年民权法案与1965年投票权法案,揭示政治伪装与改革时机的关系。

Commodore 64经典赛车游戏迎来Driver AI
探索Commodore 64经典赛车游戏《Stunt Car Racer》中的Driver AI实验,了解在资源受限的8位平台上实现自动驾驶AI的技术挑战与启示。

黄仁勋若被替换,开源AI会否生变?Reddit激辩
Reddit网友激辩:如果黄仁勋被替换,英伟达会反对开源AI吗?讨论指出英伟达支持开源AI源于商业利益,需拓宽GPU客户群,而非一人决策。