Perplexity开源pplx-embed-v2-late:文本图像多向量嵌入模型
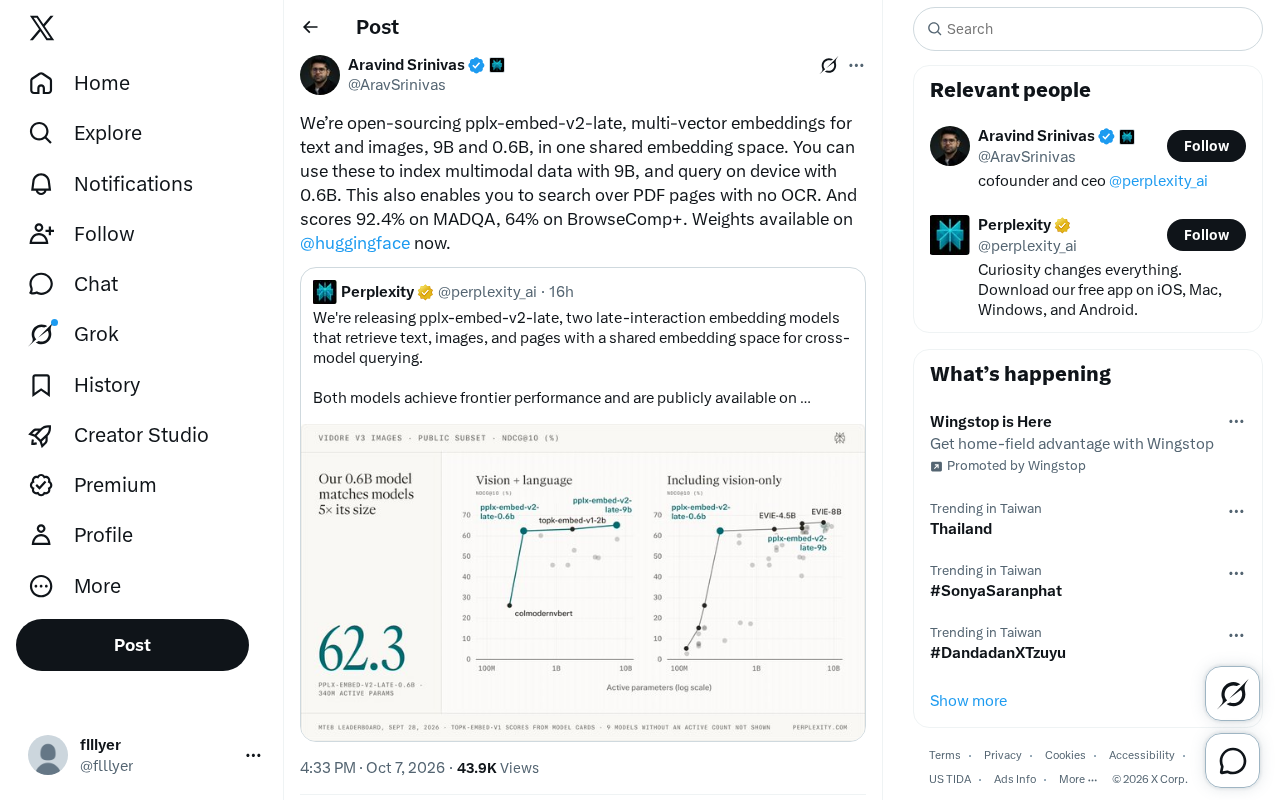
Perplexity开源多模态多向量嵌入模型,支持图文统一检索与免OCR的PDF页面搜索。
Perplexity开源了多向量嵌入模型 pplx-embed-v2-late,提供 9B 和 0.6B 两种规模,两者共享同一嵌入空间,分别承担离线建库与端侧查询两端,形成兼顾精度与部署成本的非对称检索架构。模型采用 late interaction(延迟交互)技术路线,为文档保留 token 级别的多向量表示,在召回精度上优于传统单向量方案,并将这一范式扩展至图文多模态场景。其关键能力之一是无需 OCR 即可直接检索 PDF 页面,保留图表、版面等视觉信息,减少因文本转换导致的语义损失。官方公布的基准成绩为 MADQA 92.4%、BrowseComp+ 64%,权重已在 Hugging Face 开放,可直接用于构建多模态 RAG、文档搜索等应用。
Perplexity宣布开源其多向量嵌入模型 pplx-embed-v2-late,将文本与图像统一到同一个共享嵌入空间中。该模型提供 9B 和 0.6B 两个版本,权重已上线 Hugging Face,面向需要构建多模态检索系统的开发者与研究者。
一次发布,两种规模:9B索引 + 0.6B端侧
这次开源最值得关注的设计,是用两种不同参数规模的模型覆盖检索链路的两端。9B 大模型负责对多模态数据进行索引(indexing),承担计算量更大、精度要求更高的离线建库工作;0.6B 小模型则定位为端侧查询(query on device),可以直接在用户设备上运行,降低延迟和对云端的依赖。
由于两个模型共享同一个嵌入空间,用 9B 建立的索引可以直接被 0.6B 的查询向量检索命中。这种「大模型建库、小模型查询」的非对称架构,兼顾了检索质量与部署成本,也为移动端、边缘设备上的多模态搜索提供了现实可行的路径。
这种非对称的「大模型建库、小模型查询」架构在信息检索领域有成熟的先例。其可行性依赖于一个前提:两个模型必须被联合训练或蒸馏,使其输出向量落在同一度量空间(metric space)内,否则小模型产生的查询向量与大模型建立的索引向量之间的距离计算将失去语义意义。实践中通常通过知识蒸馏(knowledge distillation)或对比学习(contrastive learning)的共同目标函数来对齐两端的表示空间。这一设计对端侧部署尤为关键:用户设备上只需加载 0.6B 的查询编码器,而承载海量文档的索引库可以由云端使用 9B 模型预先构建好,查询时仅做向量检索而无需重新编码文档,极大降低了端侧的算力与内存占用。
免OCR的PDF页面检索
pplx-embed-v2-late 的一个关键能力是无需OCR即可检索PDF页面。传统的文档检索流程通常依赖OCR先把扫描件或图片型PDF转成文本,再做索引,这一步既容易引入识别错误,也会丢失版面、图表等视觉信息。
而多向量嵌入直接把PDF页面作为图像处理,将视觉内容映射到与文本相同的嵌入空间,意味着图表、公式、排版布局等信息都能被纳入检索范围。对于包含大量图片、表格的技术文档、财报、论文而言,这种方式理论上能保留更多原始语义,减少因OCR失真导致的检索遗漏。
传统 OCR 管线的局限不仅在于识别错误率,更在于其本质上是一种信息降维:将二维的视觉排版压平为线性文本流,表格的行列关系、公式的上下标层级、图表与说明文字的空间对应关系在这一过程中往往被破坏或丢失。近年来以 ColPali 为代表的「视觉检索」方案直接将文档页面渲染为图像,交由视觉语言模型(VLM)提取 patch 级别的多向量表示,绕过 OCR 步骤。pplx-embed-v2-late 采用类似思路,本质上是把 PDF 页面视为一张图片送入视觉编码器,再与文本查询在共享嵌入空间中做相似度匹配。这意味着模型需要具备足够强的视觉文字理解能力(即 OCR-free 的文本感知),以及跨模态语义对齐能力,这也是该模型训练难度显著高于纯文本嵌入模型的核心原因之一。
基准成绩:MADQA 92.4%,BrowseComp+ 64%
根据官方公布的数据,该模型在 MADQA 上取得 92.4%,在 BrowseComp+ 上达到 64%。MADQA 侧重多模态文档问答场景,高分表明模型在跨文本与图像的语义对齐上有不错表现;BrowseComp+ 则更贴近真实网页浏览式检索任务,考验模型处理复杂、开放式查询的能力。
需要说明的是,这些成绩来自厂商自测,缺乏第三方横向对比,具体表现仍需社区在真实业务数据上进一步验证。不过对于一个同时开放权重的模型来说,这类公开基准至少提供了可复现的参考起点。
多向量嵌入与「late interaction」的含义
模型名称中的 late(late interaction,延迟交互)透露了其技术路线。与把整段内容压缩成单个向量的传统嵌入不同,多向量嵌入为文档保留多个token级别的向量,在检索时让查询向量与文档的多个向量进行细粒度匹配。
这类方法(类似 ColBERT 的思路)通常能在召回精度上优于单向量方案,尤其适合长文档、图文混排等信息密度高的场景,代价是索引存储和计算开销更大。pplx-embed-v2-late 把这一范式扩展到了图文多模态,是其区别于普通文本嵌入模型的核心所在。
ColBERT(Contextualized Late Interaction over BERT)是这一路线最具代表性的工作,由斯坦福大学于2020年提出。其核心思想是:查询端和文档端各自独立编码,生成 token 级别的向量序列,而非单一的句子向量;检索时通过"MaxSim"操作——即对查询中每个 token,找到文档向量序列中与之最相似的那个,再对所有 token 的最大相似分求和——得到最终相关性分数。这种设计让模型兼顾了双塔架构的检索效率(文档向量可离线预计算)和交叉编码器(cross-encoder)的细粒度匹配精度。代价在于,每篇文档需要存储多个向量而非一个,索引体积通常是单向量方案的数倍到数十倍,对向量数据库的存储和近似最近邻搜索(ANN)性能要求更高。pplx-embed-v2-late 将这一机制延伸至图像 token,使得图像的局部区域(如图表中的特定数值、版面中的标题层级)都能参与细粒度匹配,而不是被压缩进一个全局视觉向量后丢失空间细节。
对开发者意味着什么
权重已在 Hugging Face 提供下载,开发者可以直接基于它构建多模态 RAG(检索增强生成)系统、文档搜索引擎或知识库问答应用。免OCR的PDF检索能力,对处理非结构化文档的团队尤其有吸引力;而 0.6B 端侧模型则为注重隐私、低延迟的本地检索场景打开了想象空间。
由Perplexity这样以搜索为核心业务的公司开源检索模型,本身也传递出一个信号:多模态、细粒度的向量检索正在成为下一代搜索与RAG系统的基础设施。社区接下来的复现与实测,将决定它能在多大程度上落地。
相关推荐
AI SDK 发布版本更新:sandbox-just-bash 组件信息速览
AI SDK 生态组件 @ai-sdk/sandbox-just-bash 发布 1.0.147 补丁更新,同步 @ai-sdk/harness 依赖。本文梳理该发布记录的版本信息与升级建议。
@ai-sdk/sandbox-vercel 1.0.147 发布说明
@ai-sdk/sandbox-vercel 1.0.147 版本发布,这是一次补丁级更新,主要同步升级内部依赖 @ai-sdk/harness 至相同版本,通过 GitHub 可信签名验证。
ChatGPT洗碗记:一支叉子引发的AI过度推理反思
一支洗碗机没洗净的叉子,引发AI启动"深度研究"、消耗海量算力甚至挑战纳维-斯托克斯千禧难题的荒诞实验。这则ChatGPT洗碗讽刺视频,折射出AI过度推理、算力成本与场景错配的真实困境。