#嵌入模型
共 5 篇相关文章

·9 分钟
微调嵌入模型没那么难:EmbeddingGemma 2 实战全解
EmbeddingGemma 2 开源嵌入模型支持用自己的数据微调。本文详解多重负样本排序损失、LoRA 轻量训练、按来源切分测试,以及实测如何把声音分类准确率从 25% 提升到 66%、视频字幕检索从 2/3 提升到 3/4,并揭示共享主干带来的代价与踩坑经验。
阅读全文 →
·5 分钟
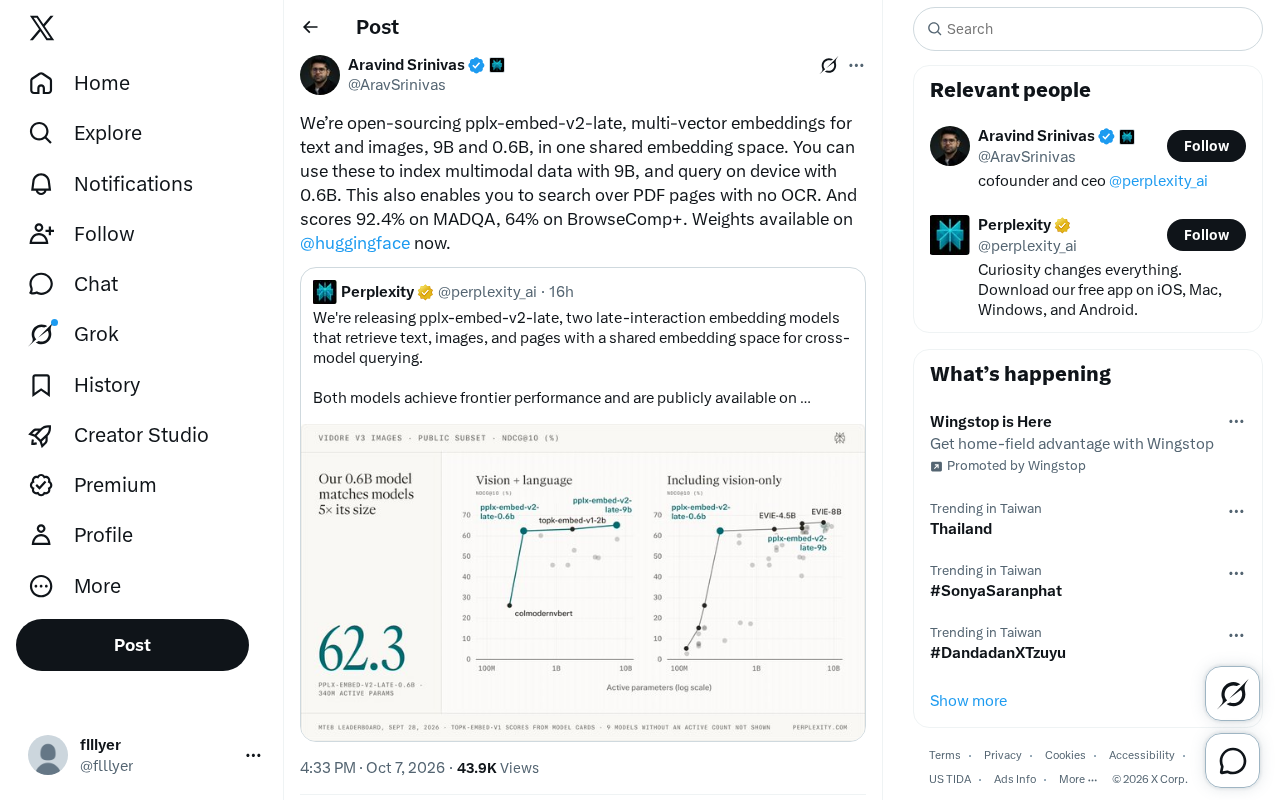
Perplexity开源pplx-embed-v2-late:文本图像多向量嵌入模型
Perplexity开源多向量嵌入模型pplx-embed-v2-late,提供9B索引版与0.6B端侧版,共享嵌入空间,支持免OCR的PDF页面检索,MADQA达92.4%,权重已上线Hugging Face。
阅读全文 →
·5 分钟
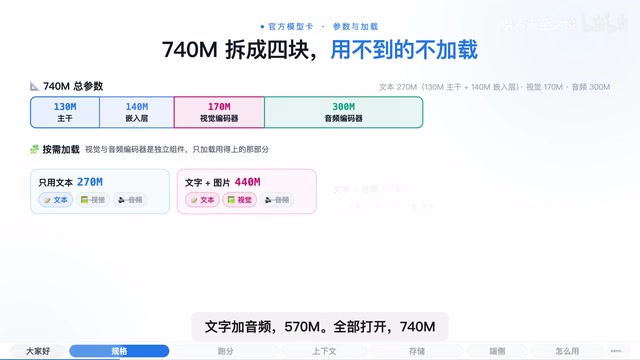
Google EmbeddingGemma 2:首个原生多模态端侧嵌入模型解析
谷歌发布 EmbeddingGemma 2,740M 参数的原生多模态端侧开源嵌入模型,支持文字、代码、图片、音频、视频映射到同一向量空间。本文解析其模块化架构、跑分表现、8K 上下文及端侧部署要点。
阅读全文 →
·5 分钟
上下文嵌入新范式:Perplexity发布pplx-embed-v2刷新基准
Perplexity发布预览版上下文嵌入模型pplx-embed-v2-context-9b,采用在编码每个分块时纳入整篇文档的新训练方法,在ConTEB和turbopuffer私有基准context-bench上刷新最佳成绩,有望改善RAG长文档检索的信息损失问题。
阅读全文 →
·5 分钟
为什么嵌入模型偏爱1536维?揭秘维度选择背后的权衡
为什么嵌入模型(embedding)常用 1536 维?本文从 Transformer 架构继承、注意力头整除、硬件对齐以及质量与成本的权衡,解析 1536 维背后的工程逻辑与生态原因。
阅读全文 →