Perplexity押注垂直整合:Vera芯片替代x86背后的Agent基建野心

Perplexity宣布自建Agent沙箱并押注Vera架构取代x86,向基础设施层垂直整合延伸。
Perplexity近期透露其战略方向:将对智能体基础设施进行垂直整合,自建沙箱执行环境并针对Vera芯片架构深度优化,明确表示「Vera远优于x86」。公司已开始将「Perplexity Computer」部署在Vera架构上。自建沙箱让Perplexity可以针对Agent工作负载做端到端调优,摆脱对第三方云沙箱的依赖,而绑定特定芯片架构则意味着在能效比和执行性能上寻求差异化。这一动向折射出AI竞争重心的下移——当模型能力趋于同质化,执行效率与基础设施掌控力正成为新的壁垒。目前相关信息仅来自单一社媒表态,「Vera远优于x86」的具体性能数据仍待官方后续验证。
Perplexity要自建Agent基础设施
Perplexity近期在社交平台上释放了一个值得关注的战略信号:公司计划对其智能体(agentic)基础设施进行垂直整合,核心包括自建沙箱(sandbox)环境,并针对最优的底层芯片对沙箱进行深度优化。这条看似简短的表态,实则透露出一家AI应用公司正在向底层基础设施延伸的雄心。
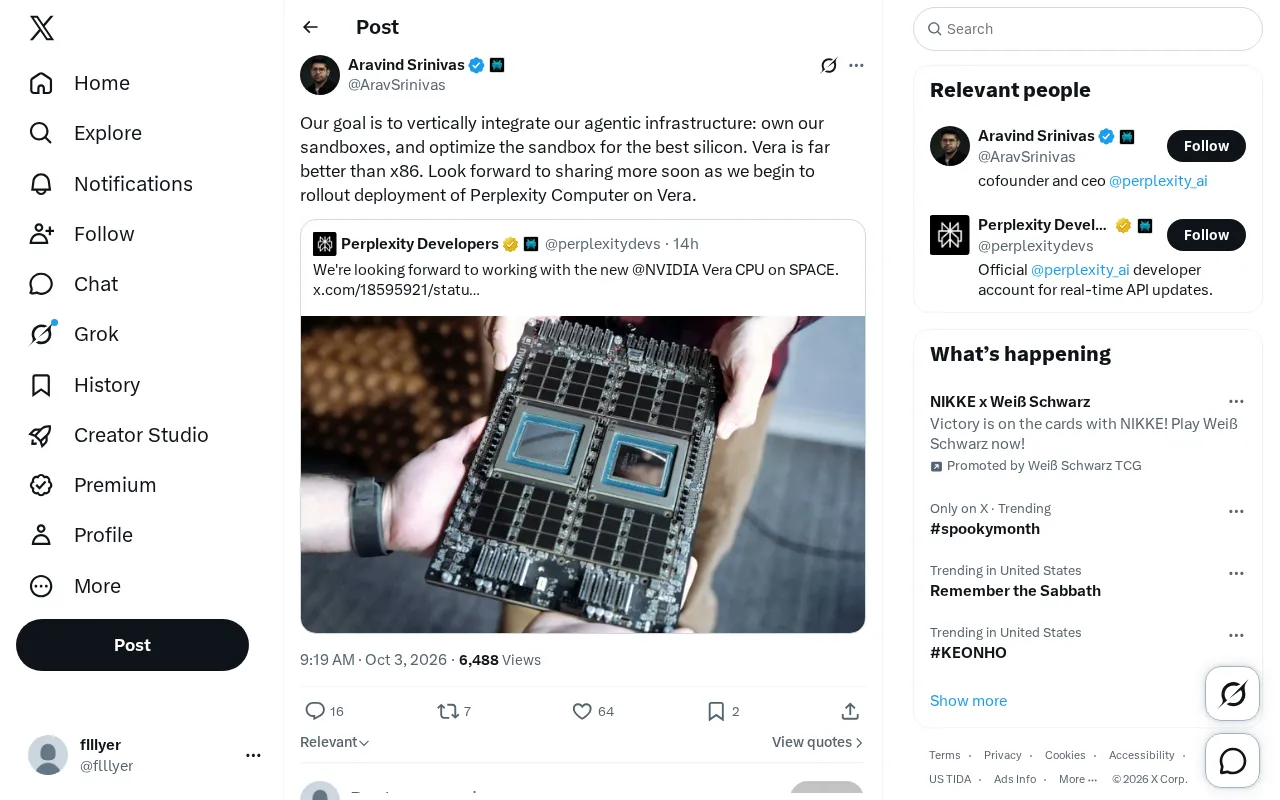
按照官方说法,Perplexity已经开始推进名为「Perplexity Computer」的部署,并将其运行在Vera架构之上,同时明确表示「Vera远优于x86」。这意味着这家以AI搜索和问答起家的公司,正在把自己的技术栈从上层应用一路打通到芯片选型层面。
为什么要做垂直整合
「垂直整合」在科技行业并不新鲜,从苹果自研芯片到特斯拉自建电池供应链,掌控更多环节往往意味着更强的性能调优能力与成本控制权。对于以智能体为核心的AI公司而言,沙箱是执行代码、调用工具、运行复杂任务的隔离环境,其性能与安全性直接决定了Agent的响应速度和可靠性。
拥有自己的沙箱意味着什么
当前许多AI应用依赖第三方云沙箱或通用计算实例来运行智能体任务。Perplexity选择「拥有自己的沙箱」,本质上是把这一关键执行层收归自控。这样做的好处在于:可以针对自身的Agent工作负载做端到端优化,减少对外部供应商的依赖,并在底层硬件选型上获得更大自由度。
对于需要频繁运行代码、调用API、处理多步任务的智能体系统来说,沙箱的启动速度、隔离开销和并发能力都是影响用户体验的关键瓶颈。自建沙箱让这些环节的优化空间被最大化。
沙箱(Sandbox)在计算机安全领域指一种隔离的执行环境,程序在其中运行时无法直接访问宿主系统的文件、网络或其他资源,从而防止恶意代码或错误操作造成破坏。在AI智能体场景中,沙箱的意义更加关键:Agent需要动态生成并执行代码、调用外部API、操作文件系统,每一步都存在不可预测的风险。目前主流的沙箱方案通常基于容器(如Docker)或微虚拟机(如Firecracker)技术,前者启动快但隔离性相对较弱,后者安全性更高但冷启动延迟更大。对于需要在毫秒级响应时间内并发处理大量Agent请求的平台而言,沙箱的启动延迟、内存开销和隔离粒度之间的权衡,直接影响系统的吞吐量和用户感知速度。自建沙箱意味着可以针对自身Agent的典型负载模式(如短时高频的代码执行、工具调用链)做专项调优,而非使用为通用云计算场景设计的现成方案。
Vera对比x86:芯片层面的押注
Perplexity在表态中直接点名「Vera远优于x86」,这是整条消息中最具信息量的部分。x86是长期主导数据中心的指令集架构,而Vera指向的是新一代、更贴合AI工作负载的硅片方案。公司强调针对「最优硅片」优化沙箱,说明它认为通用x86架构在Agent密集型负载下已不是最佳选择。
这种判断与行业大趋势一致:随着AI推理和智能体任务的计算特征与传统通用计算显著不同,越来越多厂商开始追求面向特定工作负载定制的芯片与架构。Perplexity将沙箱与特定硅片绑定优化,正是希望在能效比和执行性能上拉开差距。
Perplexity Computer的部署信号
官方提到已开始「rollout deployment of Perplexity Computer on Vera」,并承诺将很快分享更多细节。这表明相关计划已从构想进入实际部署阶段,而非停留在愿景层面。虽然目前公开信息有限,但「Perplexity Computer」这一命名本身暗示了公司可能在构建一套完整的智能体计算平台,而不仅仅是优化现有的搜索产品。
x86是由英特尔于1978年推出、后经AMD等厂商扩展的复杂指令集(CISC)架构,数十年来主导了个人电脑和数据中心服务器市场。其优势在于生态成熟、软件兼容性极强,但为了维持向后兼容性积累了大量历史包袱,在能效比上逐渐暴露短板。与之形成对比的是ARM等精简指令集(RISC)架构,以及近年来专为AI推理设计的各类定制芯片(如Google TPU、AWS Inferentia)。Perplexity提到的「Vera」目前尚无充分的公开技术资料,从上下文判断其可能指向某款基于ARM或定制ISA的服务器芯片方案。AI推理与智能体任务的计算特征与传统通用计算存在显著差异:前者高度依赖矩阵运算、内存带宽和低延迟I/O,而非x86擅长的复杂分支预测和单线程整数运算。这一计算特征的错位,正是越来越多AI公司转向非x86架构的根本动因。
这对AI行业意味着什么
一家AI应用层公司主动向基础设施和芯片层延伸,反映出当下竞争的焦点正在下沉。当上层模型能力逐渐趋同,差异化的突破口往往来自于执行效率、成本结构和基础设施的掌控力。谁能更快、更省地运行智能体任务,谁就可能在体验和经济性上建立壁垒。
提一嘴,当前这些信息主要来自Perplexity方面的单一社交媒体表态,尚缺乏独立的性能数据和第三方验证。「Vera远优于x86」是一个相当强的断言,其具体的性能对比、适用场景和实际部署规模仍有待官方后续披露。在更多细节公开前,这更应被视为一个明确的战略方向,而非已验证的技术结论。
对关注AI基础设施演进的开发者和从业者而言,值得持续跟踪Perplexity后续分享的技术细节,看它是否能把这套「从沙箱到硅片」的垂直整合愿景真正落地为可衡量的优势。
相关推荐

谷歌AMIE临床研究登上《柳叶刀》:AI问诊首次真实诊所验证
谷歌与BIDMC合作的AMIE对话式诊断AI研究登上《柳叶刀》主刊,首次在真实诊所前瞻性验证。鉴别诊断与医生吻合率达90%,75%病例帮助医生准备问诊,开创患者端AI问诊临床落地新路径。

自然语言 vs SQL:AI 驱动数据可视化的变革
探讨 AI 驱动的数据分析如何用自然语言替代传统 SQL 进行数据可视化,分析两种方式的优势、局限与融合趋势,以及对企业数据团队角色的影响。

NVIDIA Megatron Core实现位级确定性预训练解析
NVIDIA Megatron Core引入位级确定性预训练能力,让大规模模型训练在调试、验证与恢复中实现逐位可复现。本文解析位级确定性的原理、技术挑战及其对AI工程实践的意义。