PNSN实验架构引热议:模块化检索能否突破灾难性遗忘?
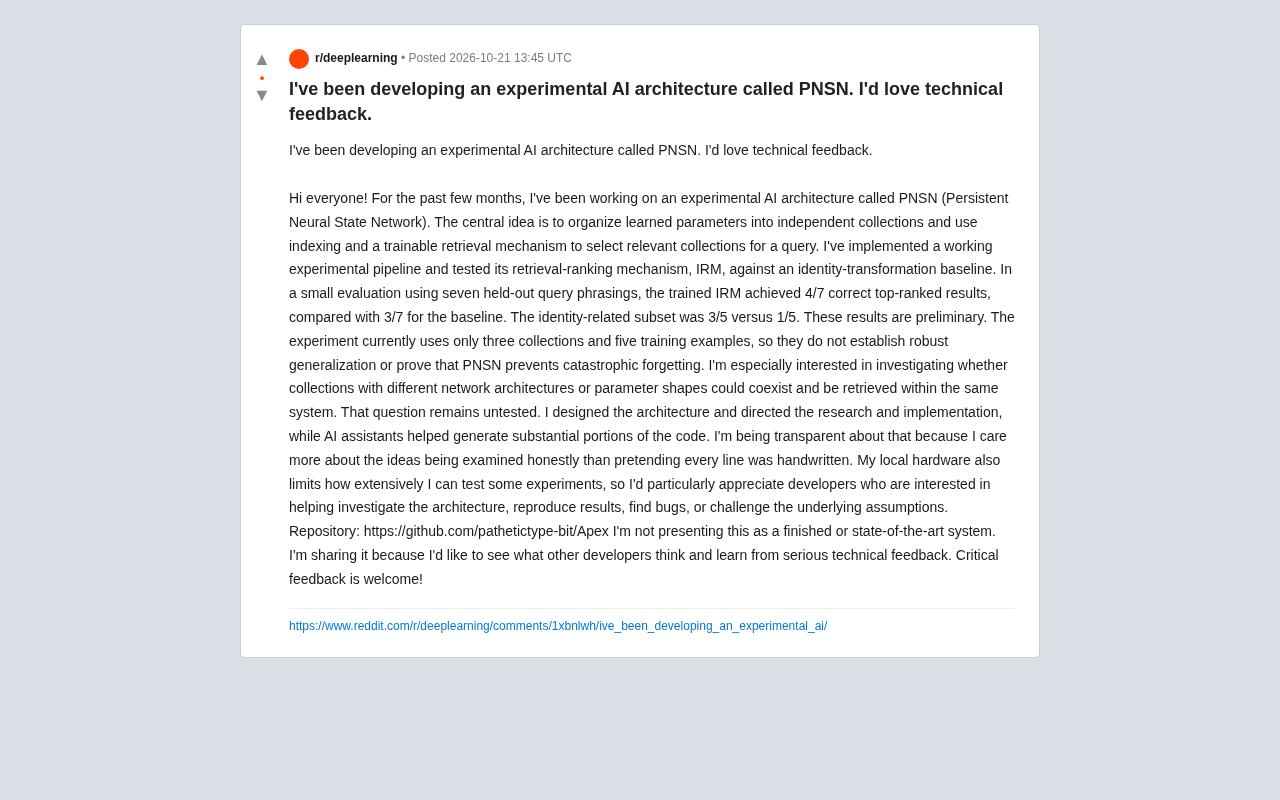
开发者公开实验性架构PNSN,用参数模块化与可训练检索对抗灾难性遗忘,初步结果微弱但引发社区对模块化网络的再审视。
开发者公开了实验性AI架构PNSN(Persistent Neural State Network),试图通过参数模块化与可训练检索机制解决大模型的灾难性遗忘问题。PNSN将学习参数组织为独立集合,每个集合专精特定知识,查询时由可训练检索机制IRM选择最相关集合参与计算,从而解耦知识存储与路由选择。初步检索实验在7个留出查询上取得4/7的top-1正确率,恒等基线为3/7,身份相关子集为3/5对1/5,但仅使用3个集合和5个训练样本,统计效力有限。开发者坦诚AI助手生成了大量代码,并因本地硬件限制邀请社区复现与挑战假设。异构集合共存与灾难性遗忘的严格验证仍是未解难题。
一位开发者公开了名为PNSN(Persistent Neural State Network)的实验性AI架构,试图通过参数模块化与可训练检索机制来解决大模型领域的顽疾——灾难性遗忘。尽管初步实验结果微弱,但这一思路引发了技术社区对模块化网络设计的重新审视。
架构核心:参数集合化与可训练检索
PNSN的基本设计并不复杂:将学习到的参数组织成独立的集合(collections),每个集合可以看作一个专精于特定知识或模式的子网络。当模型收到查询时,通过索引和可训练的检索机制(IRM)选择最相关的集合参与计算。
这种设计与当前主流的大规模单体模型形成鲜明对比。在传统Transformer中,所有参数在每次前向传播时都被激活,模型规模的增长意味着计算成本的线性攀升。PNSN试图将“知识存储”与“路由选择”解耦,让模型只调用必要的参数模块。
开发者在Reddit帖子中坦言,自己设计了架构并主导了研究与实现,但AI助手帮助生成了相当比例的代码。这种坦诚值得肯定——在AI辅助编程日益普及的当下,透明地说明工具使用边界比假装手写每一行代码更有助于技术讨论。
恒等变换基线(Identity Baseline)在检索实验中指一种不做任何学习的路由策略:无论输入查询是什么,IRM都直接返回查询本身的原始表示(或固定映射),不进行任何参数化的选择或变换。它相当于“随机猜测”或“无学习”的下限参照,用来衡量训练后的检索机制是否真正学到了有意义的集合选择能力。如果训练后的IRM仅略高于恒等基线,说明其路由决策可能主要来自输入的表面特征而非真正的语义匹配;若显著高于基线,则表明可训练检索确实捕捉到了查询与集合之间的对应关系。在样本量极小时,基线对比的统计意义有限,因此开发者强调结果仅为初步信号。
检索实验:4/7对3/7的初步信号
PNSN的核心机制IRM经过了一个小型评估:使用七个留出的查询表述,训练后的IRM在top-1结果上达到4/7正确,而恒等变换基线为3/7。在与身份相关的子集上,对比更为明显——3/5对1/5。
开发者对此保持了审慎态度:“这些结果是初步的。实验目前只使用了三个集合和五个训练样本,因此它们不能确立稳健的泛化能力,也不能证明PNSN防止了灾难性遗忘。”
这种自我限定值得认真对待。七个查询、三个集合的规模远不足以得出统计显著的结论。不过,检索机制本身的可训练性——而非固定规则路由——是一个有意义的探索方向。如果IRM能够在更大规模上学习到有意义的集合选择策略,那么模块化架构的可行性将得到实质性支撑。
未解难题:异构集合与灾难性遗忘
开发者特别提到一个尚未测试的问题:具有不同网络架构或参数形状的集合能否在同一系统中共存并被检索?
这个问题触及了模块化AI的核心矛盾。如果所有集合必须共享相同的拓扑结构,那么模块化的灵活性就受到严重限制。反之,若允许异构集合共存,检索机制需要具备跨架构的兼容能力,这远比在同构空间中选择要复杂。
至于灾难性遗忘,PNSN的假设是:独立的参数集合意味着更新某个集合时不会覆盖其他集合的知识。但这个假设需要严格的实验验证——在持续学习场景下,检索机制本身可能会发生漂移,导致原本正确的路由决策失效。
灾难性遗忘(Catastrophic Forgetting)是人工神经网络在持续学习(Continual Learning)中的经典缺陷:当模型依次学习多个任务时,新任务的梯度更新会大幅覆盖旧任务所依赖的权重,导致模型在先前任务上的性能急剧下降。这在本质上源于参数共享——同一组权重被所有任务复用,更新必然产生干扰。常见的缓解策略包括弹性权重巩固(EWC)、经验回放(Replay)和参数隔离。PNSN属于参数隔离路线:通过将知识分散到独立集合,并借助可训练路由按需激活,理论上可避免更新一个集合时波及其他集合,从而缓解遗忘。但路由机制本身若随训练漂移,也可能导致旧知识“找不回来”,这正是需要实验验证的关键风险。
社区反馈与开源邀请
开发者将代码托管在GitHub仓库(pathetictype-bit/Apex),并明确表示希望其他开发者帮助调查架构、复现结果、发现缺陷或挑战底层假设。
这种开放态度在AI研究社区中具有实际价值。独立研究者受限于本地硬件,难以进行大规模实验,但社区协作可以部分弥补这一短板。开发者也承认:“我的本地硬件限制了我对某些实验的测试程度。”
从技术讨论的角度看,PNSN目前更像是一个值得认真对待的原型假设,而非可用的系统。它的价值不在于提供的答案,而在于提出的问题:当我们拥有可训练的路由机制时,参数模块化是否真的能成为通往持续学习的可行路径?这个问题值得更多实验来回答。
相关推荐
Claude Duet发布:主动型智能体迈出第一步,审批卡成关键约束
Anthropic 推出研究预览版 Claude Duet,Claude 可主动推送简报、语音交办任务,并通过审批卡控制发送、付款、删除等操作。本文分析其主动交互逻辑、安全隔离设计与主动型智能体的信任挑战。
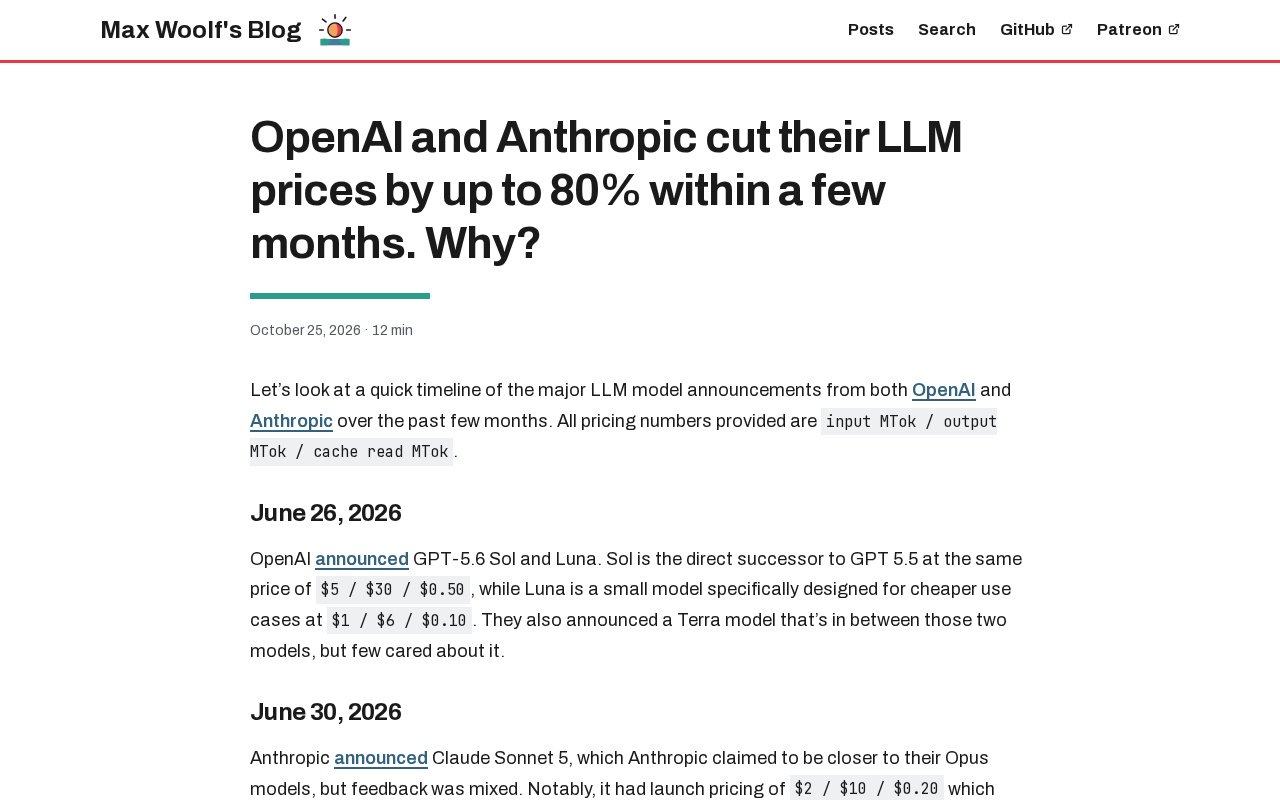
大模型价格战:OpenAI与Anthropic为何降价80%?
OpenAI和Anthropic在几个月内将LLM价格下调高达80%,本文分析价格战背后的竞争、技术成本、商业模式转变及行业影响。
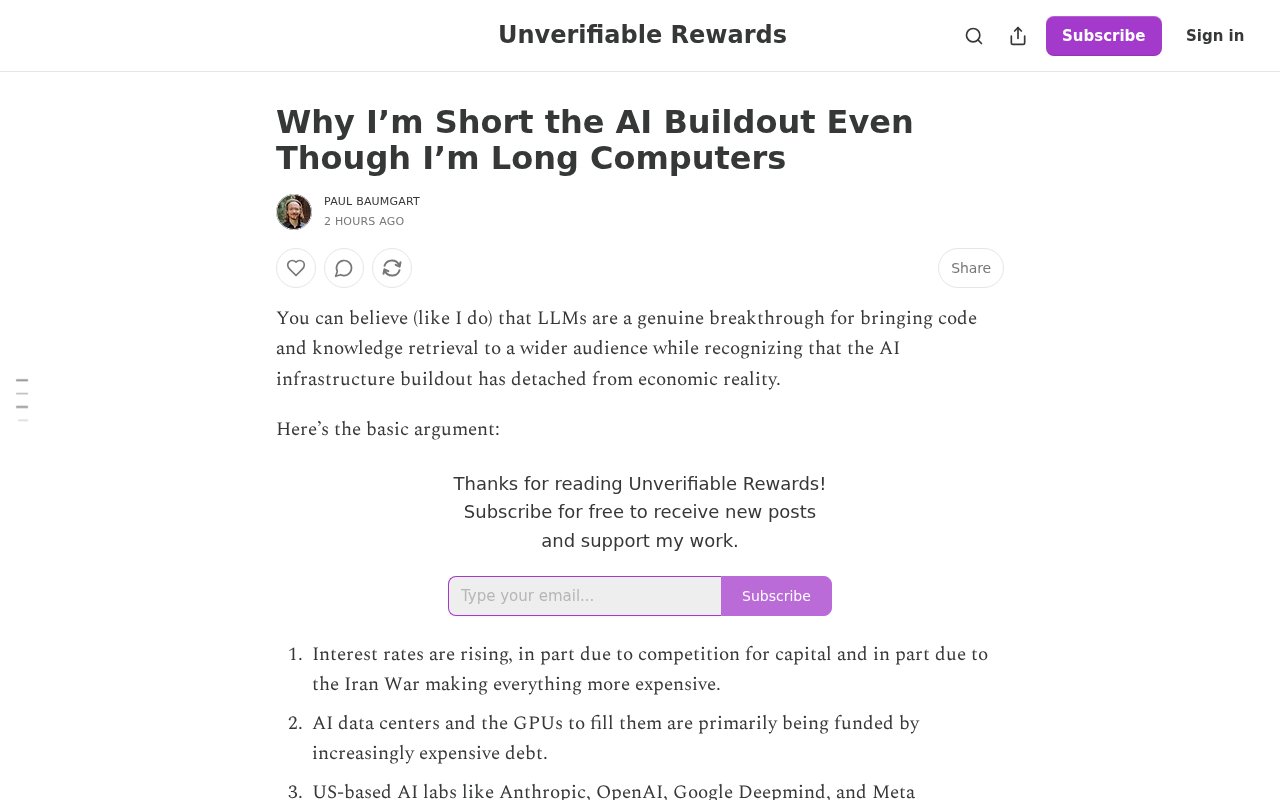
看多计算机却做空AI基建:一位投资者的逆向逻辑
一位投资者在Hacker News提出看多计算机长期需求、却做空AI基建热潮的反直觉立场。本文拆解其逻辑:技术趋势的确定性与资本开支回报的不确定性为何是两回事。