企业分析Agent评估框架对比:稳定性、检测与发现
评估框架的信息量决定评估质量,企业应采用轨迹评估加红队测试的双框架策略。
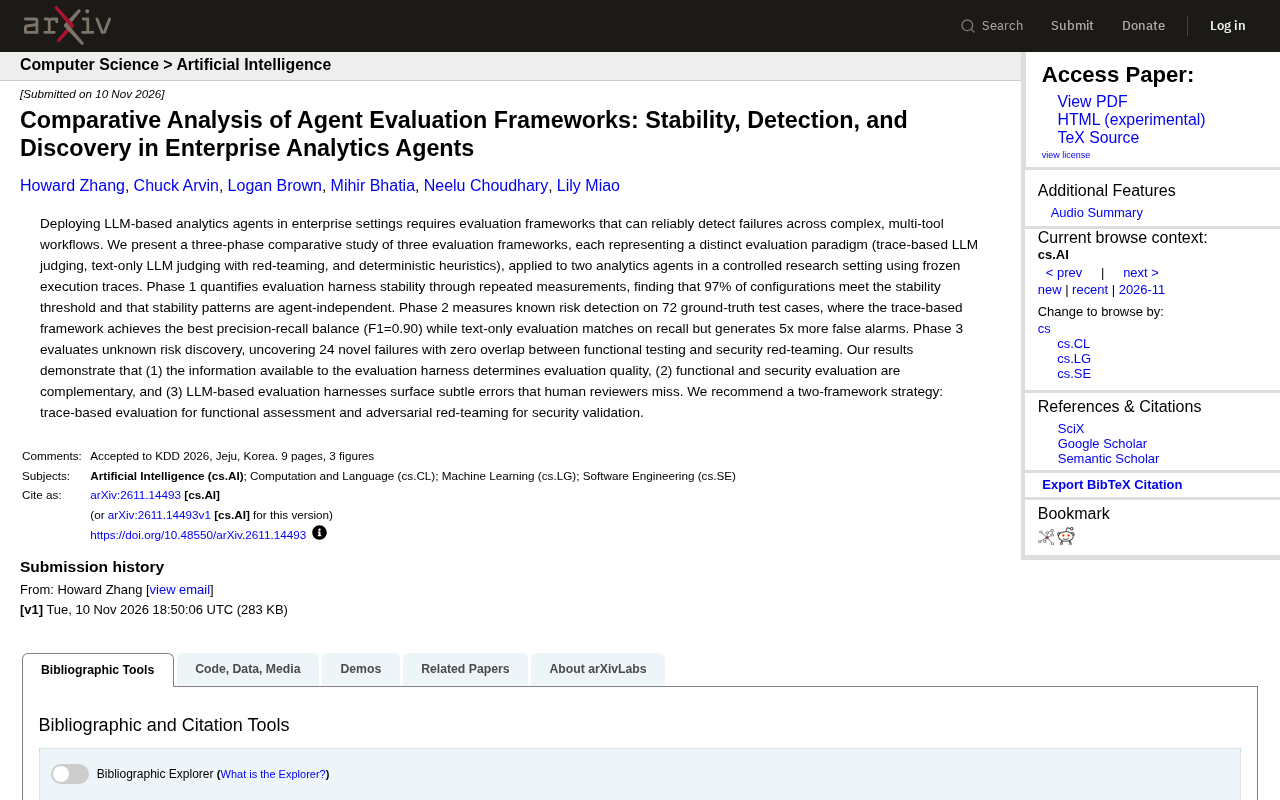
一项针对三种 Agent 评估范式的对比研究,在冻结执行轨迹上测试了两类分析 Agent,得出核心结论:评估框架能获取的信息量决定了评估质量的上限。研究分三阶段展开:稳定性方面,97% 的配置达到阈值,且稳定性模式与被评估 Agent 无关,配置可跨 Agent 复用;已知风险检测方面,基于轨迹的 LLM 评判 F1 达 0.90,纯文本评估召回率持平但误报多 5 倍;未知风险发现方面,共识别 24 个新型失败案例,且功能测试与安全红队测试发现零重叠。据此研究推荐双框架策略:用基于轨迹的评估做功能体检,用对抗式红队测试做安全验证,二者不可互相替代。
为什么 Agent 评估框架需要被“评估”?
在企业环境中部署基于大语言模型(LLM)的分析 Agent,意味着它要在多工具、多步骤的复杂工作流中持续运行。一个看似微小的错误——比如选错数据表、误解聚合逻辑、或在权限边界上越界——都可能带来连锁后果。因此,评估框架本身必须足够可靠:它要能稳定复现结果,能准确识别已知风险,还要能发现团队事先没想到的未知失败。
一项针对三种评估范式的对比研究,在受控环境下用冻结的执行轨迹测试了两类分析 Agent,给出了一个颇具实操价值的结论:评估框架能拿到多少信息,直接决定了评估质量的上限。研究还提出了一个双框架策略:用基于轨迹的评估做功能体检,用对抗式红队测试做安全验证。
三种评估范式,三条技术路线
研究对比的三种框架,分别代表了当前 Agent 评估的主流思路:
基于轨迹的 LLM 评判(trace-based LLM judging):评估器可以访问 Agent 完整的执行轨迹,包括每一步的工具调用、中间输出和推理痕迹。信息量最大,判断依据最充分。
纯文本 LLM 评判 + 红队测试(text-only LLM judging with red-teaming):评估器只看最终输出或对话文本,不深入执行过程;同时引入对抗性测试来主动探测安全边界。
确定性启发式规则(deterministic heuristics):用预定义规则做检查,不依赖 LLM 判断。可复现性最强,但对复杂语义错误的敏感度有限。
三条路线各有取舍,而研究的设计是把它们放在同一批冻结轨迹上跑,从而剥离运行时波动带来的干扰,让差异真正归因于评估框架本身。
执行轨迹(execution trace) 是理解全文的关键概念。它指 Agent 在一次任务运行中留下的完整记录:每一步的输入提示、模型推理过程、工具调用参数与返回结果、中间状态变化,以及最终输出。基于轨迹的评估之所以信息量最大,正是因为评估器能沿着这条链路定位错误发生在哪一步——是检索阶段选错了数据表,还是聚合阶段误解了指标口径。相比之下,纯文本评估只看轨迹的终点,丢失了过程信息。研究中反复提到的“冻结轨迹”,是指把真实运行产生的轨迹完整保存下来,之后在固定不变的轨迹上反复评估,从而排除模型采样随机性和工具环境波动带来的干扰,使不同评估框架之间的差异可以真正归因于框架设计本身。
第一阶段:稳定性是评估的前提
评估框架如果自己都不稳定,重复测量结果飘忽不定,那它给出的任何分数都不可信。研究的第一阶段就是量化评估 harness 的稳定性:通过重复测量,观察同一批轨迹在不同配置下是否给出一致的判断。
结果相对乐观——97% 的配置达到了稳定性阈值。更有意思的发现是,稳定性模式与 Agent 本身无关:也就是说,评估框架的稳定性更多取决于框架设计和配置,而不是被评估对象的特性。这对企业实践有直接含义:你可以在不同业务线的 Agent 上复用同一套经过验证的评估配置,而不必为每个 Agent 重新做稳定性校准。
不过,剩下那部分未达标的配置同样值得警惕。稳定性不达标往往意味着评估结果存在噪声,可能把偶发波动误判为真实缺陷,或者反过来掩盖真实问题。上线前对评估 harness 做重复测量验证,应该成为标准动作。
第二阶段:已知风险的检测能力
第二阶段用 72 个有标准答案的测试用例,衡量各框架检测已知风险的能力。核心指标是精确率与召回率的平衡。
基于轨迹的框架表现最好,F1 达到 0.90,在精确率和召回率之间取得了最佳平衡。纯文本评估在召回率上与它持平——也就是说,该抓的问题基本都抓到了——但代价是产生了 5 倍的误报。这个数字很有说服力:只看文本的评估器缺乏执行上下文,容易把正常行为误判为风险,导致大量假警报。
对企业团队来说,5 倍误报带来的不仅是评估成本上升,更严重的是告警疲劳。当工程师习惯了大量误报,真正的严重问题反而可能被忽略。确定性启发式规则在这一阶段的表现,研究未给出与上述两者并列的具体数值,但其局限性在于规则覆盖范围有限,难以捕捉语义层面的复杂错误。
精确率(precision)与召回率(recall) 是评估检测能力的两个基本维度。精确率衡量“评估器报出的风险中有多少是真的”,召回率衡量“真实存在的风险中有多少被评估器抓到”。两者往往此消彼长:判定标准放严,误报减少但漏报增多;判定标准放宽则相反。F1 是两者的调和平均,用来综合衡量平衡程度。理解这一点就能明白文中数据的含义:纯文本评估召回率与基于轨迹的框架持平,说明它并未漏掉该抓的问题,但它把大量正常行为也标记为风险,精确率因此下降,最终表现为 5 倍误报。对企业而言,误报的直接成本是排查工时,间接成本则是告警疲劳——工程师逐渐对告警脱敏,真正的高危问题反而被淹没。
第三阶段:未知风险的发现能力
第三阶段关注的是评估框架能否发现团队事先没有定义的失败模式。研究在这一阶段发现了 24 个新型失败案例,并且有一个关键观察:功能测试与安全红队测试的发现零重叠。
零重叠意味着什么?功能评估和安全性评估在探测完全不同的失败空间。功能测试关心的是“Agent 有没有把任务做对”,安全红队关心的是“Agent 会不会在对抗性输入下做出危险行为”。两者不可互相替代,缺一不可。
研究还指出,基于 LLM 的评估 harness 能捕捉到人类评审者容易忽略的细微错误。这对企业评估流程的设计有现实意义:人工审查仍然重要,但不应该成为唯一的发现机制。
红队测试(red-teaming) 源于安全工程领域,指由扮演攻击者的一方主动构造对抗性输入,系统性地探测系统的薄弱环节。在 LLM Agent 场景下,红队测试的典型手法包括提示注入、诱导越权访问、构造边界数据请求、以及利用工具调用链中的信任假设制造危险行为。它与功能测试的根本区别在于目标不同:功能测试验证 Agent 在正常任务下是否做对,红队测试则假设存在恶意或极端输入,检验 Agent 的防御边界。这解释了研究中“发现零重叠”的现象——两类测试探索的是不同的失败空间,一个框架无法替代另一个。红队测试的另一特点是其用例往往需要持续演进,因为每发现一类新攻击面,就意味着需要设计新的对抗样本去覆盖它。
双框架策略:功能与安全各司其职
基于三阶段结果,研究给出的推荐清晰而务实:采用双框架策略。
用基于轨迹的评估做功能评估。它能利用完整的执行上下文,在已知风险检测上取得最好的精确率-召回率平衡,误报可控。
用对抗式红队测试做安全验证。它与功能测试的发现空间几乎不重叠,专门覆盖对抗性场景下的风险。
这个策略背后的核心论点是研究反复强调的:评估 harness 可获取的信息量决定评估质量。想让评估器做出准确判断,就得给它足够的信息;想让评估覆盖安全边界,就得专门设计对抗性测试,而不是指望功能测试顺带发现安全问题。
对企业落地的几点启示
第一,评估框架选型不是找“最强的一个”,而是按用途组合。功能评估和安全评估的目标函数不同,用一套框架硬扛所有场景,要么误报失控,要么覆盖不全。
第二,稳定性验证应前置。97% 的配置达标说明大多数情况下基础设施是可靠的,但那 3% 的噪声源如果不排查,会在关键决策点上放大风险。
第三,冻结轨迹是值得采纳的工程实践。在固定轨迹上做评估,能有效隔离运行时波动,让不同框架的对比结论真正可归因。
第四,警惕只看输出的评估器。5 倍误报的代价在规模化运行后会变得难以承受,而误报带来的告警疲劳会侵蚀团队对评估系统的信任。
研究的局限也值得说明:实验在受控研究环境中进行,只覆盖两类分析 Agent,企业实际部署中的工具生态和权限模型更为复杂。但“信息量决定评估质量”这一原则,以及功能与安全评估互补的结论,具有超出具体框架的参考价值。
相关推荐
美国新车均价突破5.1万美元:AI与软件定义汽车如何推高成本
美国新车平均价格突破5.1万美元创历史新高。本文从软件定义汽车、中央计算架构、辅助驾驶传感器预埋与车端AI推理成本角度,分析AI与软件如何推高整车售价,以及这一趋势对消费者和厂商的影响。
Anthropic无预警移除Claude Code功能,开发者社区不满
Anthropic无预警移除Claude Code功能引发开发者不满。本文分析事件经过、开发者敏感原因及对AI编程工具生态的启示,探讨厂商如何平衡迭代与用户信任。
MAFM:流匹配生成中的物理约束新解法
MAFM提出用连续几何动力学替代离散校正,在流匹配生成中实现物理约束满足。本文解析其切向/法向运动解耦机制、理论保证与实验表现,并讨论局限与展望。