亲测苹果Siri Recaps:实用却令人不安的AI摘要

Siri Recaps一天内展现AI摘要实用性,但隐私不安与改进空间并存。
本文基于一位用户对苹果Siri Recaps的一天实际体验,分析该AI摘要功能的实用价值与潜在隐忧。体验显示,Siri Recaps能智能整理通知与长内容,帮助用户快速抓住重点,在短时间内即赢得认可,说明苹果在摘要准确性和场景适配上做了优化。然而便利背后是隐私担忧:功能需访问用户数据生成摘要,用户坦言体验“a little unsettling”,反映出对数据使用与存储的不安。文章同时指出功能仍有改进空间,涉及摘要准确性、内容类型适应性和隐私控制透明度。结合多源讨论,Siri Recaps被视为苹果AI布局的重要一步,其系统级整合是优势,但也面临第三方工具竞争。结语强调,苹果能否在效率与隐私之间持续取得平衡,将决定该功能的长期接受度。
苹果的AI功能一直备受关注,而Siri Recaps作为其最新推出的智能摘要特性,在隐私与便利之间引发了新的讨论。一位用户在实际体验一天后,给出了“ surprisingly useful — and a little unsettling”的评价。本文基于该体验,结合多源信息,深入分析Siri Recaps的实用价值与潜在隐忧。
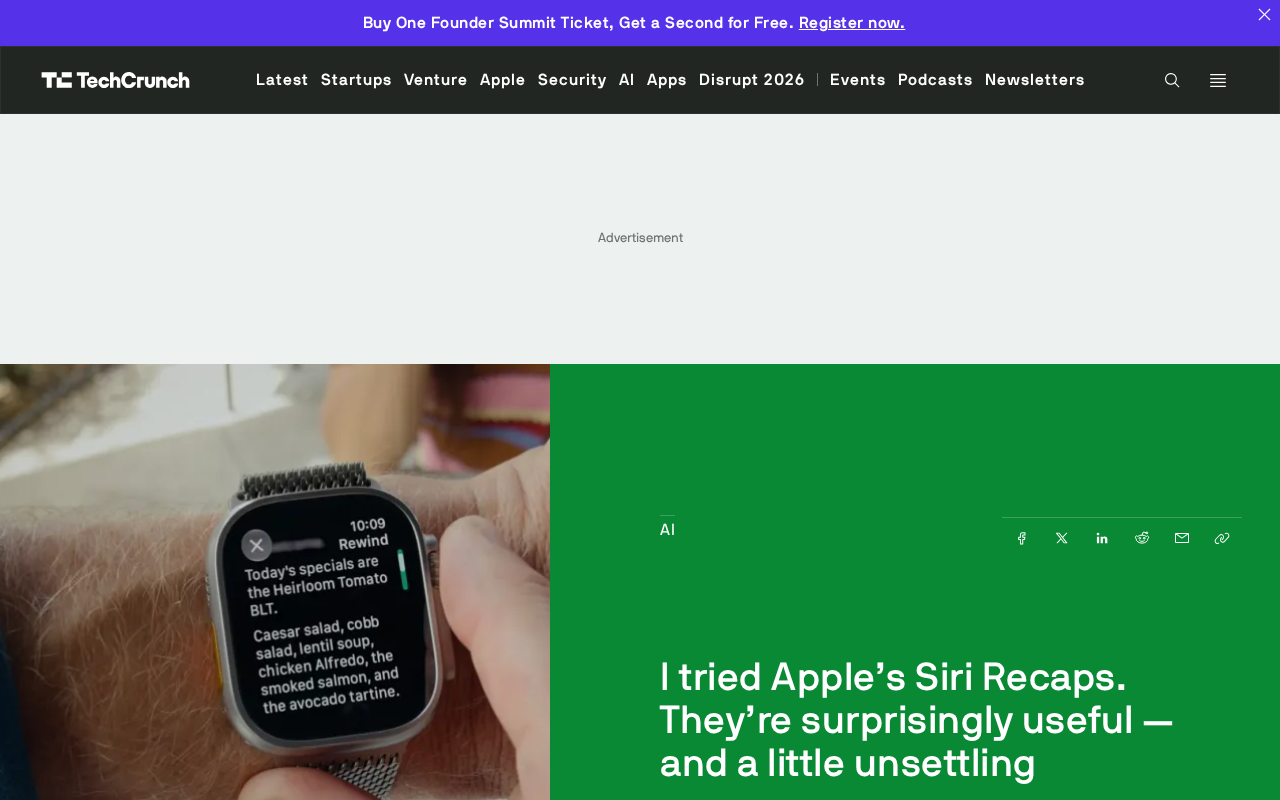
令人惊讶的实用性:一天内征服用户
据用户反馈,Siri Recaps在短短一天内就赢得了他的认可。该功能能够智能地整理和摘要信息,帮助用户快速抓住重点,尤其在处理大量通知或长内容时表现出色。尽管用户最初对隐私有所顾虑,但实用性最终占据了上风。这种即时生效的体验表明,苹果在AI摘要的准确性和场景适配上做了不少优化。
隐私与便利的拉锯战
Siri Recaps的便利性背后,是用户对隐私的天然担忧。该功能需要访问用户的数据以生成摘要,这不可避免地涉及敏感信息。用户坦言“a little unsettling”,反映出在享受AI带来的效率提升时,对数据如何被使用和存储的不安。苹果一向以隐私保护为卖点,但AI摘要的深度介入是否改变了这一平衡,值得持续观察。
端侧处理与云端处理的隐私差异是理解Siri Recaps隐私争议的关键背景。苹果近年推行的“隐私计算”策略强调将尽可能多的AI推理放在设备本地(on-device)完成,例如通知摘要、照片识别等任务可在iPhone的神经网络引擎上运行,原始数据不出设备。但受限于端侧算力,复杂或长文本的摘要往往需要借助Apple的Private Cloud Compute(私有云计算)——一种宣称“服务器不保留数据、仅用于计算”的架构。用户“a little unsettling”的感受,正源于难以直观判断某条摘要究竟在哪一端生成、数据经过了哪些节点。相比纯本地处理,云端介入意味着信任对象从“自己的设备”扩展到“苹果的服务器与合规承诺”,这种信任转移虽由技术架构支撑,但对普通用户并不透明。
仍有改进空间
尽管Siri Recaps整体表现令人满意,但用户明确指出“there's still room for improvement”。可能的方向包括摘要的准确性、对不同内容类型的适应性,以及更透明的隐私控制。目前的功能或许只是苹果AI布局的起点,后续迭代值得期待。
多源视角下的Siri Recaps
综合多个来源的讨论,Siri Recaps的推出被视为苹果在AI助手领域的重要一步。有分析指出,该功能与系统级应用的深度整合是其优势,但也面临与第三方AI摘要工具的竞争。用户社区中,对隐私的担忧与对便利的赞赏并存,这种矛盾心理颇具代表性。
理解Siri Recaps的定位,需要区分系统级摘要与生成式摘要两种技术路径。系统级摘要多基于抽取式(extractive)方法,从原始通知、邮件或网页中挑选关键句子并重组,优点是事实保真度高、不易“幻觉”,但语言灵活度有限;生成式摘要(abstractive)则由大语言模型重新组织语言,可读性更强,却存在歪曲原意的风险。Siri Recaps更接近前者与轻量生成的混合形态,这也是其在“准确性”上表现相对稳健、但仍被用户指出“有改进空间”的原因。与第三方AI摘要工具(如浏览器插件、独立App)相比,系统级整合的優勢在于可跨应用调用数据、无需用户手动复制粘贴,劣势则是可配置性低、用户难以审计摘要来源。这种“深度整合换便利、牺牲部分透明度”的取舍,正是多方讨论的焦点。
结语:平衡之道
Siri Recaps展示了AI摘要的实用潜力,但也提醒我们,在追求效率的同时,隐私与控制的议题不容忽视。苹果如何在这一平衡中持续优化,将决定该功能的长期接受度。
相关推荐

科幻小说对AI的预测有多准?
科幻小说对AI的预测有多准?本文结合Hacker News讨论,分析科幻作品在AI发展中的远见与盲区,探讨其真正价值在于启发思考而非精准预测。

SwarmEvolve:潜空间智能体集群加速进化搜索
SwarmEvolve框架让数百个低成本智能体在潜空间中集群推理,通过KV缓存共享信息,在数学发现和科学计算问题上实现快速进化搜索,中位数仅3-8分钟达到其他框架60分钟的最佳分数。

trainlint:静态检查揪出不会崩溃的 ML 训练 Bug
trainlint 是一个静态检查工具,能找出不会报错的机器学习训练 bug,包括数据泄漏、eval 模式残留、softmax 与 CrossEntropyLoss 冲突等十四类问题。本文介绍其原理、验证结果与局限。