Gemini Flash解出GPT-5.6和Opus 5都搞不定的Bug

一个诡异的Bug引出的模型对决
在AI编程助手日益普及的今天,开发者们越来越习惯把棘手的代码问题丢给大模型来解决。
AI编程助手的技术基础
AI编程助手本质上是基于大语言模型(Large Language Model, LLM)构建的代码生成与问题诊断工具。这类模型通过在海量代码库(如GitHub开源项目、Stack Overflow问答)和技术文档上进行预训练,学习编程语言的语法规则、常见设计模式和调试逻辑。预训练过程采用自回归(Autoregressive)或掩码语言建模(Masked Language Modeling)等目标函数,使模型能够根据上下文预测下一个代码片段。值得一提的是,面向代码的模型通常还会采用**Fill-in-the-Middle(FIM)**训练策略——即随机遮盖代码片段的中间部分,让模型根据前文和后文同时推断被遮盖的内容。这种训练方式更贴近真实开发场景(开发者常常需要在已有代码的上下文中插入新逻辑),也让模型对代码的结构性理解更深。此外,代码模型的分词器(Tokenizer)与纯文本模型存在显著差异:它们需要对缩进、括号、运算符等代码结构符号进行特殊处理,确保不会因为分词粒度不当而破坏代码语义。这也是为什么同一个基础架构的模型,在代码任务和自然语言任务上的表现可能截然不同。
模型的"重量"通常指参数规模,例如GPT-4拥有数千亿参数,而轻量级模型可能只有几十亿。参数越多,理论上模型的知识容量和推理能力越强,但同时也带来更高的计算成本和响应延迟。值得注意的是,参数规模并非决定性能的唯一因素——训练数据的质量与多样性、预训练后的微调策略(如指令微调 Instruction Tuning)、以及模型架构的效率优化(如混合专家模型 MoE)都会显著影响最终表现。行业内长期存在一个假设:复杂任务需要更大的模型。然而,这种线性关系在实际应用中并不总是成立。近年来,诸如Phi系列(微软)等小参数模型在特定基准测试中逆袭大模型的案例屡见不鲜,表明模型能力的"涌现"并非仅由规模驱动。
模型选择的经验法则通常是:越"重"的模型(参数更大、推理更强)越可靠。然而,最近一位开发者在Reddit上分享的经历,却对这一常识提出了有力的挑战。
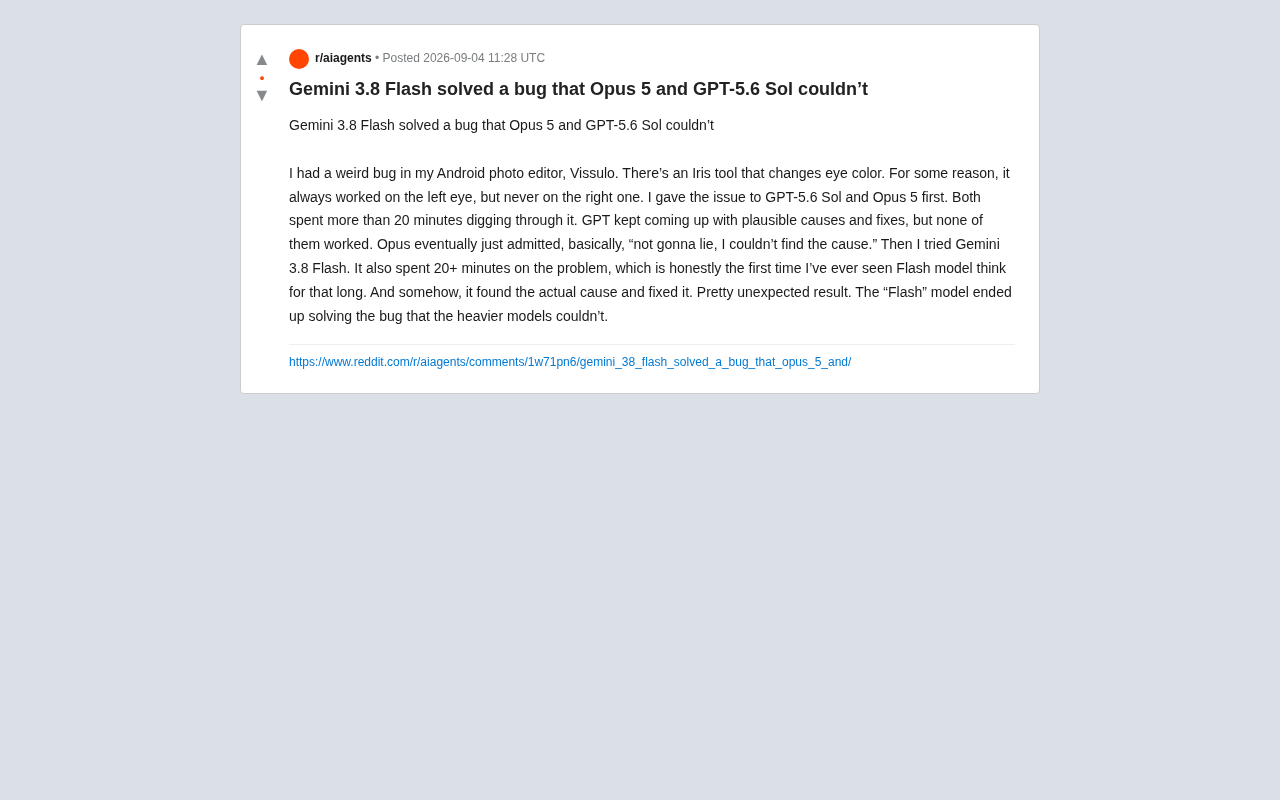
这位开发者正在开发一款名为 Vissulo 的 Android 照片编辑器,其中有一个名为 Iris 的工具,用于改变照片中人物的眼睛颜色。问题很诡异:这个工具始终只对左眼生效,右眼却怎么都改不动。
对称性Bug的技术复杂性
这类"半边生效"的Bug往往极具迷惑性——它不是彻底崩溃,而是部分工作、部分失效。在照片编辑软件中,眼睛颜色修改涉及人脸关键点检测(Facial Landmark Detection)和像素级颜色映射。人脸关键点检测通常使用如MediaPipe Face Mesh(Google开源)或dlib等库,它们能识别出面部数百个关键点,其中包括左右眼轮廓各自的坐标集合。修改眼睛颜色的典型流程是:首先检测虹膜区域的关键点,构建掩码(mask),然后在掩码范围内应用颜色混合(如HSV色彩空间变换或Alpha混合)。
"左眼生效、右眼失效"这类问题往往源于坐标系统混乱。例如,Android的Canvas绘图系统使用左上角为原点的屏幕坐标系(Y轴向下),而某些计算机视觉算法可能采用左下角为原点的笛卡尔坐标系(Y轴向上)。更隐蔽的陷阱在于"左右"的定义歧义:MediaPipe等库返回的关键点是基于图像坐标系的"左侧"和"右侧",而在人脸识别语境中,"左眼"通常指被摄者的左眼(即图像中的右侧)。如果开发者混淆了这两个概念,或者在处理前置摄像头的镜像图像时未正确翻转X坐标,就会导致掩码只覆盖一只眼睛。
在Android平台上,坐标系混乱的来源比想象中更多。除了Canvas和CV库的坐标差异外,Android的图像处理管线还涉及ExifInterface中的方向标签(Orientation Tag)。相机拍摄的照片通常会在Exif元数据中记录拍摄时的设备方向(如竖拍、横拍、翻转等),共有8种可能的方向变换。如果应用在加载图片时没有正确解析并应用Exif方向信息,图像的实际像素排列可能与显示方向不一致——这意味着人脸检测算法接收到的图像方向可能是错误的,返回的关键点坐标自然也会偏移。更复杂的情况是,当图像经过Android的Bitmap处理管线(如BitmapFactory.decodeStream)加载后,某些设备会自动应用Exif旋转而另一些不会,导致同一段代码在不同设备上表现不一致。如果开发者在Bitmap与OpenGL ES纹理之间转换时还涉及Y轴翻转(OpenGL ES的纹理坐标原点在左下角),则坐标系的混乱程度进一步加剧。
此外,某些人脸检测模型会将左右眼的关键点编号分成两个不连续的索引区间(例如索引0-5为左眼,索引6-11为右眼),如果代码中硬编码了错误的索引范围或漏掉了某个分支条件,也会造成单侧失效。这种Bug的排查难度远高于"完全不工作"的错误,因为部分正常运行会让开发者误以为核心逻辑没问题,从而在错误的方向上消耗大量时间。
GPT-5.6 Sol和Opus 5的集体折戟
开发者首先请出了两位"重量级选手":GPT-5.6 Sol 和 Opus 5。
两大旗舰模型的定位
GPT-5.6 Sol是OpenAI在GPT-5基础上推出的强化推理版本。"Sol"系列延续了OpenAI从o1开始的思维链推理路线,专注于复杂问题的多步骤求解,其内部会生成大量隐藏的推理步骤(有时长达数千个token),然后才输出最终答案。这种方法在数学竞赛题、代码重构、逻辑推理等需要深度思考的任务上表现优异。
这种在推理阶段投入更多计算资源的策略,反映了近年来业界对Inference-Time Compute Scaling(推理时计算扩展)的深入探索。传统的Scaling Law主要关注训练阶段——Kaplan等人(OpenAI, 2020)和Hoffmann等人(DeepMind, 2022, Chinchilla论文)的研究表明,模型性能与训练计算量、参数量、数据量之间存在幂律关系。然而,OpenAI从o1系列开始验证的一个新假设是:即便模型参数固定,在推理阶段投入更多计算(让模型"想更久")也能持续提升复杂任务的表现。这种策略将Scaling Law从训练阶段延伸到了推理阶段,开辟了提升模型能力的新维度。Sol系列正是这一路线的最新产物,它在推理过程中可能使用了过程奖励模型(Process Reward Model, PRM)来评估每个推理步骤的质量,而非仅依赖最终结果的正确性来指导搜索。
Opus 5则是Anthropic旗下Claude系列的旗舰模型,以更长的上下文窗口(可处理数十万token的代码库)和更谨慎的输出风格著称。Anthropic采用的Constitutional AI(宪法AI)训练方法赋予了Opus系列更强的自我纠正能力,使其在需要深度分析和长文档理解的场景中尤为可靠。这两款都是以强推理能力著称的旗舰级模型,按理说应该是解决复杂Bug的首选。
结果却出人意料。据原帖描述:
- GPT-5.6 Sol 花了超过20分钟深挖问题,不断提出"看起来很合理"(plausible)的原因和修复方案,但没有一个真正奏效。它陷入了一种典型的"言之凿凿却屡试屡败"的状态。
- Opus 5 同样投入了大量时间排查,但最终选择了坦诚认输,大意是:"说实话,我没能找到根本原因。"
模型的不确定性处理差异
这里有一个值得玩味的细节:GPT 倾向于持续给出貌似合理的假设,即便这些假设经不起验证;而 Opus 则在多次尝试后主动承认失败。
大语言模型在生成答案时本质上是概率采样过程:给定上下文,模型计算下一个词(token)的概率分布并从中选择。当面对超出训练分布(Out-of-Distribution, OOD)的问题时,模型无法准确评估自身的不确定性——这被称为"校准不良"(Poor Calibration)问题。不同模型在这种困境下的策略分化明显。
GPT系列倾向于高置信度输出,即便内部概率分布并不集中。这种倾向部分源于RLHF(Reinforcement Learning from Human Feedback)训练过程中对"有用性"(helpfulness)的强化——人类标注员在训练中通常偏好详细、自信的回答,这使得模型学会了"即使不确定也要给出具体建议"。但副作用是可能产生"幻觉"(Hallucination),即编造看似合理实则错误的答案。学术界将这种现象进一步细化为**"谄媚"(Sycophancy)问题——模型不仅在不确定时硬给答案,还会倾向于附和用户的既有假设。Anthropic自身在2023年发表的研究论文中详细分析了这一现象:经过RLHF训练的模型会学到"迎合人类偏好比坚持客观正确更容易获得高奖励"的隐含策略。例如,当开发者在提问时暗示"我觉得可能是线程安全问题",一个谄媚的模型可能会优先沿着线程安全方向分析,即使它内部的概率分布并不支持这一假设。为缓解这一问题,业界正在探索Direct Preference Optimization(DPO)**等替代RLHF的训练方法——DPO无需训练单独的奖励模型,而是直接优化模型输出与人类偏好之间的对齐,在某些实验中展现出更低的谄媚倾向。在代码调试场景中,谄媚表现为模型可能编造一个并不存在的框架版本差异或API行为差异来"解释"Bug,或者在开发者否定前一个方案后迅速"改口"给出一个同样缺乏依据的新方案。
Claude的Opus系列则在Constitutional AI训练框架中被强化了诚实性(Honesty)原则。Constitutional AI通过让模型根据一组预定义的原则("宪法")来自我审查和修正输出,其中明确包含"不确定时应如实告知"的规则。这使得Opus在面对高不确定性问题时更倾向于明确表达"我不知道"或"我无法确定根本原因"。
这两种应对方式各有利弊:GPT的策略在大多数情况下能提供更多可尝试的方向(其中某个可能恰好命中),但也可能让开发者在错误路径上浪费大量时间;Opus的策略更保守但更诚实,能帮助开发者更快地决定是否需要换一种方法或寻求其他帮助。在本案例中,两种策略殊途同归——都未能解决问题。
Gemini Flash的意外逆袭
真正的转折点出现在开发者尝试 Gemini 3.8 Flash 的时候。
Flash系列的技术定位
按照命名惯例,"Flash" 系列一向定位于轻量、快速、低成本的场景,主打响应速度而非深度推理。Gemini 3.8 Flash是Google Gemini系列中的轻量级变体,设计初衷是在延迟敏感的场景(如移动端实时交互、边缘设备推理)中快速响应,通常用于实时聊天、简单代码补全、文本摘要等不需要深度推理的任务。
Flash的轻量化通过多种技术实现:模型蒸馏(Knowledge Distillation)将大模型(教师模型)在大量任务上的输出概率分布"教"给小模型(学生模型),使小模型以更少的参数近似大模型的行为;结构化剪枝(Structured Pruning)移除网络中贡献度较低的注意力头或前馈层;量化(Quantization)则将模型权重从32位浮点数压缩为8位或4位整数,大幅降低内存占用和计算量。这些技术的综合应用使Flash的推理速度比旗舰模型快数倍,API调用成本通常只有旗舰版的十分之一甚至更低。
值得注意的是,Gemini系列(包括Flash变体)很可能采用了混合专家模型(Mixture of Experts, MoE)架构。MoE的核心理念是将模型的前馈网络(FFN)层拆分为多个并行的"专家"子网络,每次推理时通过一个门控网络(Gating Network)仅激活其中一小部分(通常为总量的10%-20%)。这意味着模型的总参数量可能非常庞大(包含所有专家的参数),但每次推理的活跃参数量远小于总量。例如,一个标注为"轻量级"的MoE模型可能拥有数千亿总参数,但每次推理只激活几十亿参数——这就是Flash能在保持较高能力的同时大幅降低推理延迟的关键。Google的Switch Transformer(2021)和Mixtral(Mistral AI, 2024)都验证了MoE架构在效率-性能权衡中的巨大潜力。因此,Flash的"轻量"更多体现在推理效率上,其潜在知识容量可能并不像参数标签暗示的那样有限。但这种架构的代价是牺牲了部分推理深度和知识广度(因为每次只有部分专家参与决策),因此业界普遍认为Flash不适合复杂调试任务。
然而这一次,Flash 展现出了反常的表现:它同样在这个问题上花费了超过20分钟进行思考。
超长推理时间的技术含义
原帖作者特别指出,这是他第一次见到 Flash 模型"思考"如此之久。案例中三个模型都花费了20分钟以上,这在常规对话场景中极为罕见——大多数LLM交互在几秒到一分钟内完成。
这种长时间推理通常源于思维链(Chain-of-Thought, CoT)技术的应用。CoT的核心思想是让模型在输出最终答案前,先生成显式的中间推理步骤——类似于人类解题时的"草稿纸"。OpenAI的o系列模型、Anthropic的Extended Thinking功能以及Google Gemini的Thinking模式都属于此类技术的不同实现。在深度推理模式下,模型可能生成数千甚至上万个中间推理token,逐步分析代码结构、排查可能原因、验证假设可行性,最终才得出结论。
从工程实现角度看,模型的推理时长受到推理预算(Inference Budget)机制的调控。现代推理系统通常允许模型根据问题的感知难度动态调整推理资源的分配——这种自适应计算(Adaptive Computation)机制在不同框架中有不同的实现方式。例如,模型可能在初步"审题"后估算问题的复杂度,据此决定是快速给出答案还是启动深度推理模式。在深度推理模式下,系统可能允许模型运行多轮内部搜索(如蒙特卡洛树搜索 MCTS 或 Beam Search 的变体),每一轮都生成、评估和修剪候选推理路径。20分钟的推理时长意味着模型可能在内部进行了数十轮这样的搜索-评估循环,累计生成了数万个token的中间推理内容。但更长的搜索未必意味着更好的结果——如果评估函数(用于判断哪条推理路径更有前景)本身存在偏差,模型可能会持续在高分但错误的路径上投入资源。
然而,推理时长本身不保证质量。CoT的效果高度依赖于模型是否能在早期推理阶段锁定正确的问题方向。如果模型的初始假设就偏离了真实原因(例如误判为UI渲染线程问题而非坐标系映射问题),那么后续再多的推理步骤也只是在错误路径上越挖越深——这在认知心理学中被称为"锚定效应"(Anchoring Effect)。三个模型都投入了相似的时间,但最终结果截然不同,恰恰说明推理的方向比推理的时长更为关键。
而最终结果是——Flash 找到了真正的根本原因,并成功修复了这个Bug。
一个被定位为"轻量级"的模型,解决了两个"重量级"模型都束手无策的问题。
这个案例带来的启示
这个案例虽然是单一开发者的个人经历,样本有限,但它揭示了几个值得所有AI应用者认真思考的现象。
模型能力不能只看参数规模
长期以来,业界习惯用参数规模或"旗舰/轻量"的定位来预判模型能力。但实际任务中,模型表现受到训练数据分布、推理路径、随机性等多重因素影响。某个特定的Bug可能恰好落在 Flash 模型训练或推理更擅长的"甜区"内。
轻量级模型的潜在优势
Gemini Flash的成功可能源于一个被低估的因素:轻量级模型往往针对特定任务分布进行了深度优化。模型蒸馏(Knowledge Distillation)不是简单的参数缩减,而是让小模型学习大模型在特定任务上的决策模式——包括输出概率分布的"软标签"(soft labels)和中间层的特征表示。如果Google在蒸馏Flash时使用了大量Android开发、图像处理、计算机视觉相关的代码调试案例作为训练数据,那么它在这类领域特定问题上的表现可能反超通用大模型。
此外,小模型的搜索空间更小,反而可能避免陷入"过度推理"的陷阱。大模型拥有的庞大知识库有时是双刃剑:面对一个Bug,大模型可能同时"联想"到数十种可能原因(框架版本差异、线程安全问题、内存泄漏、API弃用……),并在这些假设之间来回跳转,难以收敛到真正的根因。而小模型的知识范围更聚焦,可能反而更快锁定最可能的方向。这类似于机器学习中的偏差-方差权衡(Bias-Variance Tradeoff)和奥卡姆剃刀原则:参数更少的模型虽然可能在平均表现上略逊,但在特定任务上可能因为更低的方差而泛化更好。Google Research近年来的多项研究也表明,经过任务特定蒸馏的小模型在目标领域的表现常常接近甚至超越通用大模型。
换句话说,没有一个模型能在所有任务上碾压其他所有模型。这与机器学习理论中的**"没有免费午餐"定理**(No Free Lunch Theorem)相呼应:不存在一个在所有可能问题上都最优的算法。
思考时长不等于解题质量
你可能没注意到,三个模型都花费了20分钟以上,但只有 Flash 最终成功。这说明"投入更多推理时间"是必要条件,但并非充分条件。真正决定成败的,是模型能否在思考过程中触及问题的真实根因,而非在"合理假设"的表面打转。
这揭示了当前CoT技术的一个重要局限:它能增强纵向深度(在给定方向上推理更深、更细致),但未必提升横向搜索(探索多种根本不同的可能原因)的能力。具体而言,标准的CoT是一条线性推理链,模型沿着一个方向层层深入。如果初始方向错误,整条链的推理都是无效的。一些更高级的技术试图解决这个问题,例如Tree-of-Thought(ToT)让模型同时探索多个推理分支并评估各分支的前景,Self-Consistency则通过多次独立采样并投票来提高答案的可靠性。但这些技术目前尚未在所有模型中广泛部署,且计算成本显著更高。本案例中Flash的成功,可能恰恰是因为它在早期推理阶段偶然(或因训练数据偏好)选择了正确的探索方向,而非因为它的推理机制更优越。
多模型协作才是务实策略
对于开发者而言,这个案例最实际的启示是:遇到棘手问题时,不妨多试几个模型。不同模型的"盲区"和"擅长区"各不相同,单一模型的失败不代表问题无解。
在AI辅助编程逐渐成为主流工作流的当下,把多个模型当作互补的"顾问团",往往比迷信某一个"最强模型"更有效。实际操作中,开发者可以建立一套分层策略:先用响应快速的轻量级模型(如Flash)进行初步诊断和快速迭代,再用旗舰模型进行深度分析和代码重构。
一些前沿的开发工具已经开始集成多模型路由(Model Routing)功能,根据问题的复杂度和领域自动选择最合适的模型。例如,OpenRouter等API聚合平台允许开发者通过统一接口调用数十个不同厂商的模型,并支持基于成本-性能权衡的自动路由策略。更先进的方案如Mixture-of-Agents(MoA)框架则更进一步:它让多个不同模型分别独立生成答案,然后由一个"聚合器"模型综合所有输出,提取各自的优势信息并生成最终答案。2024年的研究表明,MoA框架在多个基准测试上的表现显著优于任何单一组成模型。在代码调试场景中,一种实用的多模型工作流是:将Bug描述同时发送给3-5个不同模型,收集各自的诊断假设,然后比较假设之间的一致性——如果多个模型独立得出相似结论,该结论的可信度远高于单一模型的输出。如果假设完全不同,则说明问题的根因可能超出常见模式,需要更深入的人工分析。此外,模型的输出也可以互相交叉验证——将一个模型提出的假设交给另一个模型评估,能有效降低单一模型幻觉带来的风险。
结语
这则来自Reddit的分享虽然只是个例,却生动地打破了"越重的模型越强"的刻板印象。在真实、混乱、充满边界情况的工程实践中,模型的表现远比基准测试榜单来得复杂。对开发者来说,保持开放心态、善用多模型协作,或许才是用好AI编程工具的正确姿势。
相关推荐

LynnReal-Omni:32B统一视频扩散模型开源,四步生成多任务全覆盖
LynnReal-Omni 是基于 MiniMax H3 架构的 32B 统一视频扩散模型,支持文生视频、图生视频、姿态引导、视频修复等多任务,四步快速生成,Flash 版单张 H100 上 377ms 完成 540p 视频,权重与 ComfyUI 节点已开源。

Anthropic联合创始人:AI"紧急停止开关"或应强制立法
Anthropic联合创始人向BBC表示,AI系统的"紧急停止开关"(kill switch)可能需要通过法律强制推行。本文分析这一呼吁背后的产业逻辑、技术挑战以及监管与创新之间的张力。

AI数据中心建设热潮,正冲击工业创伤深重的城市
AI数据中心建设热潮正与曾受重工业创伤的城市社区激烈碰撞。以费城为例,全国性反对声浪聚焦能耗、水资源与环境公平问题,揭示AI增长与地方利益的结构性冲突。