Qwen3 27B开源解析:原生多模态稠密模型架构与Agent能力实测

Qwen3 27B是什么?一款容易被名字误解的模型
阿里通义千问团队最新的27B级模型已经在Hugging Face正式公开。这里需要先厘清一个容易混淆的点:它既不是外界猜测的8B小模型,也不是动辄数万亿参数的MoE(混合专家)架构,而是一款27B参数级的稠密(Dense)原生视觉语言模型。
所谓"稠密",意味着模型在推理时会激活全部参数,而非像MoE那样只调用部分专家网络。这种设计通常带来更稳定的表现和更简单的部署路径,代价是推理成本相对更高。从更深层的技术角度来看,稠密模型和MoE架构代表了当前大模型设计的两条主要路线。MoE架构在Transformer的前馈网络(FFN)层引入多个"专家"子网络,通过门控机制(Gating Network)为每个token动态选择少数专家进行计算——例如Qwen自家的Qwen3-235B-A22B就是MoE架构,总参数2350亿但每次推理仅激活220亿。门控机制通常是一个轻量级的路由网络,它根据输入token的特征计算每个专家的权重分数,然后选择Top-K个专家参与计算。MoE虽然能以更低的推理成本获得更大模型的表达能力,但存在若干工程挑战:专家负载均衡难以调优(部分专家可能被过度使用而其他专家闲置,导致训练不稳定),多设备间的专家通信开销大(All-to-All通信模式对网络带宽要求极高),部署复杂度高(所有参数都需要加载到显存中,即使每次只激活一部分)。此外,稠密模型在训练过程中也具有更好的收敛稳定性,不需要额外的辅助损失函数来平衡专家利用率。Qwen3 27B选择稠密路线,本质上是在追求部署简洁性和推理稳定性,同时也降低了社区在各种硬件环境上适配的难度。
从许可协议看,该模型采用宽松的 Apache 2.0 授权,支持图片和视频输入,具备真正的原生多模态能力。Apache 2.0是开源领域最为宽松的许可协议之一,由Apache软件基金会维护,它允许用户自由使用、修改、分发软件(包括商业用途),唯一的核心要求是保留原始版权声明和许可证副本。与GPL系列协议不同,Apache 2.0不要求衍生作品也必须开源(无"传染性"条款),这意味着企业可以基于模型构建闭源的商业产品而不必公开自己的代码和微调数据,这对企业用户至关重要。此外,Apache 2.0还包含明确的专利授权条款,授予用户使用贡献者所持相关专利的权利,进一步降低了法律风险。对比Meta的Llama系列所使用的自定义社区许可(对月活跃用户超过7亿的公司有额外限制,需单独申请商业授权),以及Google Gemma采用的限制性使用条款,Qwen3 27B的Apache 2.0授权意味着几乎没有商业使用壁垒,对推动企业级私有化部署和下游生态建设具有直接的促进作用。
配置文件显示,它拥有 64 层网络、5120 隐藏维度,原生上下文长度达到 262144 tokens(约 26 万),官方模型卡还给出了将上下文扩展至 100 万 token 的延伸方案。262144 tokens以中文计算大约对应13-20万字的文本(因为中文分词后一个汉字通常被编码为1-2个token),或者数百页PDF文档的内容,这足以在单次推理中处理一整本中篇小说或一份完整的企业年报。早期的GPT-3上下文仅为2048 tokens,GPT-4将其扩展到128K,Claude 3支持200K,而Qwen3 27B的原生26万token上下文已经超越了大多数同级别模型。实现超长上下文的技术挑战主要在于两方面:一是标准自注意力机制的计算和显存开销随序列长度呈二次方增长(O(n²)),处理26万token意味着需要计算约680亿对token之间的注意力权重,所需的计算量和显存消耗是天文数字级别的;二是位置编码需要能够泛化到训练时未见过的更长序列。目前主流的解决方案是旋转位置编码(RoPE, Rotary Position Embedding),它通过将位置信息编码为复数平面上的旋转角度,使得相对位置关系可以通过内积自然体现。为了让RoPE支持超出训练长度的序列,研究者提出了多种外推技术:NTK-aware频率缩放通过调整RoPE的基频参数来改善长距离衰减特性;YaRN(Yet another RoPE extensioN)则结合了注意力缩放和频率插值,在不进行额外训练的情况下将上下文窗口扩展数倍。此外,Flash Attention等高效注意力算法通过分块计算和IO优化,将显存开销从O(n²)降低到O(n)级别,使得超长序列在工程上变为可行。这样的规格,让它在长文档理解和多模态长序列任务上具备天然优势。
混合注意力架构:线性注意力与完整注意力的循环设计
真正值得关注的是Qwen3 27B的架构选择。模型将 三层线性注意力(Linear Attention)与一层完整注意力(Full Attention)组合成循环结构,兼顾了长上下文处理的效率与全局建模的能力。
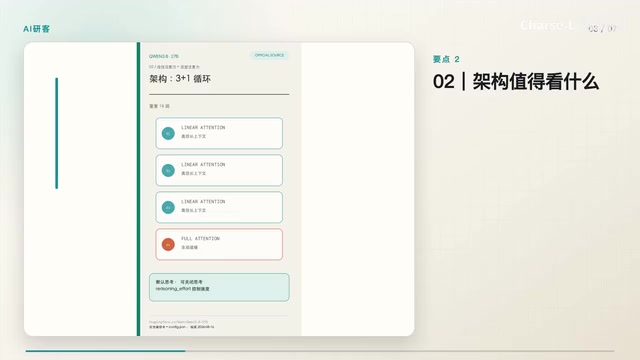
这种设计思路在业界有明确的工程动机:完整注意力(即标准的Softmax自注意力机制)通过计算查询(Query)与所有键(Key)的点积并经过Softmax归一化来生成注意力权重,从而捕捉序列中任意两个位置之间的全局依赖关系。其核心公式为 Attention(Q,K,V) = softmax(QK^T/√d)V,Softmax操作确保了注意力权重是一个有效的概率分布,使模型能够精确地"聚焦"于最相关的位置。然而,由于需要计算n×n的注意力矩阵,其计算复杂度和显存占用都随序列长度平方增长。当序列长度达到26万甚至100万时,直接计算全注意力在工程上几乎不可行——仅存储26万×26万的注意力矩阵(BF16精度)就需要约127GB显存。
线性注意力的核心思想则是用核函数(Kernel Function)φ替代Softmax操作,将注意力计算重写为 Attention(Q,K,V) = φ(Q)(φ(K)^TV)。关键的数学洞察在于:通过改变矩阵乘法的结合顺序,先计算φ(K)^TV得到一个与序列长度无关的中间矩阵,再与φ(Q)相乘,从而将复杂度从O(n²)降至O(n)。这种形式还允许将注意力计算转化为递归形式,像RNN一样逐步更新隐状态,特别适合流式推理和超长序列处理。代表性工作包括Katharopoulos等人提出的Linear Transformer(使用ELU+1作为核函数)、RWKV(结合了RNN的线性复杂度和Transformer的并行训练能力,通过指数衰减机制隐式建模位置关系)、微软的RetNet(引入多尺度指数衰减的保留机制)以及Mamba/Mamba2(基于选择性状态空间模型,通过输入依赖的选择机制实现高效序列建模)。线性注意力的代价是表达能力有所下降,尤其在需要精确"检索"特定位置信息的任务(如"第三段的第一句话说了什么")上可能不如全注意力,因为核函数的近似无法完美复现Softmax的尖锐注意力分布。
二者按 3:1 比例交替循环,本质是让线性注意力层处理大部分"流水线式"的信息传递和局部特征提取,同时每隔三层用一次全注意力进行全局信息校准和精确检索。这种混合设计的直觉是:并非每一层都需要全局注意力——在大多数层中,信息的流动是渐进和局部的,线性注意力足以胜任;但周期性地插入全注意力层可以纠正线性注意力可能累积的信息损失,确保模型在任何深度都能访问到序列中的关键信息。类似的混合架构思路在Jamba(Mamba+Attention混合)和Zamba等模型中也有体现,正在成为处理超长序列的一种工程共识,在"精度"和"长上下文效率"之间寻找平衡点。
此外,该模型默认开启思考模式(Thinking Mode),同时支持关闭思考,并通过 Reasoning Effort 参数控制推理强度。思考模式的核心理念源自OpenAI的o1系列模型所推广的"链式思考"(Chain-of-Thought, CoT)推理范式。CoT最早由Google Brain团队的Jason Wei等人在2022年的论文中系统性地提出,他们发现通过在提示中加入"Let's think step by step"等引导语,可以显著提升大模型在算术推理、常识推理等任务上的表现。OpenAI的o1系列则将这一思想内化为模型的原生能力——模型不是直接输出答案,而是先在内部生成一段显式的推理过程,逐步分析问题、分解子任务、检验中间结果的正确性,然后再给出最终答案。这种方式在数学推理、代码生成、逻辑分析等复杂任务上能显著提升准确率(某些数学基准上的提升可达20-30个百分点),但代价是生成的token数量大幅增加(可能是非思考模式的5-10倍),推理延迟和计算成本随之上升。
Reasoning Effort参数的引入则是对这一问题的工程化解决方案,类似于给模型一个"花多少时间思考"的预算。低Reasoning Effort设置下,模型可能跳过详细的推理步骤直接给出答案,适合简单的信息检索或格式转换任务;高设置下则生成完整的推理链,适合复杂的数学证明或多步规划任务。DeepSeek-R1、Claude 3.5等模型也提供了类似的思考深度控制机制,反映了行业对"推理效率-推理质量"权衡的共同关注。这意味着开发者可以根据任务复杂度灵活调节——简单任务关闭深度推理以提速和节省成本,复杂任务则开启完整思考链以获取最佳结果。这种可控推理正在成为新一代模型的标配。
官方跑分解读:Agent能力全面提升
需要特别提醒的是,以下数据均来自官方模型卡的自报结果,尚不等同于第三方独立复现,读者应保持审慎。
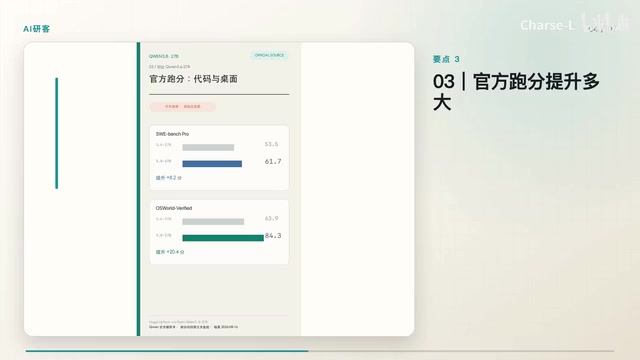
对比上一代模型,几项关键基准的提升如下:
- SWE Bench Pro(软件工程能力):从 53.5 提升到 61.7
- OS World Verified(桌面智能体):从 63.9 大幅跃升至 84.3
- Web Arena Verified(网页操作):从 48.8 提升到 64.8
- Cowork Bench(协作任务):从 61.0 提升到 70.7
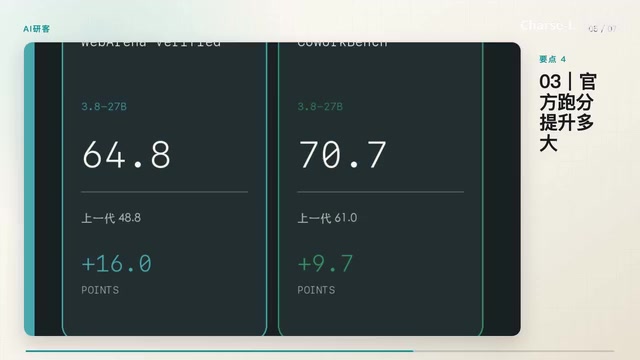
这些基准测试代表了AI评测从"回答问题"向"完成任务"演进的重要趋势,反映了行业对AI实际应用能力的关注重心正在发生根本性转移。
SWE Bench由普林斯顿大学的Carlos Jimenez等研究者于2023年提出,其核心设计理念是:从GitHub上的知名开源项目(如Django、scikit-learn、sympy等)中收集真实的Issue和对应的Pull Request,然后要求模型仅根据Issue描述,自动定位需要修改的文件、理解现有代码逻辑并生成正确的代码补丁。SWE Bench Pro是其进阶版本,包含更复杂的多文件修改和跨模块依赖场景。这本质上测试的是模型作为"AI软件工程师"的端到端工程能力——不仅要理解自然语言描述的需求,还要在数万行的代码库中导航、理解代码架构、编写符合项目规范的修改,最终通过项目的单元测试。
OS World由卡内基梅隆大学、香港大学等机构联合开发,要求模型在真实的Ubuntu/Windows/macOS操作系统虚拟机中完成超过360种实际操作任务(如"在LibreOffice中创建一个柱状图"、"将桌面壁纸更改为指定图片")。模型通过截图理解当前屏幕内容(需要视觉理解能力),然后生成鼠标点击坐标和键盘操作指令来与操作系统交互,任务完成度通过自动化脚本检查最终系统状态来评判。
Web Arena由卡内基梅隆大学开发,在复刻的真实网站环境(包括电商、论坛、代码托管平台、内容管理系统等)中测试模型的网页浏览和操作能力,如"在Reddit上找到最热门的帖子并发表评论"、"在GitLab上创建一个新仓库并配置CI/CD"。
这些基准共同构成了评估AI Agent"在真实环境中自主完成复杂任务"能力的核心指标体系,与传统的MMLU(大规模多任务语言理解,测试知识广度)、HumanEval(测试代码生成的函数级正确性)、MATH(测试数学解题能力)等基准有着本质区别——它们测试的不是模型"知道什么"或"能生成什么",而是模型"能在真实环境中做什么"。这种范式转变意味着模型不仅需要语言理解和生成能力,还需要视觉感知、空间推理、工具使用、错误恢复和多步规划等综合能力。
这组数据最有价值的地方,并不在于某个单项刷榜,而在于代码、桌面、网页和协作任务同步提升。这清晰地表明模型的优化目标明显偏向 Agent 方向——即一个能"看"(视觉理解)、能"推理"(链式思考)、能"操作工具"(生成精确的操作指令)的智能体。尤其是 OS World Verified 从 63.9 到 84.3 的跨越幅度(提升超过20个百分点),反映出它在真实桌面环境的自动化操作能力有了实质性突破,这意味着模型在屏幕内容理解、UI元素定位和多步操作规划上都有了显著改善。
本地部署Qwen3 27B的真实硬件成本
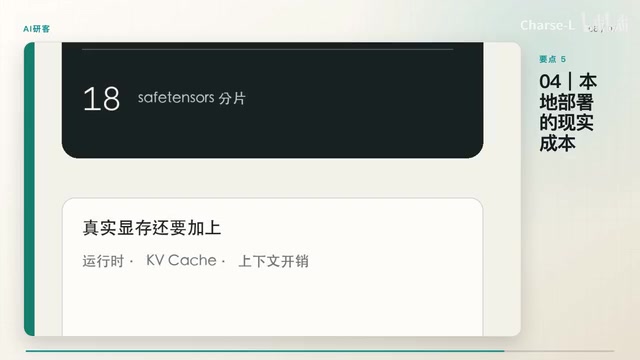
对于希望本地部署的开发者,需要认真评估硬件门槛。模型的 BF16 权重由 18 个分片组成,索引记录的总大小约 55.6GB。这仅是权重本身的体积,真实部署时还需额外考虑运行时开销和 KV Cache 占用,因此普通消费级显卡运行起来并不轻松。
BF16(Brain Floating Point 16)是Google Brain团队于2018年提出的16位浮点数格式,专门为深度学习工作负载设计。在IEEE 754浮点标准中,FP32使用1位符号位、8位指数位和23位尾数位;FP16则使用1位符号位、5位指数位和10位尾数位。BF16的独特设计在于它保留了FP32的8位指数位(提供相同的数值动态范围,约±3.4×10³⁸),但将尾数位从23位压缩到仅7位。这意味着BF16的精度不如FP16(FP16有10位尾数),但数值范围远超FP16(FP16的5位指数仅支持约±65504),因此在训练中不容易出现梯度溢出(Gradient Overflow)或下溢(Underflow)问题,已成为大模型训练和推理的主流精度格式。NVIDIA从Ampere架构(A100)开始提供原生BF16 Tensor Core支持。一个BF16参数占2字节,27B参数的模型权重约需54GB(27×10⁹×2÷1024³≈50.3GB,考虑到嵌入层、层归一化等额外参数,总计55.6GB合理),与文中提到的数据基本吻合。
值得特别说明的是,KV Cache(键值缓存)是推理时另一个不可忽视的显存消耗来源。在自回归生成过程中,模型每生成一个新token都需要与之前所有token进行注意力计算。为避免重复计算,推理引擎会缓存已处理token的Key和Value向量。对于一个64层、5120隐藏维度的模型,假设使用GQA(分组查询注意力)并且KV头数为标准配置,在26万token上下文下,KV Cache本身就可能占用数十GB显存。这也是为什么超长上下文模型的实际部署显存需求往往远超权重本身的大小。业界常用的优化手段包括PagedAttention(vLLM框架的核心技术,借鉴操作系统虚拟内存管理思想对KV Cache进行分页管理)、KV Cache量化(将缓存的Key/Value从BF16压缩到FP8或INT8)以及前文提到的线性注意力机制(从根本上将KV Cache的增长从线性降低为常数)。
官方同时提供了 FP8 量化版本以降低显存需求。FP8(8位浮点)是更激进的量化方案,每个参数仅占1字节,理论上可将显存需求减半至约28GB。FP8有两种常见格式:E4M3(4位指数+3位尾数,适合前向推理,精度较高)和E5M2(5位指数+2位尾数,适合反向传播,范围更大)。NVIDIA从Hopper架构(H100/H200)开始提供原生FP8 Tensor Core支持,并通过Transformer Engine库实现自动混合精度推理;Ada Lovelace架构(RTX 4090/4080)也提供了部分FP8计算支持,但其Tensor Core的FP8吞吐量不如H100。AMD的MI300X同样支持FP8推理。但量化后的实际速度、显存占用和精度损失,仍应以你自己的硬件实测为准——FP8将每个参数的数值精度压缩到仅3位有效数字,可能导致模型在某些对精度敏感的任务上出现性能下降,尤其是涉及精确数值计算的数学推理、需要区分细微语义差异的长尾知识问答,以及依赖注意力权重精确分布的长上下文检索任务。
此外,社区和推理框架(如llama.cpp、vLLM、SGLang等)还提供了更多量化方案:INT4和INT8整数量化将权重映射为4位或8位整数;GPTQ(GPT Quantization)是一种基于逐层最优脑量化的后训练量化方法,通过近似二阶信息(Hessian矩阵)最小化量化误差;AWQ(Activation-aware Weight Quantization)则观察到不同权重通道对激活值的敏感度差异巨大,通过保护少数关键通道来减少量化损失;GGUF是llama.cpp项目定义的模型格式,支持从Q2到Q8的多种量化级别,可在纯CPU上运行。这些方案可以进一步将模型压缩到15-20GB级别以适配RTX 4090(24GB)甚至RTX 3090等消费级显卡,但精度损失也会更加显著。量化收益因硬件架构(GPU的INT4/INT8计算单元效率差异很大)、推理框架的实现优化和具体任务类型而异,不能一概而论。总体而言,55.6GB 的 BF16 体量意味着它更适合专业级显卡(如NVIDIA A100 80GB、H100 80GB)或多卡环境(双RTX 4090通过NVLink或PCIe桥接),而非入门级设备。
总结:多模态与Agent能力压进可开源的27B稠密模型
Qwen3 27B 的核心意义,在于把原生多模态、超长上下文和 Agent 操作能力同时压进一个仍可开源部署的 27B 稠密模型中。
相比动辄千亿参数的超大模型(如GPT-4据传约1.8万亿参数的MoE架构、Llama 3.1 405B等),它在保持较强能力的同时,显著降低了进入真实工程场景的门槛——对于需要私有化部署、注重数据安全和可控性的团队而言,这样的"能力密度"(即单位参数所承载的实际任务完成能力)具有很强的实用价值。27B的参数量处于一个微妙的"甜蜜点":足够大以保持强大的基础能力,又足够小以在单机专业显卡上完成部署,避免了多机分布式推理带来的网络通信开销和系统复杂度。
当然,正如前文反复强调的,官方跑分的亮眼数字仍需要社区的独立复现来验证。历史上不乏模型官方基准表现优异但在社区实测中大打折扣的案例(可能源于评测数据泄露、特定提示词优化或评测环境差异)。在真正的第三方评测结果(如LMSYS Chatbot Arena的ELO排名、社区的Open LLM Leaderboard成绩等)出炉之前,理性看待、亲自实测,才是评估一款新模型最可靠的方式。
核心要点
相关推荐

LynnReal-Omni:32B统一视频扩散模型开源,四步生成多任务全覆盖
LynnReal-Omni 是基于 MiniMax H3 架构的 32B 统一视频扩散模型,支持文生视频、图生视频、姿态引导、视频修复等多任务,四步快速生成,Flash 版单张 H100 上 377ms 完成 540p 视频,权重与 ComfyUI 节点已开源。

Anthropic联合创始人:AI"紧急停止开关"或应强制立法
Anthropic联合创始人向BBC表示,AI系统的"紧急停止开关"(kill switch)可能需要通过法律强制推行。本文分析这一呼吁背后的产业逻辑、技术挑战以及监管与创新之间的张力。

AI数据中心建设热潮,正冲击工业创伤深重的城市
AI数据中心建设热潮正与曾受重工业创伤的城市社区激烈碰撞。以费城为例,全国性反对声浪聚焦能耗、水资源与环境公平问题,揭示AI增长与地方利益的结构性冲突。