RAG知识冲突分类:决策模型能否替代大语言模型?
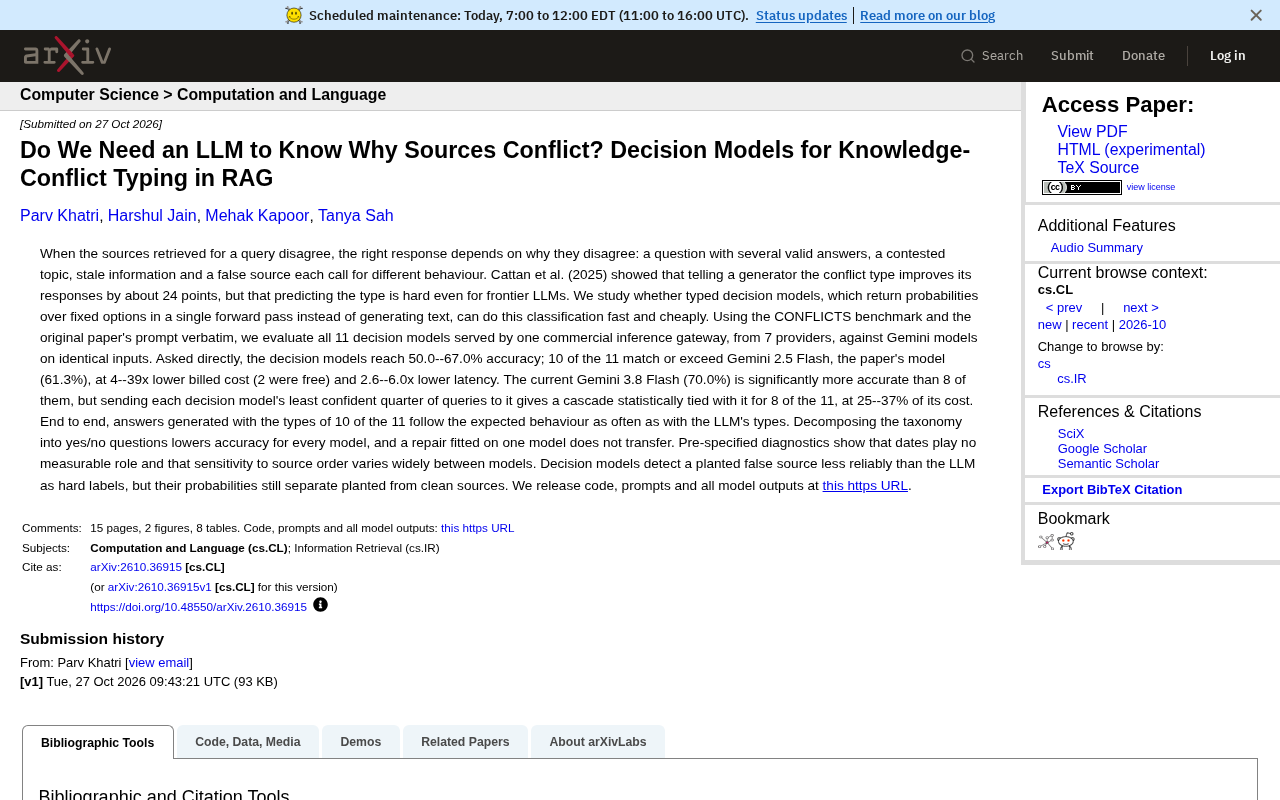
小型决策模型可低成本完成RAG知识冲突分类,级联大模型兼顾质量与开销。
文章探讨了用类型化决策模型替代大语言模型完成 RAG 知识冲突类型分类的可行性。研究在 CONFLICTS 基准上评估了来自 7 家提供商的 11 个决策模型,直接询问时准确率为 50.0%–67.0%,其中 10 个达到或超过 Gemini 2.5 Flash 的 61.3%,而成本低 4–39 倍、延迟低 2.6–6.0 倍。面对更强的 Gemini 3.8 Flash(70.0%),研究者设计了级联策略:将每个决策模型最不确定的四分之一查询交给大模型处理,结果 11 个模型中有 8 个在统计上与纯 Gemini 3.8 Flash 持平,成本仅为其 25–37%。端到端验证表明,决策模型输出的冲突类型引导生成的效果与使用 LLM 类型相当。文章也指出若干局限:拆解为是/否问题会降低准确率、修复方案无法跨模型迁移、硬标签虚假来源检测不如 LLM 可靠,但概率输出仍携带有效信号。
当检索增强生成(RAG)系统检索到的多个来源相互矛盾时,生成器需要知道冲突的类型才能做出恰当回应——是存在多个有效答案、话题本身有争议、信息已过时,还是某个来源是虚假的。Cattan 等人的研究(2025)表明,将冲突类型告知生成器可使其回答质量提升约 24 个百分点,但即便是前沿大语言模型(LLM),准确预测冲突类型也相当困难。
那么,完成这项分类任务是否必须依赖 LLM?一篇最新论文探讨了使用类型化决策模型(typed decision models)来识别知识冲突类型的可能性。这类模型在单次前向传播中直接输出固定选项上的概率分布,而非生成文本,因而速度更快、成本更低。
决策模型 vs. Gemini:准确率与成本的双重考量
研究团队使用 CONFLICTS 基准和原论文的提示词(verbatim),对来自 7 家提供商、由一个商业推理网关提供的全部 11 个决策模型进行了评估,并在相同输入上与 Gemini 系列模型进行对比。
直接询问时,决策模型的准确率落在 50.0%–67.0% 区间。其中 10 个模型达到或超过了论文所用的 Gemini 2.5 Flash(61.3%),而计费成本却低 4–39 倍(其中 2 个模型免费),延迟低 2.6–6.0 倍。当前版本的 Gemini 3.8 Flash 准确率达到 70.0%,显著优于 8 个决策模型。但研究者设计了一种级联策略:将每个决策模型最不确定的四分之一查询交给 Gemini 3.8 Flash 处理,结果 11 个模型中有 8 个在统计上与纯 Gemini 3.8 Flash 持平,而成本仅为其 25–37%。
这一发现的意义在于:对于大量“简单”的冲突类型判断,小型决策模型足以胜任;只有真正困难的边缘案例才需要动用昂贵的大模型。级联方案在保持质量的同时大幅压低了推理开销。
类型化决策模型(typed decision models)是一类在固定标签空间上直接输出概率分布的判别式模型。与自回归生成文本的 LLM 不同,它在单次前向传播中计算每个候选类别的 logits 并做 softmax,因此输出天然是封闭选项上的概率向量,而非自由文本。这类模型通常基于较小的编码器架构(如 DeBERTa、ModernBERT 或小型指令微调模型),推理时无需逐 token 解码,因而延迟低、吞吐高。其代价是缺乏 LLM 的开放世界知识与推理能力,面对需要多步推断或外部常识的困难样本时表现受限。这正是文中级联策略的动机:用决策模型覆盖高置信度的简单样本,把低置信度样本路由给 LLM。
CONFLICTS 基准是 Cattan 等人(2025)为评测 RAG 系统中知识冲突处理而构建的数据集,涵盖多种冲突类型——多个有效答案、话题争议性、信息过时以及虚假来源等。该基准要求模型在给定检索来源与查询的条件下判断冲突类别,并配有标准化提示词与评估协议。本文沿用其原始提示词(verbatim)以保证可比性,使得决策模型与 Gemini 系列在同一输入、同一标签体系下对照,避免因提示词差异引入的偏差。
端到端表现:类型标签的实际效用
分类准确率只是中间指标,研究者进一步验证了端到端效果:使用 10 个决策模型输出的冲突类型来引导生成,其回答遵循预期行为的频率与使用 LLM 类型时相当。这说明决策模型提供的类型标签在实际生成环节具有可用性,并非只是基准测试上的数字游戏。
然而,研究也揭示了几个值得警惕的局限。将分类体系分解为一系列是/否问题后,所有模型的准确率均有下降;在一个模型上拟合的修复方案无法迁移到其他模型。预先设定的诊断显示,日期信息在分类中未起可测量的作用,而模型对来源顺序的敏感度差异很大。此外,决策模型作为硬标签检测植入的虚假来源时不如 LLM 可靠,但其输出的概率仍能区分植入来源与干净来源——这意味着概率信息本身携带了有价值的信号。
级联策略(cascading / cascade routing)是一种按置信度分流的推理架构:先用廉价模型处理全部请求,再依据其输出概率的不确定性(如最大类别概率、熵或 margin)筛选出最不可靠的一部分查询,转交昂贵的大模型处理。本文采用“最不确定的四分之一”作为路由阈值,即把决策模型 top-1 概率最低的 25% 查询交给 Gemini 3.8 Flash。级联的关键在于选择性风险控制——只要高置信度样本的分类足够准确,整体质量就能接近纯大模型方案,而平均成本大幅下降。其代价是引入一个可调的超参数(路由比例),需要按任务与成本预算标定;此外,若决策模型的置信度校准不佳,路由判断本身会失真,因此实践中常需温度缩放等校准手段。
实践启示:何时该用决策模型?
这项研究为 RAG 系统的工程实践提供了清晰指引。对于知识冲突类型的常规分类,决策模型在成本与延迟上的优势显著,尤其适合高吞吐场景。级联架构则提供了一种务实的折中:用决策模型处理大部分查询,将不确定的少数派交给大模型兜底。
但研究同时提醒,分类体系的拆解方式会显著影响性能,且模型间的修复策略不可通用,这意味着部署时需要针对具体模型和任务进行验证。虚假来源检测仍是决策模型的短板,在安全性要求高的场景中,硬标签判断或许仍需依赖 LLM。
研究团队已在 GitHub 上公开了代码、提示词和全部模型输出(https://github.com/Parv17k/decision-models-conflict-typing),为后续复现和扩展提供了基础。
相关推荐
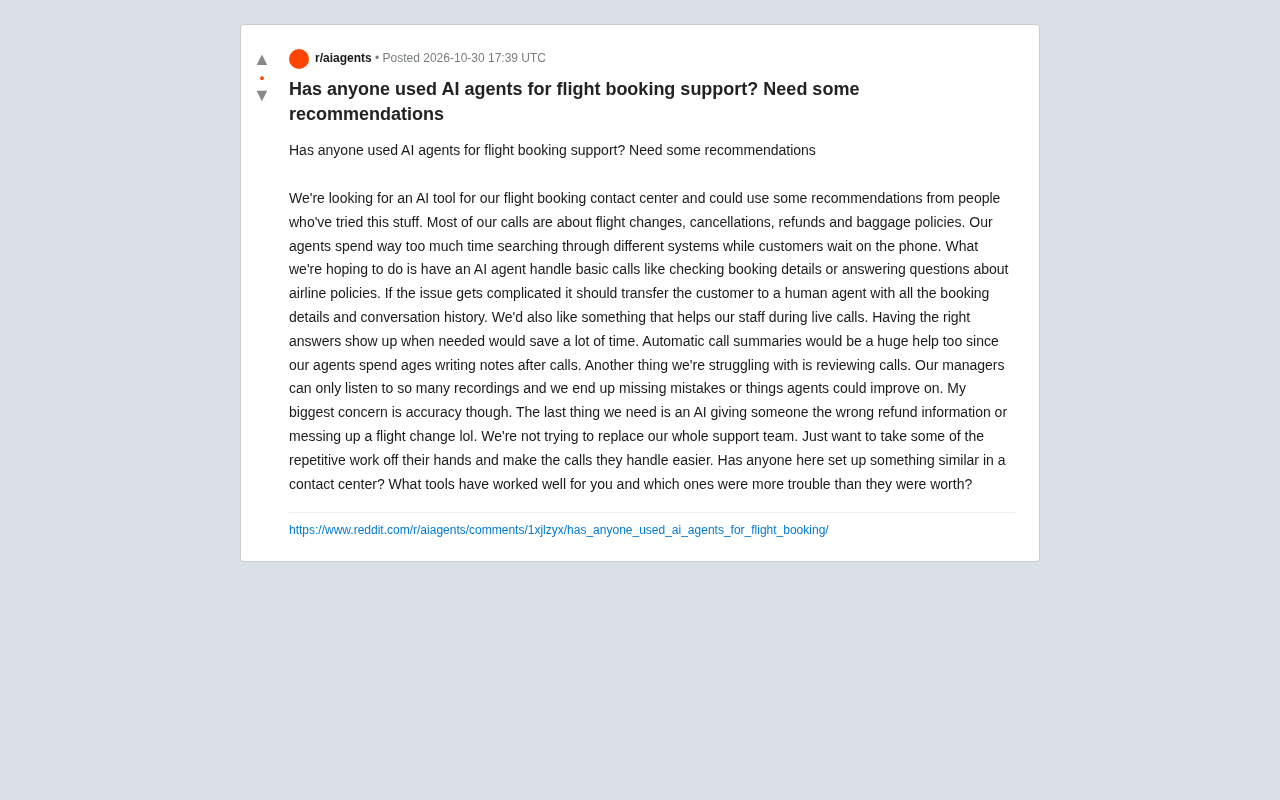
机票预订客服引入AI Agent:真实需求与落地难点
从Reddit真实提问出发,拆解机票预订呼叫中心引入AI Agent的四类需求:基础问答、座席辅助、通话摘要与质检,并分析准确性顾虑与转人工边界的设计要点。

Vercel 统一运行时缓存:Data Cache 并入 Runtime Cache
Vercel 将 Data Cache 并入 Runtime Cache,统一 Next.js fetch 缓存、unstable_cache、getCache 与 use cache: remote 的存储配额与计费,Pro 和 Enterprise 项目获得更大存储空间,缓存读写开始按 Runtime Cache 定价计费。

谷歌卫星AI服务器升空:Gemma模型在轨生成首条回复
谷歌宣布其搭载TPU的卫星成功启动,板载Gemma 4模型从太空生成首条回复,完成在轨AI推理验证。本文分析太空AI服务器的技术路径、现实约束及对边缘计算与卫星遥感的意义。