让AI读懂司法解释:德国宪法法院句级标注新基准

研究构建德国宪法法院句级标注基准,评测大模型识别法律解释准则的能力,F1值介于70至79之间。
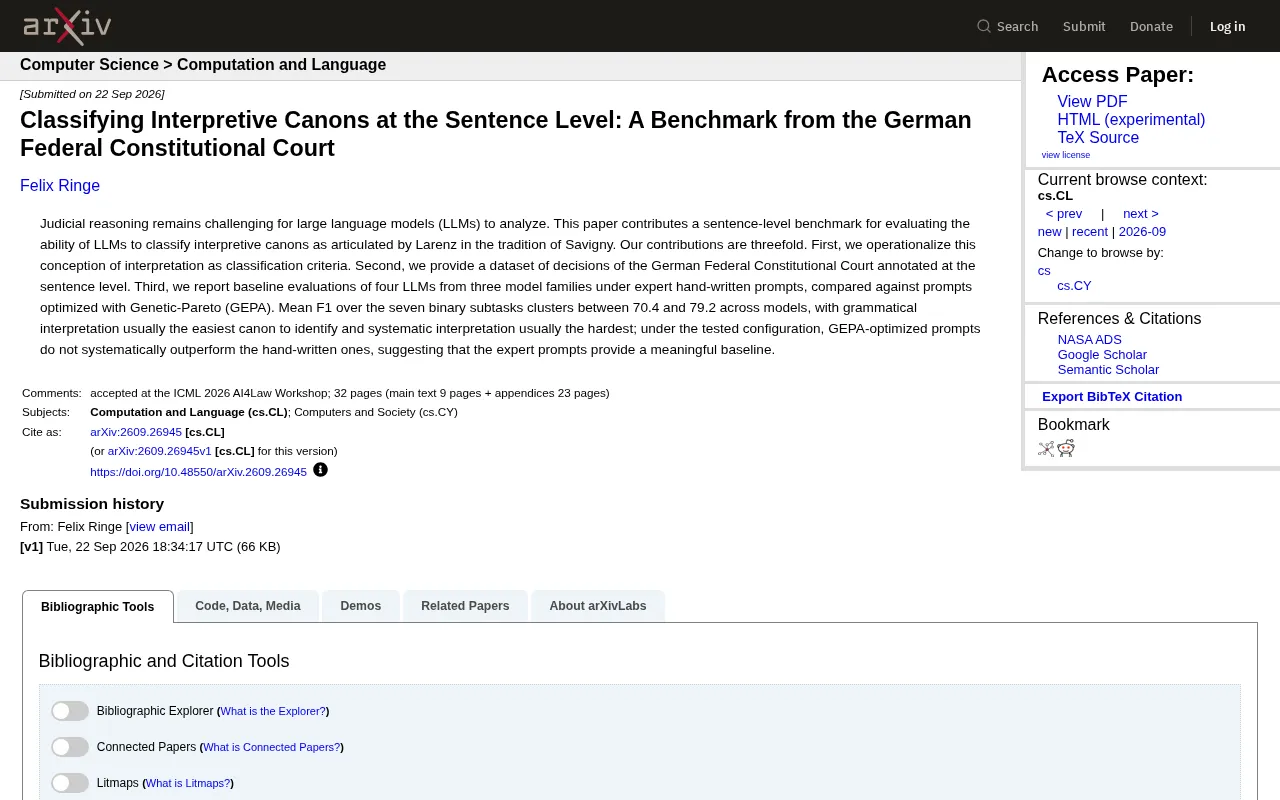
这篇arXiv论文针对大语言模型在司法推理中的短板,构建了一个基于德国联邦宪法法院判决的句级评测基准,专门检验模型识别「解释准则」的能力。研究将萨维尼-拉伦茨传统的法律解释方法论——语法、体系、历史、目的等维度——操作化为可机器判别的分类标准,并公开了细粒度标注数据集。四款主流大模型在七个二分类子任务上的平均F1值集中在70.4至79.2之间:语法解释因特征显性而最易识别,体系解释因需跨条文推理而最难。值得注意的是,经遗传-帕累托算法自动优化的提示未能系统性超越法学专家手写提示,表明在高度专业化任务中,领域知识仍是构造有效提示的关键。该研究将法律AI评测下沉至推理方法层面,为大陆法系司法推理研究提供了精细化能力标尺。
当大模型遇上司法推理
司法推理一直是大语言模型(LLM)难以攻克的领域。法律条文的解释不仅涉及字面含义,还牵扯到立法目的、体系结构与历史沿革等多重维度。一篇发表于arXiv的最新研究(arXiv:2609.26945v1)针对这一难题,提出了一个句级(sentence-level)评测基准,专门检验大模型识别「解释准则」(interpretive canons)的能力。
这项工作的理论根基来自德国法学传统——以萨维尼(Savigny)为源头、由拉伦茨(Larenz)系统阐述的法律解释方法论。这套体系将法律解释划分为语法解释、体系解释、历史解释、目的解释等若干类别,是大陆法系司法推理的核心工具。研究者的目标,是把这套抽象的法学理论转化为机器可以判别的分类标准。
萨维尼(Friedrich Carl von Savigny)是19世纪德国历史法学派的奠基人,他在《当代罗马法体系》中首次系统提出法律解释的四要素框架:文法要素(词义)、逻辑要素(条文内部结构)、历史要素(立法背景)与体系要素(法律秩序中的位置)。卡尔·拉伦茨(Karl Larenz)在20世纪将这一框架进一步精炼,加入目的论解释,形成了大陆法系法学教育中广泛采用的五元解释体系。与英美法系依赖判例推理(case-based reasoning)不同,大陆法系更强调从成文法条文出发进行演绎推理,因此识别法官在论证中运用了哪种解释方法,对于理解判决逻辑至关重要。这也是将该传统操作化为机器学习任务的研究价值所在。
三项核心贡献
论文明确列出了三方面贡献。其一,将拉伦茨对法律解释的概念操作化(operationalize),转化为一套可执行的分类判据。这一步骤本身就颇具挑战——如何把法学家笔下富有弹性的解释方法,拆解成边界清晰、可标注的类别,是整个研究的基础。
其二,研究者构建并公开了一个数据集,内容为德国联邦宪法法院(German Federal Constitutional Court)的判决,并在句子层级进行了细粒度标注。选择宪法法院的判决作为语料,意味着数据本身具有极高的法律推理密度和专业性。
其三,论文给出了基线评测结果,覆盖来自三个模型家族的四款大模型,并对比了两种提示方式:由专家手写的提示,以及经过遗传-帕累托算法(Genetic-Pareto, GEPA)优化的提示。
遗传-帕累托算法(Genetic-Pareto Algorithm, GEPA)是一种将进化计算与多目标优化结合的提示自动优化方法。其核心思路是将提示词视为可演化的个体,通过交叉、变异等遗传操作生成候选提示种群,再以帕累托前沿(Pareto front)准则筛选在多个评价指标上均衡表现的最优解,从而避免单一目标优化导致的过拟合。这类自动提示优化方法的优势在于不依赖人工专业知识,理论上可跨领域迁移。然而本研究的结果显示,在法律解释这类需要深厚领域理解的任务上,算法自动生成的提示并未超越法学专家的手写版本,为该类方法的适用边界提供了一个具体的实证案例。
评测结果:专家提示依然稳健
从数据来看,七个二分类子任务的平均F1值在各模型间聚集于70.4到79.2之间。这一区间说明大模型已具备一定的司法解释识别能力,但距离可靠应用仍有明显差距。
哪种解释最好识别,哪种最难
研究发现了一个有意思的规律:语法解释(grammatical interpretation)通常是最容易被识别的准则,而体系解释(systematic interpretation)往往是最难的。这与直觉相符——语法解释聚焦于文本的字面用词,特征相对显性;而体系解释需要模型理解条文在整个法律体系中的位置与逻辑关系,涉及跨句、跨条文的推理,难度自然更高。
体系解释(systematic interpretation)要求解读者将单一条文置于整部法律乃至整个法律体系的脉络中加以理解——例如,某一概念在民法总则中的定义是否应当延伸适用于行政法规,或某条款与宪法基本权利条款之间存在怎样的逻辑张力。这种推理跨越单个句子,需要对法律文本的宏观结构有整体性把握,本质上是一种多跳推理(multi-hop reasoning)任务。对于大模型而言,这不仅需要理解当前句子的语义,还需要在上下文窗口内维持跨条文的引用关系,并具备法律体系结构的隐性知识。这解释了为何体系解释在所有子任务中一致表现为最难识别的类别。
GEPA优化提示未能系统性胜出
一个值得玩味的结论是:在本次测试配置下,GEPA优化后的提示并没有系统性地超越专家手写提示。这一发现有双重含义。一方面,它表明领域专家凭借法学知识撰写的提示,本身就构成了一个有意义、有竞争力的基线;另一方面,也提示自动化提示优化方法在高度专业化、需要深厚领域知识的任务上,尚不能简单替代人类专家的判断。
这项研究的价值与局限
这项工作的意义在于,它把「法律AI」的评测从宏观的判决预测、法条检索,下沉到了更细粒度的推理方法识别层面。理解一段司法论证究竟运用了哪种解释准则,是理解法官为何如此判决的关键一环。对于希望将大模型引入法律辅助场景的开发者而言,这样的句级基准提供了更精确的能力标尺。
同时也要看到局限:70到80之间的F1水平意味着实际错误率仍不容忽视,尤其在体系解释这类复杂任务上。法律推理对准确性要求极高,当前的模型表现更适合作为研究参照,而非直接落地的判决辅助工具。
随着领域数据集的公开和评测标准的确立,后续研究有望在这一基准上持续迭代,推动大模型对大陆法系司法推理的理解走向更深。
相关推荐

WorkBuddy教程:从提示词到AI工作流实战
WorkBuddy教程核心内容梳理:桌面AI Agent与聊天机器人的本质区别、WorkBuddy与CodeX在门槛、生态和成本上的对比、三个新手认知误区,以及从AI漫剧实战到工作流迁移的完整学习路径。
多Agent协作实战:主Agent调度Codex与Claude Code
B站UP主小山在「从零实现自己的agent」第十一期中,演示了主Agent调度Codex与Claude Code的多Agent协作方案:Codex负责深图与调研,Claude Code负责编码与UI落地,通过适配器和SDK派发任务,双通道回传进度与结果,实测完成特斯拉3D飞车复现视频。
六类AI Agent全解析:开源智能体部署与选型指南
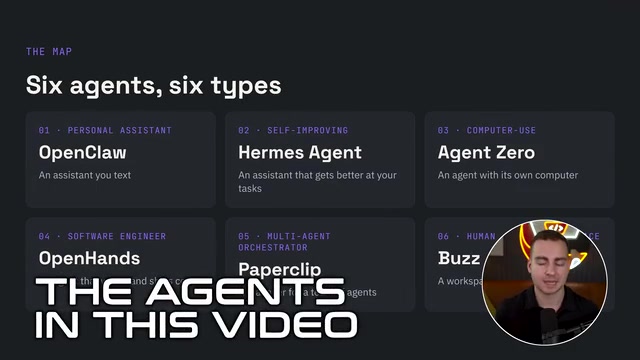
系统拆解OpenClaw、Hermes、Agent Zero、OpenHands、Paperclip、Buzz六类开源AI智能体,讲清底层架构与优缺点,并给出VPS部署与选型建议。