让轮询 Agent 真正 7×24 运行:从会话内定时到外部调度
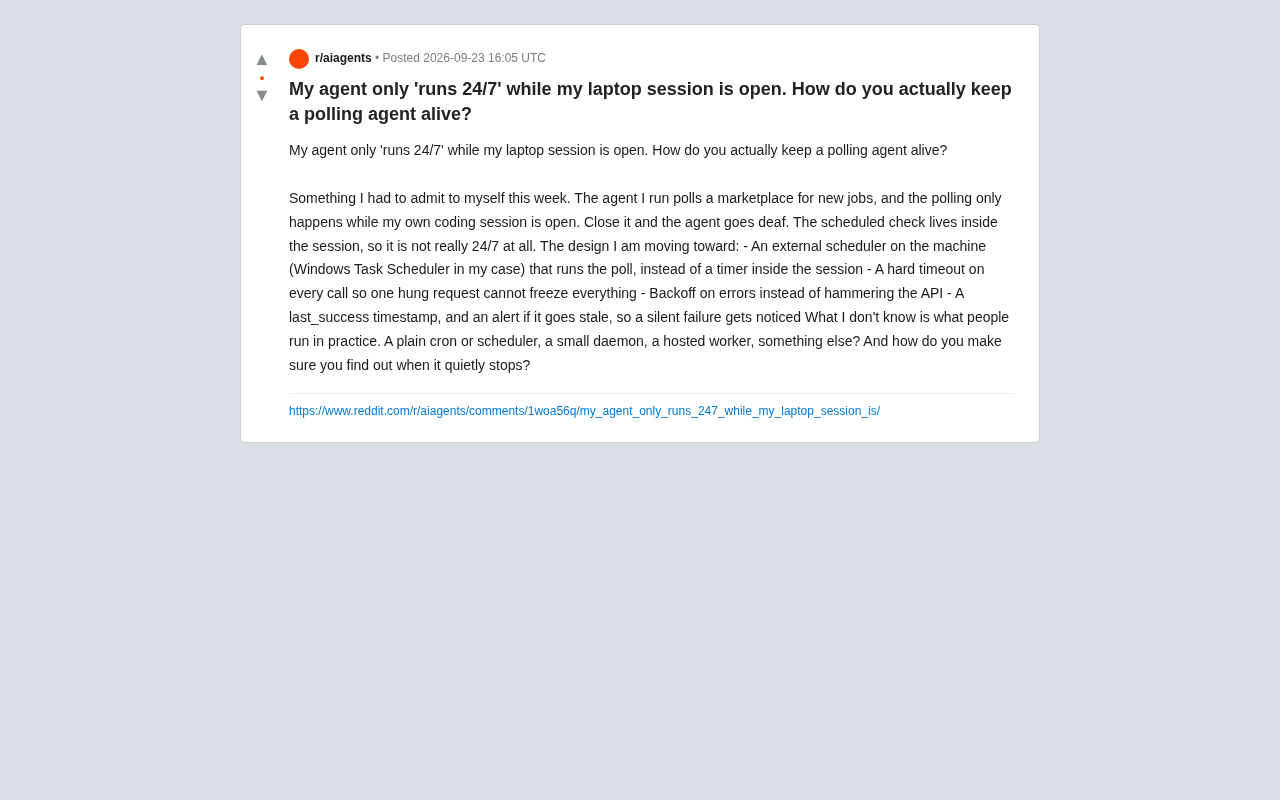
会话内定时器只是开发原型,真正的7×24 Agent需要外部调度、超时退避与独立心跳监控。
一位开发者发现自己的「全天候」Agent实际上只在终端开着时才运行——调度逻辑写在会话内的`while True + sleep`循环里,终端一关即失效。这篇文章以此为切入点,系统梳理了构建可靠长期运行Agent的四个核心工程约束:一是用cron、systemd timer、Task Scheduler或托管Worker等外部调度器取代会话内定时器,使每次执行成为独立短生命周期任务;二是对每个外部调用设置硬性超时,防止无限挂起;三是失败时采用指数退避重试,避免触发API限流;四是通过记录`last_success`时间戳并配合独立的Dead man's switch心跳监控,确保静默失败能被及时感知。文章强调,若业务真正要求7×24可用,最终应将Agent迁移到脱离本地设备的托管环境。
一个常见的自欺欺人:Agent 只在你开着终端时才「活着」
一位 Reddit 开发者最近坦白了自己踩过的坑:他写了一个轮询市场平台新任务的 Agent,号称「7×24 全天候运行」,但实际上定时检查逻辑是嵌在他自己的编码会话里的。会话一关,Agent 就「聋了」——不再拉取任何新数据。
这个问题看似初级,却极具代表性。很多人第一次搭建自动化 Agent 时,都会把调度逻辑写成一个会话内的定时器(比如脚本里的 while True + sleep,或者笔记本上跑着的一个 Python 进程)。它在开发阶段跑得很好,给人一种「已经在持续运行」的错觉。可一旦关掉终端、合上笔记本、或者系统休眠,整个轮询就静默失效了。
真正的「长期运行」不该依赖于某个交互式会话的存活。这位开发者意识到问题后,给出了一套正在迁移的设计方案,值得所有做 Agent 自动化的人参考。
从「会话内定时器」到「外部调度器」
原帖作者提出的核心改造,是把调度权从会话内部交给操作系统级别的外部调度器。他自己用的是 Windows 任务计划程序(Task Scheduler),由系统按计划触发一次轮询脚本,而不是让一个常驻会话里的计时器去负责。
这个思路的关键区别在于:
- 会话内定时器:进程存活 = 任务存活,进程一死全部停摆,且死了往往没人知道。
- 外部调度器:每次轮询是一个独立的、短生命周期的任务,由系统保证按时拉起,即使上一次执行崩了也不影响下一次触发。
在实践中,不同平台有各自成熟的选择:
常见的外部调度方案
- Linux/macOS:cron 或 systemd timer。cron 简单直接,systemd timer 则能提供更好的日志、依赖管理和失败重启能力。
- Windows:Task Scheduler(原帖作者的选择),可配置触发条件、失败重试和唤醒策略。
- 小型常驻守护进程(daemon):如果轮询频率极高(秒级),一个受 systemd/supervisor 管理的长驻进程可能更合适,但要配好自动重启。
- 托管的 Worker / Serverless:如云上的定时任务、Cloudflare Workers Cron、AWS EventBridge + Lambda 等。彻底摆脱对本地机器的依赖,笔记本关不关都无所谓。
选型的核心判断是:这个 Agent 到底该不该依赖你的个人设备?如果答案是「不该」,那本地调度器只是过渡方案,最终应该迁移到托管环境。
systemd timer 是 Linux 上 cron 的现代替代方案,值得单独说明。它由两个文件组成:.timer 单元定义触发时间,.service 单元定义要执行的命令。相比 cron,systemd timer 的优势在于:执行日志统一收录进 journald,可用 journalctl 直接查询;支持 OnFailure= 指令在任务失败时触发另一个单元(例如发送告警邮件);还可设置 Persistent=true,确保系统关机期间错过的定时任务在下次开机后补跑一次。对于需要可观测性和错误处理的生产 Agent,systemd timer 通常比 cron 更具优势。Serverless 定时触发(如 AWS EventBridge Scheduler + Lambda、Google Cloud Scheduler + Cloud Run)则代表另一个极端:完全托管、按执行次数计费、天然支持重试策略,缺点是冷启动延迟和调试链路更复杂,适合低频但可靠性要求高的场景。
让每一次调用都「可控且可恢复」
光有外部调度还不够。原帖作者补充的几点,才是把一个脆弱脚本变成可靠服务的关键。
硬性超时(Hard Timeout)
每一次外部调用都要设死超时。原文说得很清楚:一个挂起的请求不能把整个流程冻住。没有超时的网络请求是长期运行任务里最隐蔽的杀手——它不报错、不退出,就那么一直卡着,让你误以为程序还在正常工作。
错误退避(Backoff)
遇到错误时不要立刻疯狂重试,而应采用退避策略(比如指数退避)。持续高频地「捶打」API,轻则触发对方限流,重则被封禁。合理的退避既保护了对端,也让你的 Agent 在对方短暂故障时能优雅地等待恢复。
指数退避(Exponential Backoff) 的标准做法是:第一次失败后等待 1 秒重试,第二次失败等待 2 秒,第三次等待 4 秒,以此类推,每次等待时间翻倍,并设置一个上限(如 64 秒或 5 分钟)。为避免多个客户端在同一时刻同步重试造成「惊群效应」,通常还会叠加随机抖动(Jitter),即在退避时间基础上加减一个随机偏移量。Python 生态中 tenacity 库提供了开箱即用的退避重试装饰器;HTTP 场景下还需额外关注响应头 Retry-After,部分 API 在返回 429(Too Many Requests)时会明确告知客户端应等待多久,此时应以该值为准而非自行计算退避时间。
最容易被忽视的一环:如何知道它「悄悄停了」
原帖里最有价值的一点,是作者对「静默失败」的警惕。
他的做法是:维护一个 last_success 时间戳,如果这个时间戳变得过期(stale),就触发告警。这样即便 Agent 在某个环节悄无声息地死掉,你也能被通知到,而不是几天后才发现「怎么一条新任务都没抓到」。
这套「心跳 + 陈旧检测」的思路非常关键。自动化系统最危险的状态不是崩溃报错,而是看起来在运行,实际上什么都没干。围绕这一点,可落地的监控手段包括:
- Dead man's switch(死人开关):Agent 每次成功执行就去 ping 一个监控服务(如 Healthchecks.io、Cronitor),一旦到点没收到心跳,监控端主动告警。
- 成功时间戳落盘 + 定期校验:把
last_success写入文件或数据库,另设一个更简单的检查任务判断它是否过期。 - 执行结果落日志 + 异常告警:把每次轮询的结果和错误推送到日志系统或 IM(Slack、飞书、Telegram),异常时直接推消息。
注意监控本身也要独立于被监控的 Agent。如果告警逻辑和轮询逻辑跑在同一个会随时死掉的进程里,那它一起死了就再也没人报警——这恰恰是原帖作者一开始踩的同一个坑的翻版。
Dead man's switch(死人开关) 这一概念源自铁路安全系统:驾驶员必须持续按住控制手柄,一旦松手(即驾驶员失能),列车自动停车。迁移到软件监控领域,逻辑反转为:系统正常运行时主动发送心跳信号,监控平台若在预设时间窗口内未收到信号,则判定异常并触发告警。Healthchecks.io 是一个专为此场景设计的开源/托管服务,每个监控项会生成一个唯一 URL,Agent 成功执行后向该 URL 发送一次 HTTP GET 请求即可完成心跳上报;若超过设定周期未收到请求,平台通过邮件、Slack、PagerDuty 等渠道发出告警。这种模式的关键优势在于:监控基础设施与被监控进程完全解耦,即便被监控的机器整体宕机,监控端依然能感知到心跳中断。
一套可复用的可靠 Agent 清单
综合原帖作者的反思和社区的普遍实践,一个真正能长期运行的轮询 Agent 应该具备:
- 调度与业务解耦:用外部调度器(cron / systemd timer / Task Scheduler / 托管 Worker)触发,而不是会话内定时器。
- 短生命周期任务:每次执行独立启动、独立退出,避免长驻进程带来的状态污染和内存泄漏。
- 硬性超时:任何外部调用都有超时上限,杜绝无限挂起。
- 错误退避:失败时指数退避重试,保护 API 也保护自己。
- 心跳与陈旧告警:记录
last_success,独立监控其新鲜度,静默失败必须被感知。 - 考虑脱离本地设备:若业务真需要 7×24,最终迁移到托管环境,别把可靠性绑在一台会合盖休眠的笔记本上。
这位开发者的坦诚提醒了很多人:「7×24」不是一句口号,而是一系列具体的工程约束。会话内跑着的定时器只是一个开发原型,真要让 Agent 全天候可靠工作,得把调度、超时、退避、监控这几件事一件不落地补齐。
相关推荐
Ringg用OpenAI打造AI客服:语音呼叫解决率高达65%
Ringg基于OpenAI的GPT-5.6打造多语言AI客服智能体,可解决高达65%的客户来电,覆盖语音、聊天、WhatsApp和网页,成本较GPT-4.1降低90%。
临床AI治理难题:Concurrence如何用Unity Gateway管控万亿Token规模
临床AI几乎没有容错空间。本文解析 Concurrence 如何借助 Unity Gateway 在万亿Token规模下治理医疗AI,实现访问控制、合规审计与可观测性的统一,探讨医疗AI规模化落地的治理路径。
幂等键难题:如何处理API重试中的“僵尸进程”
发送邮件不是幂等操作,API 重试时如何避免重复发送?本文剖析基于幂等键的抢占声明机制,以及进程崩溃导致“死亡持有者”这一分布式系统经典难题的权衡与解决思路。