RNN训练提速100倍:时间并行方法攻克混沌系统重建难题
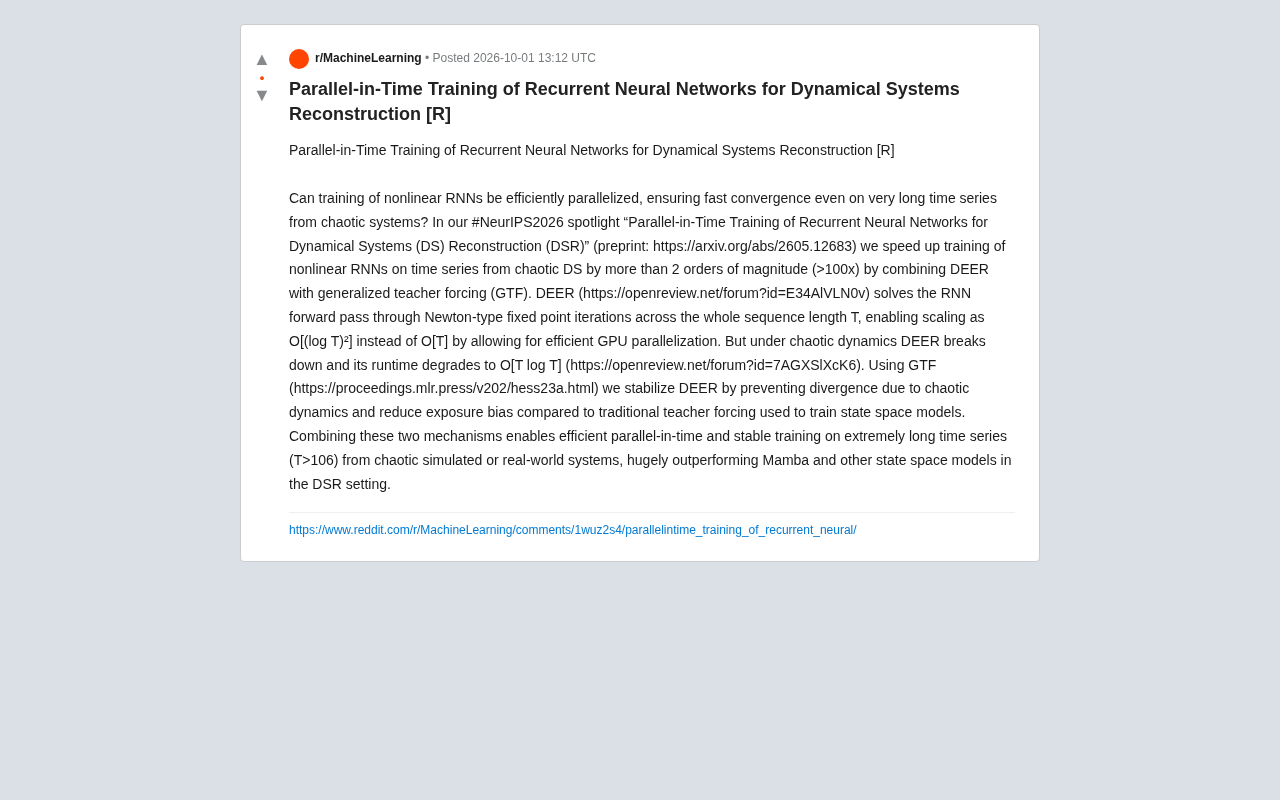
组合DEER并行迭代与GTF稳定训练,使RNN在混沌长序列上的训练速度提升超100倍。
这篇入选NeurIPS 2026 Spotlight的论文针对RNN训练在超长混沌时间序列(T>10^6)上的串行瓶颈,提出将DEER并行不动点迭代与广义教师强制(GTF)组合使用的解决方案。DEER将序列前向传播转化为大型方程组的并行求解,理论复杂度从O[T]降至O[(log T)²],但混沌动力学的指数级误差放大会导致其迭代不收敛;GTF通过混合真实观测与模型预测,将DEER的迭代稳定下来并同步减少暴露偏差。两者结合最终在动力学系统重建任务上实现了超过100倍的训练加速,并在与Mamba等状态空间模型的对比中展示出明显优势,为气象、流体力学等混沌系统建模领域提供了新的高效训练范式。
一个长期困扰RNN训练的瓶颈
循环神经网络(RNN)在处理动力学系统(Dynamical Systems)时有天然优势,它能够捕捉时间序列中的非线性依赖关系。但一个老问题始终存在:RNN的前向传播本质上是串行的,每一步计算都依赖前一步的输出。当面对来自混沌系统、长度超过百万步(T>10^6)的超长时间序列时,这种串行特性让训练变得极其缓慢,计算复杂度随序列长度 T 线性增长,即 O[T]。
这正是一篇入选 NeurIPS 2026 Spotlight 的研究所要解决的核心问题。论文《Parallel-in-Time Training of Recurrent Neural Networks for Dynamical Systems Reconstruction》提出了一套组合方法,宣称在混沌动力学系统的时间序列上,将非线性RNN的训练速度提升了超过两个数量级(>100x)。
核心思路:DEER 与 GTF 的组合
这项工作的关键在于把两种已有技术组合起来,解决各自单独使用时无法克服的难题。
DEER:把串行前向传播变成并行求解
DEER 的思路是不再逐步执行RNN的前向传播,而是把整个序列(长度为 T)的计算看作一个大型方程组,通过牛顿型不动点迭代(Newton-type fixed point iterations)一次性求解。这样做的好处是能够充分利用GPU的并行计算能力,理论上把复杂度从 O[T] 降到 O[(log T)²]。
这意味着序列越长,相对收益越明显——对于动辄百万步的动力学数据,这种改进几乎是质的飞跃。
DEER(Deep Equilibrium Recurrent)的不动点迭代本质上借鉴了隐式深度学习(Implicit Deep Learning)的思想:将RNN在时间维度上的展开看作一个隐式方程 h = F(h, x),其中 h 是整个序列的隐状态向量,x 是输入。牛顿型迭代通过构造雅可比矩阵(Jacobian)的近似逆来逐步修正解,而非逐时间步递推。这使得在一次迭代中,序列所有位置的隐状态可以同时更新,完美适配GPU的大规模并行计算。O[(log T)²] 的理论复杂度来源于:牛顿迭代的二次收敛性使迭代次数约为 O(log T),而每次迭代内部还涉及一层嵌套并行操作,因此出现了对数的平方项。这一复杂度优势在序列长度从千步增长到百万步时会被急剧放大。
混沌动力学让 DEER 失效
问题在于,DEER 在混沌系统面前会崩溃。混沌动力学的本质是对初始条件极度敏感,微小的误差会被指数级放大,导致DEER的不动点迭代难以收敛,运行时间退化到 O[T log T],并行优势大打折扣。这也是为什么单纯的并行方法无法直接应用于混沌系统重建(DSR)任务。
GTF:稳定训练的关键一环
研究团队引入了广义教师强制(Generalized Teacher Forcing, GTF)来稳定 DEER。GTF 本身是此前针对动力学系统重建提出的训练技术,它的作用有两层:
一方面,它能够防止混沌动力学带来的发散,让 DEER 的迭代过程重新变得可控、可收敛;另一方面,相比传统教师强制(teacher forcing),GTF 能够减少暴露偏差(exposure bias)——也就是训练时依赖真实数据、而推理时依赖自身预测所造成的分布错配问题。这个问题在状态空间模型(state space models)的训练中尤为常见。
把 DEER 的并行能力和 GTF 的稳定能力结合起来,才真正实现了既快又稳的「时间并行」训练,让模型能够在极长的混沌时间序列上高效收敛。
传统教师强制(Teacher Forcing)在训练时将真实观测值直接作为每一步的输入,虽然加速了收敛,但也引入了暴露偏差:模型在训练时从未见过自身预测出错后需要自我修正的场景,导致推理阶段误差累积迅速发散。广义教师强制(GTF)通过一个可调的混合系数,将真实观测与模型自身预测按比例混合后输入下一步,在训练早期偏向真实数据以稳定梯度,随训练推进逐渐增大模型自预测的比重,从而在两个极端之间平滑过渡。在混沌系统场景下,GTF 额外发挥了吸引子正则化的作用——通过周期性地将隐状态"拉回"到真实轨迹附近,抑制了混沌敏感性导致的指数级误差放大,这正是让 DEER 的不动点迭代重新收敛的根本机制。
对比 Mamba 等状态空间模型
近年来,以 Mamba 为代表的状态空间模型(SSM)凭借高效的长序列处理能力成为研究热点。但在动力学系统重建这一特定设定下,论文声称其方法大幅超越了 Mamba 及其他状态空间模型。
这一结论值得关注。它暗示了在追求长序列建模能力时,并非所有架构都能很好地处理混沌系统这类高度非线性、强敏感的动态过程。专门针对动力学重建设计的训练策略,可能在物理建模、气候模拟、神经科学等需要还原真实动态系统的场景中更有价值。
Mamba 的核心创新在于选择性状态空间机制(Selective SSM):通过让状态转移矩阵和选择门依赖于输入内容动态变化,摆脱了传统线性时不变 SSM 的限制,同时利用硬件感知的并行扫描算法(parallel scan)在序列维度上实现高效计算。这使 Mamba 在语言、音频等长序列任务上表现突出。然而,SSM 的状态转移本质上仍是线性递推结构,其表达能力在高度非线性的混沌吸引子重建上存在天然瓶颈——混沌系统的轨迹分岔、奇异吸引子等特征需要强非线性动力学才能被准确捕捉。这解释了为何专为非线性 RNN 设计的并行训练方案,在动力学重建这一垂直场景中能够超越通用线性 SSM 架构。
这项研究的意义
动力学系统重建的目标,是从观测到的时间序列中还原出背后的动态规律。这类任务在气象预报、流体力学、生物神经活动分析等领域都有实际需求,而这些系统往往既混沌又需要处理海量长序列数据。
过去,训练效率是制约RNN应用于这类问题的主要障碍。超过100倍的加速意味着,原本需要数天的训练可能缩短到几小时,研究者能够在更长、更真实的数据上迭代实验。无论数据来自模拟系统还是真实世界系统,这种效率提升都为更大规模的动力学建模打开了空间。
当然,作为一篇预印本(arXiv:2605.12683)成果,其性能表现仍有待更广泛的复现与验证。但从方法论角度,它给出了一个清晰的启示:面对特定问题时,组合针对性技术往往比单纯堆叠通用架构更有效。
相关推荐
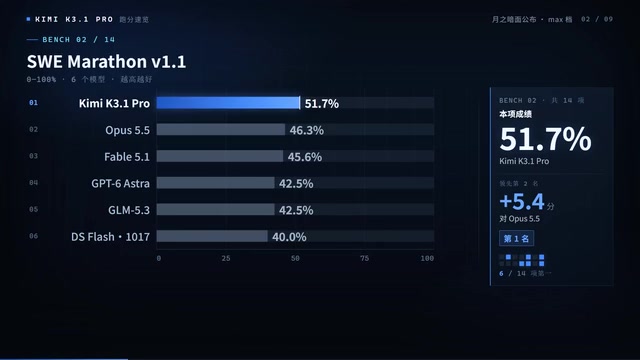
Kimi K3.1 Pro跑分曝光:14项测试6项第一,编程直追Opus
Kimi K3.1 Pro跑分公布:14项测试6项第一,场任务编程51.7超Opus,终端实战65.7仅差0.7分,幻觉率从23.4%降至8.3%,高速版支持百万上下文并计划开放权重。

谷歌Agent Compute Engine:每个Agent一个microVM
谷歌Agent Compute Engine为每个AI Agent分配独立microVM且不存凭证,本文解析其隔离设计与凭证管理思路,梳理已公开与未公开细节,并给出构建者可立即借鉴的三条实践。

付费AI写作研究谁最强?Reddit用户激辩ChatGPT与Gemini
Reddit用户热议付费AI聊天机器人写作研究能力:资深写作者发现免费Gemini输出胜过付费ChatGPT,社区讨论聚焦写作质量、研究场景偏好及提示词工作流,揭示免费与付费边界模糊下的工具选择策略。