RTX 3060 12G实测Qwen3 27B:64K上下文稳跑22 t/s

RTX 3060 12G配合Q4量化与llama.cpp,可在本地以22 token/s速度运行Qwen3 27B大模型。
本文记录了一项实测:一张千元级RTX 3060 12G显卡,借助Q4量化(精度损失约2%)和llama.cpp推理框架,在64K上下文下能以约22 token/s的速度稳定运行Qwen3 27B模型,32K上下文时可达26~28 token/s,批量吞吐更超过400 token/s。显存占用高达96%接近极限,功耗约170W,CPU几乎不参与推理。整套方案基于Ubuntu系统,提供一键部署脚本,16G内存即可运行,并通过了25K~50K长文本的稳定性验证。这一结果表明,消费级入门显卡配合激进量化正在切实降低本地大模型部署的门槛,个人开发者和小团队可以极低成本搭建私有化AI工具。
12G显存也能跑27B?
长期以来,想在本地部署参数量较大的开源大模型,往往被劝退于一个现实门槛——显存。27B 这个级别的模型,直觉上似乎需要 24G 甚至更高规格的显卡才敢碰。但 B站 UP 主的一次实测给出了不一样的答案:一张千元级的 RTX 3060 12G,配合合理的量化方案,照样能把 Qwen3 27B 跑出可用的生产级速度。
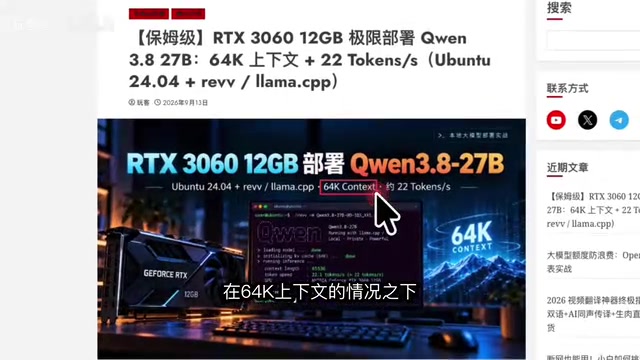
实测环境中,这张 3060 12G 在运行编程任务时速度相当流畅,已经达到了基本的生产需求。关键数据是:在 64K 上下文下可稳定跑到约 22 token/s,当上下文降低到 32K 时,持续生成速度甚至能冲到 26~28 token/s。对于一张定位入门的显卡来说,这个表现足以颠覆不少人对「平民硬件跑大模型」的刻板印象。
硬件表现:显存满载,功耗克制
从实测的硬件监控来看,这套方案把 3060 的 12G 显存压榨到了极致——显存占用达到 96%,几乎满载。这其实是本地部署的理想状态:既要把尽可能大的模型和上下文塞进显存,又不能溢出到系统内存导致速度断崖式下跌。
值得关注的是另外两项指标。CPU 占用非常低,说明推理负载几乎完全由 GPU 承担,没有出现 CPU-GPU 混合推理拖后腿的情况;功耗方面大约在 170W 左右,接近满载但并不夸张,对电源和散热的要求相对温和。换句话说,这是一套功耗与性能平衡得不错的本地推理配置。
量化方案:Q4 与 IQ3 的取舍
能在 12G 显存里塞下 27B 模型,核心靠的是量化。UP 主在视频中专门讲解了两种量化方案的精度损失:
- Q4 量化:精度损失大约在 2% 左右,几乎可以忽略,是兼顾质量与显存占用的推荐选择;
- IQ3 量化:损失约 5%,更激进地压缩显存,适合需要更长上下文或更大余量的场景。
按作者的判断,这两种损失都在合理范围之内。实际使用中,Q4 更适合对输出质量敏感的任务,IQ3 则在显存吃紧时提供额外的空间。这种「用少量精度换取可部署性」的权衡,正是消费级显卡跑大模型的关键思路。
量化(Quantization)是将模型权重从高精度浮点数(如 FP16,每个参数占 2 字节)压缩为低比特整数表示的技术。Q4 表示每个权重用 4 位整数存储,相较 FP16 体积缩小约 75%;IQ3 则进一步压缩到 3 位,但采用了非均匀量化(Importance-aware Quantization)策略——优先保留对模型输出影响更大的权重精度,从而在更激进的压缩率下尽量减少质量退化。一个 27B 参数的模型以 FP16 存储约需 54GB 显存,经 Q4 量化后可压缩至约 14-16GB 范围,IQ3 则可进一步降至 10-12GB 以内,这正是 12G 显存得以装下 27B 模型的技术前提。llama.cpp 原生支持这两种格式,并针对 NVIDIA GPU 做了 CUDA 加速优化。
不同上下文下的速度表现
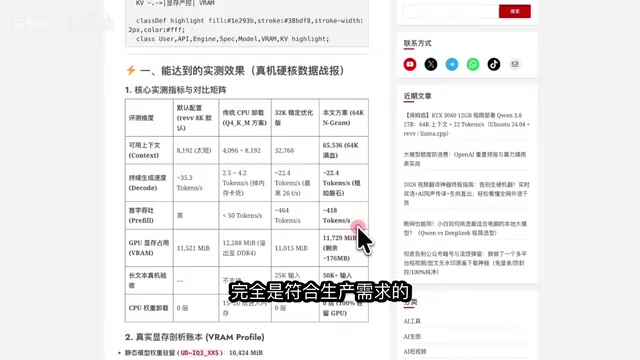
上下文长度直接影响推理速度,这一点在实测中体现得很清楚。UP 主给出了一组梯度数据:
| 上下文长度 | 生成速度(约) |
|---|---|
| 8K / 16K | 突破 30+ token/s |
| 32K | 26~28 token/s |
| 64K(默认) | 22 token/s |
此外,批量吞吐(手动并发测试)可以达到 400+ token/s,完全符合生产需求。长文本测试方面,输入 25K、乃至 50K 的内容都没有出现问题,说明这套配置在长上下文场景下的稳定性是经得起考验的。
如果你更在意极限输出速度,可以用 8K 的启动脚本;日常不跑大任务时用 32K;默认则推荐 64K 以兼顾容量与速度。
部署流程概览
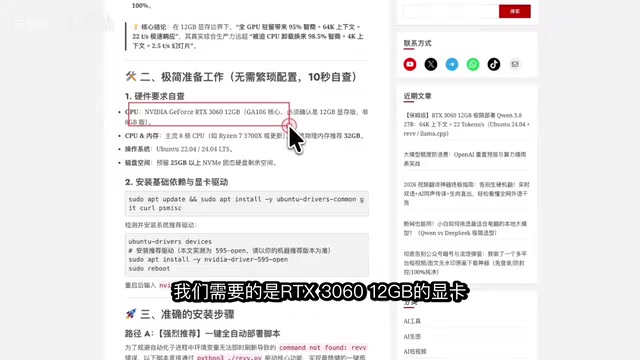
整套方案基于 Ubuntu 系统 + llama.cpp 搭建,所需硬件门槛并不高:
- 显卡:RTX 3060 12G
- 内存:32G(实测 16G 同样可用)
- 系统:Ubuntu
- 硬盘空间:占用很小
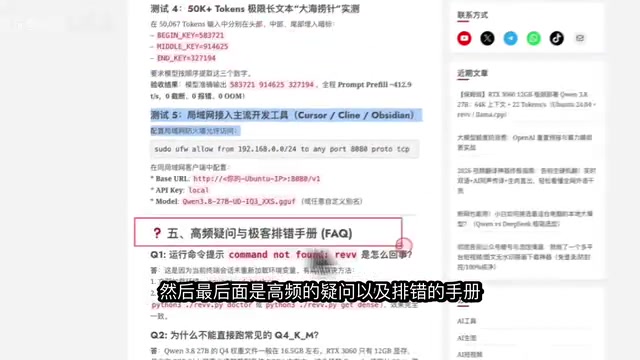
作者将部署拆成了几个阶段:安装底座(llama.cpp)、下载专属量化模型、配置启动脚本,最后设置一个守护服务保证模型常驻运行。整个过程既提供了一键全自动脚本,也附带了分步执行方法——甚至可以把脚本直接交给 Agent 去执行,省去手动操作。
最终的验收环节包括基准测试、上下文测试、长文本测试以及局域网访问测试,并配有高频疑问与排错手册。对新手来说,这种「脚本 + 排错文档」的组合降低了踩坑成本。
llama.cpp 是由 Georgi Gerganov 开发的轻量级推理框架,以纯 C/C++ 实现,核心优势在于极低的运行时依赖和对量化格式(GGUF)的原生支持。它提供了一个兼容 OpenAI API 格式的本地服务器模式(llama-server),可直接对接 Open WebUI、Continue.dev 等前端工具,也能通过 HTTP 接口供自定义程序调用,这使得「模型常驻 + 局域网访问」的方案非常容易实现。守护服务通常通过 systemd 配置,确保开机自启且崩溃后自动重启,是生产级本地部署的标准做法。
这套方案值不值得折腾?
抛开具体数字,这次实测真正的价值在于验证了一个方向:消费级入门显卡 + 激进量化 + llama.cpp,正在不断拉低本地部署大模型的门槛。千元级的 3060 能跑出 22 t/s 的 27B 模型,意味着个人开发者、小团队完全可以用极低成本搭建私有化的编程助手或知识处理工具。
当然,前提是要接受量化带来的轻微精度损失,并对上下文长度与速度之间的取舍有清晰认知。对于预算有限又想体验较大参数模型的用户来说,这无疑是一条高性价比的路径。
注:本文基于单一 B站视频素材整理,具体速度数据会因模型版本、量化文件和驱动环境不同而有所差异,建议以实际部署测试为准。
相关推荐

房产经纪人用AI提效的5个实操方法(2026版)
房产经纪人如何用AI提效?结合YouTube实操演示,拆解ChatGPT写房源描述、Canva做营销物料、表单管理开放日线索、Zapier自动跟进、卖家面谈准备5个方法,并提示公平住房法规、照片真实性与定价核实等风险边界。

Grok Bot vs ChatGPT Agent:两大AI代理谁更强?
Grok Bot 与 ChatGPT Agent 有何区别?本文对比两者的工作方式:Grok Bot 拥有云端计算机、可常驻工具内自动执行多步任务;ChatGPT Agent 在浏览器中操作网页,通用任务更成熟。附选型建议。
Walmart Agent Gateway:AI帮你自动购物,亚马逊为何反其道而行?
沃尔玛推出Agent Gateway,允许ChatGPT、Gemini等AI助手直接接入商品库替用户搜索比价加购,并设消费限额与逐笔审批三道安全阀。亚马逊则封堵外部AI代理,两大零售巨头走向相反路线。功能目前仅限美国,印度市场或随后跟进。