#大模型量化
共 7 篇相关文章

·8 分钟
12GB显卡跑1250亿参数大模型?Stratavie装机实测全流程
B站UP主实测:用一张12GB显卡配64GB内存,通过开源推理引擎Stratavie跑起1250亿参数的Qwen3.8 Flash Next模型,RTX 5070实现每秒94 token。本文详解稀疏激活、GSQ-RCO量化、四层仓库原理、一键装机与跑分数据。
阅读全文 →

·5 分钟
RTX 3060 12G实测Qwen3 27B:64K上下文稳跑22 t/s
RTX 3060 12G 显卡实测部署 Qwen3 27B 大模型:基于 Ubuntu 与 llama.cpp,64K 上下文稳跑 22 token/s,32K 可达 28 token/s。详解 Q4/IQ3 量化精度损失、硬件功耗与部署流程,低成本本地大模型方案参考。
阅读全文 →

·5 分钟
免费本地部署的开源大模型实测:消费级显卡也能跑
一个开源仓库一周斩获5000+ Star,可帮助用户在本地免费部署125B参数大模型,12G显卡即可运行,支持100万Token上下文、代码生成和图片识别。本文实测其部署体验与能力边界。
阅读全文 →
·5 分钟
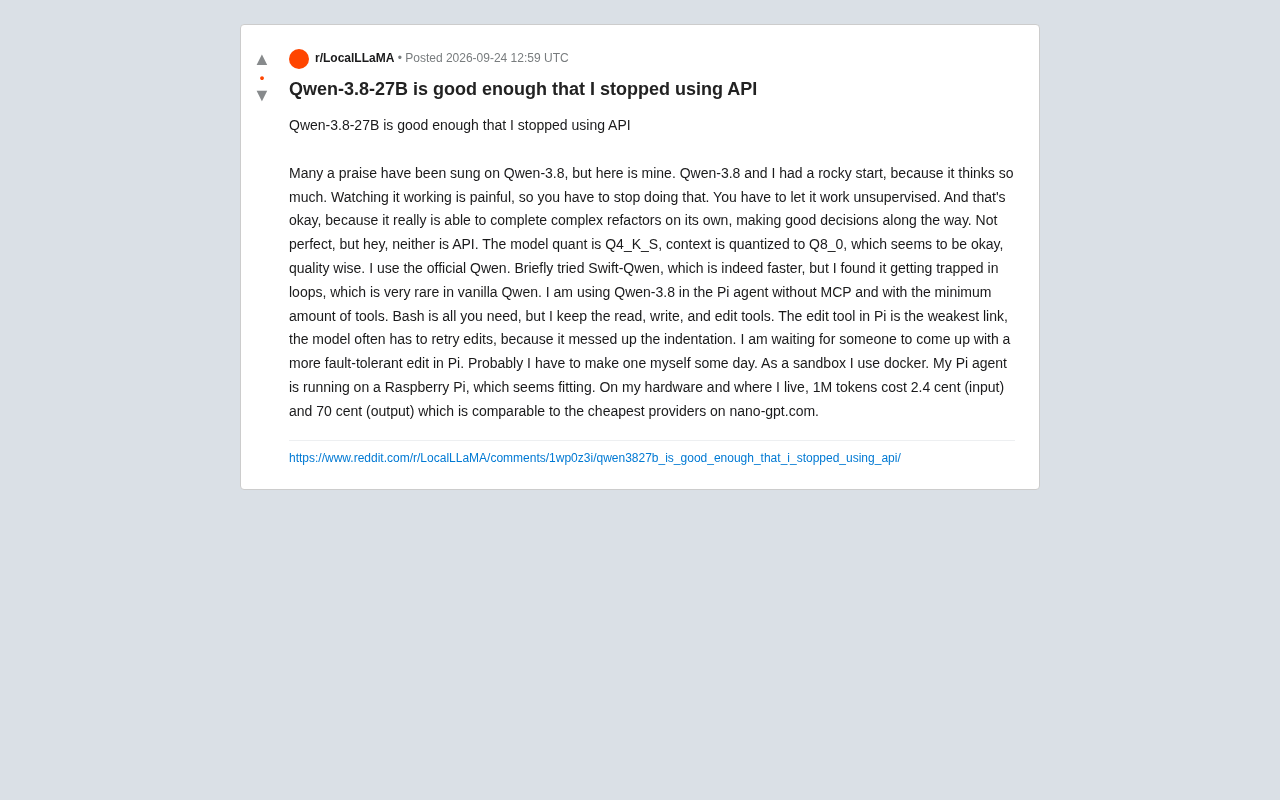
本地跑 Qwen-3.8-27B 替代 API:一位开发者的实战体验
一位 Reddit 开发者分享用本地 Qwen-3.8-27B 完全替代云端 API 的实战经验,涵盖 Q4_K_S 量化、Pi agent 极简工具链、树莓派部署与详细成本核算,探讨开源大模型「够用」的临界点。
阅读全文 →
·5 分钟
177B大模型跑在廉价显卡上?Qwen3 Flash Next本地部署实测
B站UP主实测用两块廉价显卡加32GB内存本地运行177B参数的Qwen3 Flash Next模型,通过将51B Ngram表卸载到SSD,实现22 tokens/s推理速度。本文解析其架构拆分、llama.cpp部署参数与性能表现。
阅读全文 →
·8 分钟
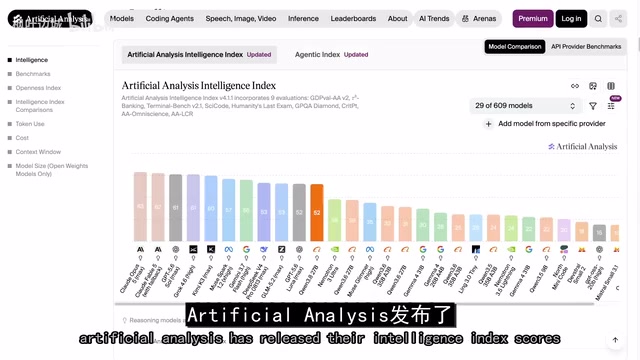
Qwen3.8 27B 本地实测:性能碾压旗舰,配置才是关键
海外博主深度实测 Qwen3.8 27B 本地部署:Artificial Analysis 跑分达 52 分紧追 GLM 5.2。文章详解 FP8、NVFP4 量化版本选择、推理档位设置及 vLLM 与 SGLang 引擎速度对比,SGLang 可达约 200 tokens/秒。
阅读全文 →