如何评估AI Agent:从工具调用到任务完成的全链路测评
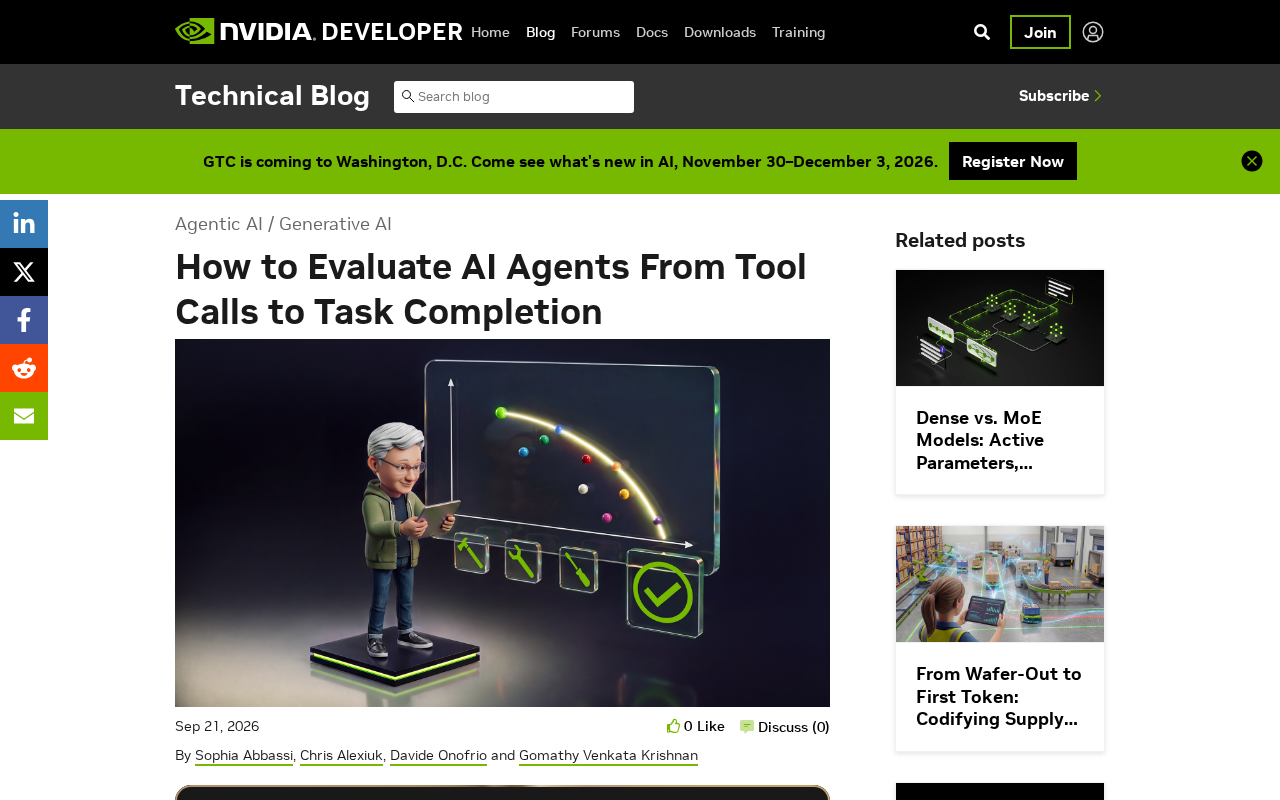
AI Agent评估必须从单点准确率升级为工具调用与端到端任务完成的分层体系。
传统大模型评测聚焦单轮问答准确率,而AI Agent需要在动态环境中连续执行数十次工具调用才能完成一项任务,单点表现好并不等于整条任务链能跑通。文章提出两层评估框架:工具调用层关注工具选择正确性、参数格式合理性及失败后的恢复能力,提供细粒度的诊断信息;任务完成层则在可复现的"活环境"中验证最终目标是否达成,并综合考量步数、耗时、token消耗等效率指标。两层结合才能形成对Agent能力的立体画像。此外,评估体系还应纳入回归测试流程,防止每次模型或提示词迭代后出现性能悄然退化的问题,使其成为团队持续交付的核心工程能力。
当你把一个AI Agent部署上线时,真正关键的问题不是它能否回答单个问题,而是它能否在真实环境中执行一条跨越数十次连续工具调用的完整工作链。这与传统模型评测的逻辑完全不同——单点准确率高,并不意味着整条任务链能跑通。
为什么Agent评估需要全新的方法论
传统的大语言模型评测往往围绕单轮问答的准确性展开:给定一个问题,模型输出一个答案,然后对照标准答案打分。但AI Agent的工作模式是自主决策、连续行动。它需要在一个动态变化的环境中,理解目标、规划步骤、调用外部工具、根据返回结果调整策略,直到完成整个任务。
在这种模式下,任何一个环节的偏差都可能在后续步骤中被放大。一个Agent可能在第一步选对了工具,却在第五步因为参数格式错误而导致整条任务链崩溃。因此,评估的重心必须从"回答是否正确"转向"任务是否真正完成"。
工具调用层:评估的第一道关卡
Agent与外部世界交互的核心方式是工具调用(Tool Calls)。在这一层,评估需要关注几个维度:Agent是否选择了正确的工具、是否传入了格式正确且语义合理的参数、以及能否正确解析工具返回的结果。
工具调用的评估往往是最容易量化的部分。可以统计工具选择的准确率、参数填充的正确率,以及调用失败后的恢复能力。一个成熟的Agent在遇到调用失败时,应当能够识别错误、调整策略并重试,而不是直接放弃或陷入无意义的循环。
值得关注的是,工具调用的正确并不等于任务的成功。Agent可能每一步的调用都合法,但整体的规划方向是错的。这就引出了更高层次的评估需求。
工具调用(Tool Calls)在技术实现上通常依赖大模型的 Function Calling 能力:模型在生成响应时,不直接输出文字答案,而是输出一段结构化的 JSON 描述,指定要调用哪个函数以及传入什么参数,由运行时框架负责实际执行并将结果回传给模型。主流框架(如 LangChain、AutoGen、OpenAI Assistants API)都对这一机制提供了封装。正因为工具调用本质上是"模型生成 JSON → 程序执行 → 结果注入上下文"的循环,任何一环的格式偏差或语义错误都会中断整条链路,这也是为何参数填充的正确率在评估中格外关键。
任务完成层:真正衡量价值的标准
任务完成度(Task Completion)是Agent评估的终极目标。它衡量的是Agent在真实或仿真环境中,是否最终达成了用户设定的目标。这需要一个能够反映真实业务场景的"活环境"(live environment),让Agent在其中执行完整的操作序列。
在这一层的评估中,除了看最终结果是否达标,还应关注过程的效率与稳健性。同样是完成任务,一个Agent用了5步,另一个用了20步且反复试错,两者的实际可用性天差地别。步数、耗时、token消耗、失败重试次数等指标共同构成了对Agent综合表现的刻画。
此外,环境的动态性给评估带来额外挑战。真实环境的状态会随Agent的每一次操作而改变,这意味着评估不能简单地对照静态答案,而需要构建可复现、可回放的测试环境,才能保证评估结果的一致性和可信度。
构建"活环境"(live environment)是这一层评估最大的工程挑战。常见方案分为两类:一是沙箱仿真,即搭建一个与生产系统行为一致但数据隔离的镜像环境,Agent 的每次操作都有真实副作用但不影响线上数据;二是状态快照与回放,在每个测试用例开始前将环境重置到预设的初始状态,确保不同运行之间的可比性。后者尤其重要——若 Agent 在第一次运行中修改了某个数据库记录,第二次运行时的起点已经不同,评估结论便失去意义。可复现性(reproducibility)因此成为评估基础设施设计的首要约束。
构建可靠评估体系的实践建议
把工具调用层和任务完成层结合起来,可以形成一套分层的评估框架。工具调用层提供细粒度的诊断信息,帮助定位问题出在哪一步;任务完成层提供端到端的成败判断,反映Agent的真实商业价值。
在工程实践中,建议构建一个覆盖典型场景的测试集,每个测试用例包含明确的初始状态、目标状态和成功判定标准。通过在受控环境中反复运行Agent,收集其在两个层次上的表现数据,就能形成对Agent能力的立体画像。
对于持续迭代的Agent系统,这套评估体系还应当纳入回归测试流程。每次模型或提示词更新后,都能快速验证是否在原有任务上出现了性能退化,避免"修好一个场景、弄坏三个场景"的困境。
回归测试在 Agent 系统中的重要性远超传统软件。Agent 的行为由模型权重、提示词(Prompt)、工具定义和调用逻辑共同决定,任何一项的微小变动都可能导致跨步骤的连锁影响,且这种影响往往不在改动最直接的场景中显现,而是在边缘用例中悄然劣化。业界常见的做法是为每个已知的高价值场景维护一份"黄金测试集"(golden test suite),在每次变更合并前自动运行,并以任务完成率和工具调用准确率的对比差值作为发布门禁指标,一旦关键指标下降超过阈值则阻断部署流程。
小结
AI Agent的评估是一个从微观到宏观的连续过程:工具调用层保证每一步动作的正确性,任务完成层验证整体目标的达成。只有把这两个层次结合起来,才能真正回答"这个Agent能不能上线"这个核心问题。随着Agent在生产环境中承担越来越复杂的任务,建立科学、可复现的评估体系正在成为团队的核心竞争力之一。
相关推荐
TensorRT多设备推理:简化Dynamo-Triton的多GPU模型部署
NVIDIA在Dynamo-Triton中引入TensorRT多设备推理能力,简化跨多GPU的大模型部署,解决单卡显存与算力不足问题,为生成式AI生产环境提供更高效的推理服务方案。
Grok 4.7 登陆 Devin:后端硬核任务表现突出
Grok 4.7 现已在 Devin Desktop 和 CLI 上线。在 FrontierCode 1.1 基准中,它在多模块后端硬核任务上表现最强,但因倾向过度扩展任务范围,综合得分略逊于 Grok 4.6。
数据本体论:AI智能体缺失的上下文层
数据本体论(Data Ontology)是AI智能体缺失的上下文层。本文解析它如何统一业务语义、消除数据歧义,让AI从猜测业务含义转向依据明确定义执行,是企业级AI落地的关键基础设施。