如何挑选最佳LLM团队?异质性驱动的模型协同选择框架
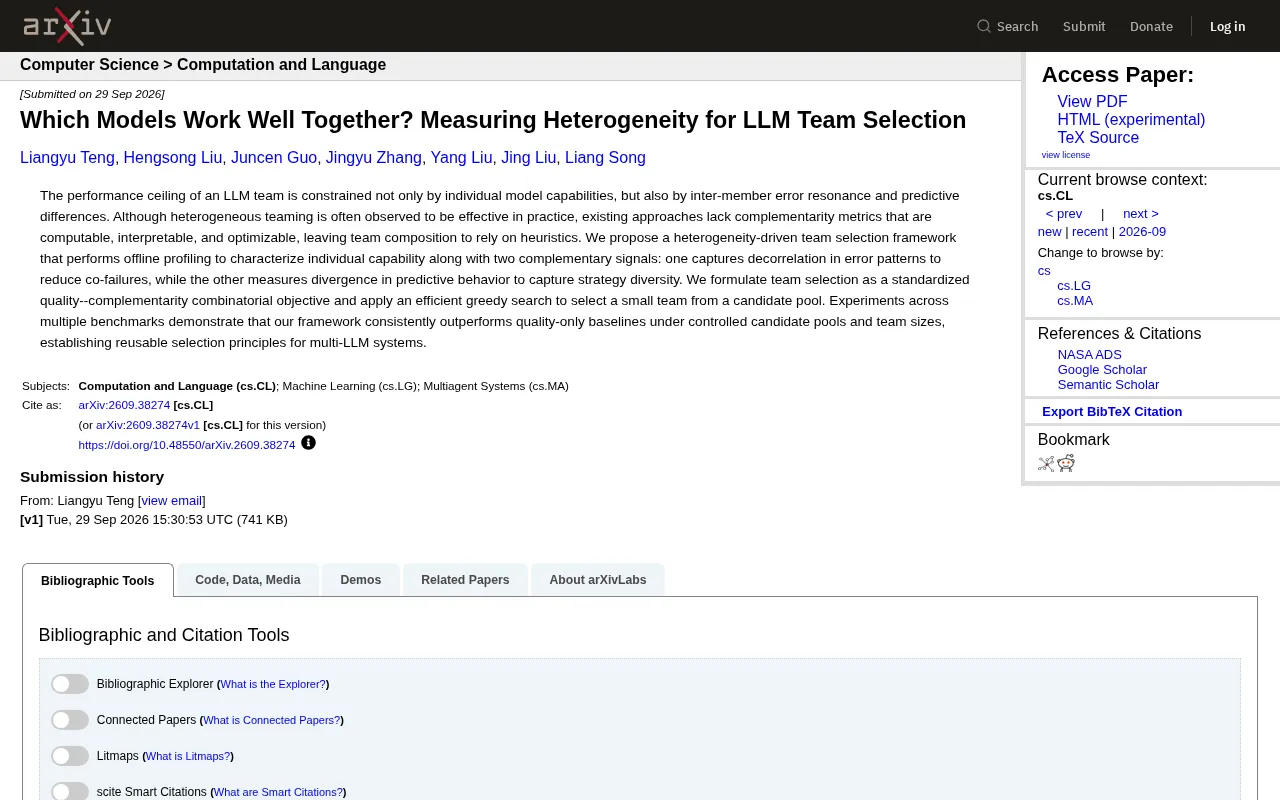
新研究提出可量化互补性框架,证明LLM团队选择应兼顾错误去相关与策略多样性,而非只堆最强单模型。
这篇arXiv论文针对多LLM系统的组队问题,提出了一套异质性驱动的团队选择框架。研究的核心洞察是:强模型的简单堆叠并不能保证团队最优,因为成员间的"错误共振"会导致集体失败。框架通过离线剖析引入两个互补信号——错误去相关性与预测行为分歧——分别捕捉错误覆盖盲区的能力和策略层面的多样性。团队选择被形式化为质量—互补性组合优化目标,并用贪心搜索高效求解。多基准实验表明,该框架持续优于仅考虑个体质量的基线方法,为多模型协同系统提供了可量化、可复用的组队原则。
为什么多模型协同不能只看单兵能力
在多LLM系统日益流行的今天,一个常见的误区是:把能力最强的几个模型堆在一起,团队就一定表现最好。但一篇发表在arXiv上的新研究指出,这种直觉往往是错的。
研究作者提出,一个LLM团队的性能上限不仅取决于单个模型的能力,还受到成员间"错误共振"(error resonance)和预测差异的制约。换句话说,如果几个强模型在相同类型的问题上犯相同的错误,它们组合起来并不能互相纠错,反而会一起失败。这就是为什么异质性(heterogeneity)组队在实践中常常更有效。
问题在于,虽然大家都观察到异质团队有效,却缺少一套可计算、可解释、可优化的互补性指标。于是团队组建长期依赖经验和启发式规则,缺乏理论支撑。
框架核心:用两个信号衡量互补性
这项研究提出了一个异质性驱动的团队选择框架(heterogeneity-driven team selection framework),其核心是通过离线剖析(offline profiling)来刻画每个模型的特性。除了评估个体能力之外,框架引入了两个关键的互补信号:
错误去相关:减少共同失败
第一个信号捕捉的是错误模式的去相关性(decorrelation in error patterns)。它的目标是衡量不同模型在哪些问题上会同时出错。如果两个模型的错误高度相关,意味着它们在面对同类难题时会"一起翻车",组队价值有限;反之,错误模式越不相关,团队越能通过彼此覆盖盲区来降低整体失败率。
错误去相关的思想来源于集成学习(Ensemble Learning)中的经典理论。在随机森林、Boosting等方法中,研究者很早就发现:弱分类器之间的错误独立性比单个分类器的准确率更能决定集成效果的上限。形式上,如果两个模型的错误呈正相关,它们的集成误差接近单模型误差;而当错误负相关或不相关时,集成可以显著降低误差。将这一原理迁移到LLM团队中,需要解决的额外挑战是:LLM的"错误"难以像分类标签那样被简单量化——同一问题的回答可能在语义上接近正确却在细节上偏差,因此错误相关性的度量方式本身就是一项关键的设计选择。这也是该框架需要通过离线剖析(offline profiling)来构建每个模型错误画像的原因。
预测行为分歧:捕捉策略多样性
第二个信号衡量的是预测行为的分歧(divergence in predictive behavior),用来刻画策略多样性。即使两个模型准确率接近,它们解决问题的方式、推理路径也可能截然不同。这种策略层面的差异是异质团队价值的另一个来源,有助于团队在更广泛的任务分布上保持鲁棒性。
把团队选择变成可优化的组合问题
有了能力评估和两个互补信号后,研究将团队选择形式化为一个标准化的"质量—互补性"组合优化目标(quality–complementarity combinatorial objective)。这意味着团队组建不再是拍脑袋的决策,而是一个有明确数学目标的优化问题。
由于从候选池中选出最优小团队属于组合爆炸问题,穷举并不现实。研究采用了高效的贪心搜索(greedy search)策略,从候选模型池中快速挑选出规模较小的团队。这种做法在计算成本和选择质量之间取得了务实的平衡,也让框架更容易落地应用。
组合优化(Combinatorial Optimization)问题的典型难点在于搜索空间随候选数量呈指数级增长。以从N个候选模型中选取K个为例,可能的组合数为C(N,K),当N=20、K=5时已超过15000种,穷举代价极高。贪心搜索(Greedy Search)是此类问题的常用近似策略:每一步从剩余候选中选择使当前目标函数增益最大的模型加入团队,直到达到目标规模。这种方法的时间复杂度从指数级降至多项式级,但代价是无法保证全局最优,可能陷入局部最优解。在多LLM团队选择场景下,贪心搜索的实用性较强,因为互补性目标函数通常具有一定的次模性(submodularity)——即边际收益递减的特性,而次模函数的贪心近似在理论上有(1-1/e)≈63%的最优性保证。
实验结果:持续优于"只看质量"的基线
研究在多个基准测试上进行了验证。结果显示,在受控的候选池和团队规模条件下,该框架持续优于仅考虑质量的基线方法(quality-only baselines)。这一结果直接印证了核心论点:单纯追求个体能力最强并非最优策略,互补性同样是决定团队上限的关键因素。
更重要的是,这项工作为多LLM系统建立了可复用的选择原则。它把过去依赖经验的组队方式,转化为一套有指标、有目标、有算法支撑的方法论。
对多模型系统的实际意义
随着智能体(agent)系统和多模型协作架构越来越普遍,如何组合不同模型已经成为工程实践中的现实问题。这项研究的价值在于提供了一个可量化的思考框架:
- 评估模型时不仅看绝对能力,还要看它与团队其他成员的错误是否互补;
- 关注模型的策略多样性,避免同质化带来的集体盲区;
- 把组队决策转化为可优化问题,减少对直觉的依赖。
对于正在搭建多LLM管线的团队而言,这些原则提供了比"堆最强模型"更精细的指导思路。当然,框架目前主要在受控的基准环境下验证,实际生产场景中候选池更大、任务更复杂,其贪心搜索的效率与泛化能力还有待进一步检验。
总体来看,这项研究把"哪些模型搭配效果好"这一直觉问题,第一次系统地转化为可测量、可优化的工程命题,为多模型协同提供了有价值的方法论基础。
相关推荐

Last Week Tonight深扒:政客与白人至上主义的危险纽带
Last Week Tonight调查佐治亚州参议员候选人Mike Collins与佛罗里达州候选人Marshall Rawson,揭露他们与白人至上主义者的多重关联,以及共和党内的沉默反应。

AI圈爆料周:GPT-6.5泄露、Claude新模型与MiniMax性价比
本周AI圈爆料汇总:GPT-6.5疑似泄露、微软配置现GPT-6.1 Tera、Anthropic新模型能识别整类Bug、Gemini 4 Carbon早期表现失望,以及MiniMax M3.1 Flash以极低成本在基准测试中超越Claude Opus 5和GPT-5.6 Sol。

AI快讯:Gemini 4 Carbon发布,蚂蚁开源Ling-3.1
AI快讯:Google发布Gemini 4 Carbon量子位模型,宣称超越Opus 5.5且首发Token半价;蚂蚁百灵开源Ling-3.1-1019推动Personal Agent真实任务;国产AI制药19个项目18个成功,6个GPCR靶点全命中;零营收公司估值200亿美元再融10亿美元;四川便利店机器人售货失败。