验证驱动开发:释放AI编程真正潜力的关键

AI编程的瓶颈不在模型能力,而在组织的自动化验证体系。
文章提出软件开发正经历从"规范驱动"到"验证驱动"的范式转移。AI编程工具的效果瓶颈不在模型能力,而在组织是否具备严格的自动化验证体系。由于验证比生成容易(验证不对称性),完善的测试和验证基础设施能让AI Agent通过大量采样和自动筛选产出高质量代码。大多数组织的测试覆盖率不足、构建不稳定,直接限制了AI Agent的能力上限,因此投资验证基础设施比纠结工具选择更具战略价值。
从规范到验证:软件开发的范式转移
Factory公司CEO Eno在最近的演讲中提出了一个值得深思的观点:AI编程工具的瓶颈不在于模型能力,而在于你的组织是否具备足够的自动化验证体系。
这个观点与Andrej Karpathy提出的"软件2.0"理念不谋而合。Karpathy于2017年提出"软件2.0"概念,核心思想是:传统软件(软件1.0)由人类编写的显式指令构成,而软件2.0则由神经网络权重构成,程序逻辑通过训练数据和优化目标隐式涌现。在大语言模型时代,这一概念进一步延伸到"后训练"(Post-training)阶段——即在预训练完成后,通过强化学习(RLHF/RLAIF)或基于可验证奖励的强化学习(RLVR)来精调模型能力。可验证任务(如数学证明、代码执行)因为有明确的正确性判断标准,可以提供高质量的奖励信号,从而成为后训练的理想场景。OpenAI的o系列模型、DeepSeek广告-R1等推理模型的突破,很大程度上正是得益于在代码和数学等可验证领域的大规模强化学习训练。当前最前沿的AI模型都通过可验证任务的后训练来构建能力,而软件开发恰恰是最具可验证性的领域之一。这也解释了为什么软件开发Agent是目前世界上最先进的AI Agent。
但现实问题在于:大多数组织并没有为AI Agent的高效运行准备好足够的验证基础设施。
验证不对称性:为什么验证比生成更重要
演讲中引用了Jason Wei关于"验证不对称性"的博客文章,这个概念与计算机科学中经典的P vs NP问题一脉相承。P vs NP是计算机科学中最著名的未解难题之一,由Stephen Cook于1971年正式提出。P类问题指可以在多项式时间内被确定性算法解决的问题;NP类问题指解可以在多项式时间内被验证的问题。如果P≠NP(学界主流观点),则意味着存在大量"验证远比求解容易"的问题——例如,验证一个数独解是否正确只需几秒,但从零求解可能需要指数级时间。Jason Wei将这一数学直觉引入AI能力评估框架:当一个任务的验证成本远低于生成成本时,AI系统就可以通过大量采样+自动筛选的方式绕过"生成难"的瓶颈,这正是"Best-of-N采样"和"验证器引导搜索"等技术的理论基础。核心结论是:很多任务验证起来远比解决起来容易。
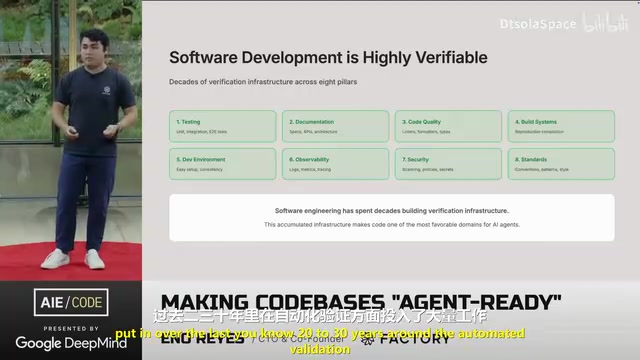
最理想的"易验证"问题具备以下特征:
- 客观真实性:存在明确的对错标准
- 快速验证:可以迅速判断结果是否正确
- 可扩展性:支持大规模并行验证
- 低噪声:验证的准确率极高
- 连续信号:不是简单的二元对错,而是30%、70%、100%的渐进式准确度
软件开发天然具备这些特性。过去二三十年间,行业已经在自动化验证方面积累了大量基础设施:单元测试、端到端测试、QA测试、Linter、API规范检查等。但关键问题是——你的验证体系是否严格到足以让AI Agent写出与高级工程师同等质量的代码?
大多数代码库的验证缺口
现实情况并不乐观。Eno指出了大多数工程团队面临的典型问题:
- 测试覆盖率停留在50%-60%,因为"人类可以手动测试"
- 构建系统存在不稳定性,每三次构建就失败一次,"所有人都默默忍受"
- Linter规则不够严格,无法有效约束AI生成代码的质量
- 缺乏能区分"AI垃圾代码"和"高质量AI代码"的测试用例
对于人类工程师来说,这些问题尚可容忍。但当你引入AI Agent时,这些缺口会直接拉低Agent的能力上限。大多数人只见过在验证体系较完善的代码库中运行的AI Agent——那些真正在AI编程上取得突破的顶尖公司,恰恰是引入了极其严格验证标准的组织。
开发流程的根本性转变
传统开发流程是:理解问题 → 设计方案 → 编码 → 测试。
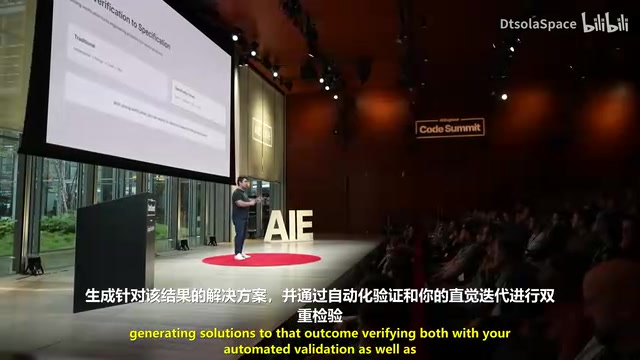
在验证驱动的新范式下,流程变为:
- 规约(Specification):定义约束条件和验证标准
- 生成(Generation):AI Agent生成候选解决方案
- 验证(Verification):自动化验证 + 人类直觉判断
- 迭代(Iteration):在验证反馈中持续优化
这种"规约驱动开发"已经渗透到各种工具中——各类IDE和编程Agent都开始支持"Spec Mode"或"Plan Mode"。当规约驱动与严格验证结合时,才能真正构建出可靠的高质量解决方案。
一个值得思考的战略选择
这引出了一个重要的决策:你是花45天对比所有编程工具、纠结于SWE-bench上10%的准确率差异,还是投资改善组织的验证基础设施,让所有AI工具都能更好地发挥作用?
值得一提的是,SWE-bench(Software Engineering Benchmark)本身就是"验证驱动
相关推荐
 观点碰撞
Scaling Law再思考:参数不是唯一答案
深度解析Scaling Law从Kaplan到Chinchilla再到MoE时代的演进历程,探讨为什么盲目堆参数是误区,以及GLM-5.3如何通过后训练证明扩展存在多个旋钮。
 观点碰撞
当AI把人类当作子代理:人机协作中的角色反转与隐忧
探讨AI Agent架构中人类从主导者变为"子代理"的范式转变。分析LangChain、AutoGen等框架中人类节点的设计逻辑,以及控制权让渡、能力退化等深层隐忧,思考人机协作的未来边界。
 观点碰撞
户外编程:Touch Grass与Build Things可以兼得
当AI编程助手让开发者摆脱办公桌束缚,户外编程成为新趋势。探讨如何借助云端IDE、语音编程等工具,在自然环境中保持创造力与生产力的平衡。