Rustuna发布:Rust重写Optuna,性能与安全双提升

Rustuna:超参数优化框架的Rust化革新
Optuna团队近日正式发布了Rustuna,这是著名超参数优化框架Optuna的Rust实现版本。该项目旨在通过Rust语言的性能优势和内存安全特性,为机器学习研究人员和工程师提供更高效、更安全的超参数调优工具。
Optuna框架背景
Optuna是由日本Preferred Networks公司于2018年开源的超参数优化框架,迅速成为机器学习领域最流行的AutoML工具之一。
Preferred Networks公司背景:Preferred Networks是日本领先的AI创业公司,成立于2014年,专注于深度学习在工业和生物医疗领域的应用。公司开发了多个知名开源项目,包括深度学习框架Chainer(PyTorch的重要灵感来源)、Optuna超参数优化框架、以及分布式深度学习库ChainerMN。PFN与丰田、发那科等制造业巨头有深度合作,将AI技术应用于自动驾驶和工业机器人。该公司在2018年获得了超1亿美元融资,估值超10亿美元,是日本AI独角兽企业。
超参数优化(Hyperparameter Optimization)是指自动搜索机器学习模型最佳配置参数的过程,如学习率、批次大小、网络层数等。与模型训练过程中学习的参数不同,超参数需要在训练前设定,其选择直接影响模型性能。超参数与模型参数的区别是机器学习中的基础概念:模型参数(如神经网络的权重和偏置)通过反向传播等算法在训练过程中自动学习,而超参数则控制学习过程本身。超参数空间通常具有复杂的交互效应——例如,较大的学习率可能需要搭配较小的批次大小才能稳定收敛。传统的网格搜索(Grid Search)和随机搜索(Random Search)方法在高维超参数空间中效率极低,Bergstra和Bengio在2012年的研究表明,随机搜索在大多数情况下优于网格搜索,因为超参数的重要性通常不均匀。这一发现推动了基于序贯模型的优化方法(如TPE)的发展。
AutoML技术栈:AutoML(自动机器学习)旨在自动化机器学习流程,包括特征工程、模型选择、超参数优化等环节。超参数优化是AutoML的核心模块之一。除Optuna外,该领域还有Google的Vizier、微软的NNI、Ray Tune等竞品。这些工具通常提供Web界面进行实验追踪、支持分布式并行搜索、集成主流ML框架。AutoML的普及降低了机器学习的使用门槛,让非专家也能构建高质量模型。
Optuna的核心创新在于采用了"Define-by-Run"API设计,允许用户在代码中动态定义搜索空间,而非预先声明所有参数。这一设计理念与Define-and-Run形成鲜明对比:Define-and-Run要求用户预先声明完整的搜索空间,这在面对条件参数时非常笨拙——例如,只有当网络类型选择CNN时才需要指定卷积核大小。Optuna的Define-by-Run方式允许在目标函数执行过程中动态请求参数值,搜索空间随代码执行路径自然展开。这一设计灵感部分来自Chainer(同为PFN开发)的Define-by-Run计算图理念,后来PyTorch也采用了类似的动态图设计。这种API风格大幅简化了复杂搜索空间的定义,特别适合神经架构搜索(NAS)等需要条件参数的场景。
Optuna实现了多种先进的优化算法,包括TPE(Tree-structured Parzen Estimator)、CMA-ES和Grid Search等,并通过剪枝(Pruning)机制提前终止无希望的试验,大幅提升搜索效率。截至2024年,Optuna在GitHub上已获得超过10,000颗星,被广泛应用于学术研究和工业生产环境。
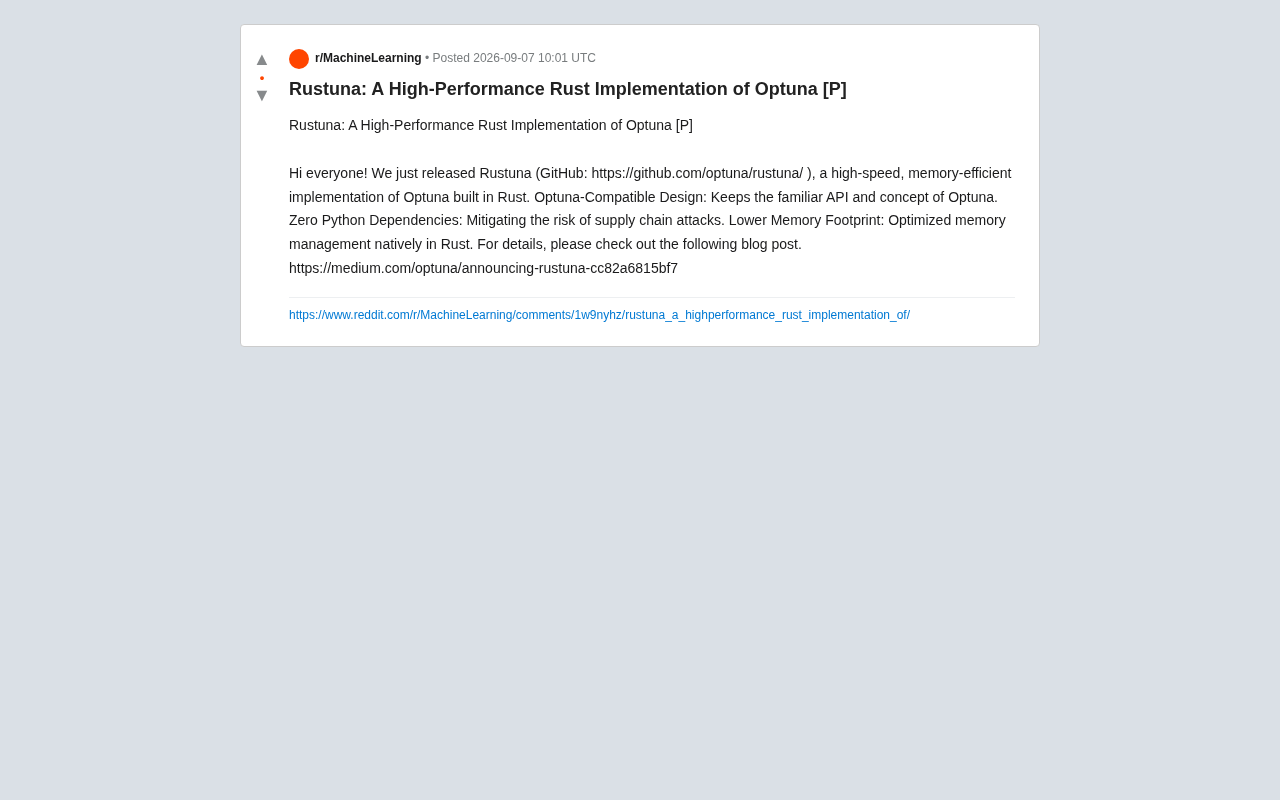
作为开源社区的重要动态,Rustuna的发布标志着机器学习工具链向更底层、更高性能方向演进的趋势。这一举措不仅是技术栈的迁移,更是对现代软件工程实践中性能、安全性和可维护性三者平衡的一次深入探索。
核心特性:兼容性与性能的双重保障
API设计的向后兼容
Rustuna最显著的特点是保持了与原版Optuna完全兼容的API设计。熟悉Optuna的用户可以无缝迁移到Rustuna,无需重新学习新的概念和接口。这种设计哲学体现了开发团队对用户体验的重视——技术升级不应成为使用门槛。
对于已经在生产环境中使用Optuna的团队来说,兼容性设计极大降低了迁移成本。现有的超参数搜索脚本和优化流程可以直接复用,只需更换底层实现即可享受Rust带来的性能提升。
零Python依赖的安全策略
Rustuna采用零Python依赖的架构设计,这一决策直接针对供应链安全问题。近年来Python生态系统频繁出现依赖包被恶意注入的安全事件,从typosquatting攻击到依赖混淆漏洞,这些风险对企业级应用构成了实质性威胁。
供应链安全威胁详解
软件供应链攻击是指攻击者通过渗透依赖包来影响下游用户的攻击方式,近年来呈上升趋势。Python生态系统由于其开放性和流行度成为重点攻击目标。
Typosquatting(拼写劫持)是最常见的攻击手法,攻击者注册与热门包名相似的恶意包(如将'requests'写成'request'),利用开发者的拼写错误进行传播。2022年发生的ctx包事件中,攻击者劫持了一个拥有数百万下载量的包,窃取AWS密钥等敏感信息。
依赖混淆(Dependency Confusion)攻击利用包管理器的解析机制漏洞,当企业同时使用私有源和公共源时,攻击者可在公共源发布同名但版本更高的恶意包,导致构建系统错误下载。2021年安全研究员Alex Birsan通过此手法成功入侵了Apple、Microsoft等35家科技巨头的内部系统。
Python的PyPI平台虽然持续加强安全措施,但由于生态系统的复杂性(一个项目可能间接依赖数百个包)和自动化程度较低的审核机制,防御难度较大。使用像Rust这样依赖树更简洁、编译时检查更严格的语言,可以从根本上减少攻击面。
通过完全使用Rust构建,Rustuna将依赖树大幅简化,减少了潜在的攻击面。Rust的包管理器Cargo和crates.io生态虽然也存在安全挑战,但其静态类型系统和内存安全保证从语言层面提供了额外的防护层。
内存效率的原生优化
Rust语言特性解析
Rust是Mozilla于2010年启动开发的系统编程语言,2015年发布1.0版本。其核心设计目标是在提供C/C++级别性能的同时,通过创新的所有权系统(Ownership System)在编译时保证内存安全和线程安全。
Rust语言的内存安全机制:Rust通过所有权系统在编译时保证内存安全,无需垃圾回收器。所有权规则包括:每个值有唯一所有者,所有者离开作用域时值被自动释放,借用检查器确保引用始终有效。这避免了C/C++中的悬垂指针、双重释放等内存错误,同时避免了Java/Python等语言的GC停顿。配合生命周期标注,Rust能在编译时捕获数据竞争,实现无锁并发。
所有权系统的核心包括三个规则:每个值有唯一的所有者,所有者离开作用域时值被释放,通过借用(Borrowing)机制实现安全的引用传递。这使得Rust能够在不依赖垃圾回收的情况下避免常见的内存错误,如空指针解引用、数据竞争和内存泄漏。
零成本抽象原理:零成本抽象(Zero-Cost Abstractions)是Rust的核心设计理念,源自C++之父Bjarne Stroustrup的名言:'你不用的东西不应付出代价,你使用的东西无法手工做得更好'。在Rust中,迭代器、闭包、trait对象等高层抽象在编译时会被优化为等效的底层机器码,无运行时开销。例如,使用迭代器链式操作的代码编译后性能与手写循环完全相同。这让开发者能用表达力强的代码写出系统级性能的程序。
Rust的零成本抽象(Zero-Cost Abstractions)理念意味着高层次的抽象不会带来运行时开销——编译器会将其优化为等效的底层代码。配合强大的类型系统和模式匹配,Rust在保持接近C语言性能的同时提供了现代编程语言的表达力。近年来,Rust在系统软件、WebAssembly、嵌入式开发和云基础设施等领域获得快速增长,连续多年在Stack Overflow开发者调查中被评为"最受喜爱的编程语言"。
Rust的所有权系统和零成本抽象使得Rustuna在内存管理上具有天然优势。相比Python的垃圾回收机制,Rust在编译时就确定了内存的分配和释放时机,避免了运行时的性能开销和不可预测的内存峰值。
Python性能瓶颈的技术根源:Python的性能瓶颈源于多个层面。首先,CPython解释器逐行解释字节码,缺乏JIT编译优化(虽然PyPy提供了JIT,但生态兼容性有限)。其次,Python的动态类型系统要求运行时进行大量类型检查和装箱/拆箱操作,每次整数运算都涉及Python对象的创建和引用计数更新。全局解释器锁(GIL)更是限制了多线程并行的可能性——即使在多核处理器上,同一时刻也只有一个线程能执行Python字节码。此外,Python的垃圾回收器使用引用计数配合循环检测的混合策略,GC暂停虽然通常较短但不可预测,在延迟敏感的场景中可能造成问题。这些因素叠加导致Python在计算密集型任务中比Rust慢10-100倍,而在超参数优化中,采样算法和历史数据管理正是这类计算密集型操作。
这对需要进行大规模超参数搜索的场景尤为关键。当同时运行数百个试验时,更低的内存占用意味着可以在相同硬件条件下并行更多的优化任务,直接转化为实验迭代速度的提升。
技术实现与性能预期
超参数优化算法原理
超参数优化的核心挑战是在高维、非凸、计算昂贵的黑盒函数中寻找最优解。常用算法包括:
贝叶斯优化与TPE算法:贝叶斯优化是一种用于优化昂贵黑盒函数的策略,通过构建目标函数的概率代理模型来指导搜索。TPE(Tree-structured Parzen Estimator)将传统贝叶斯优化中的高斯过程替换为两个密度估计器:l(x)建模表现优于阈值的参数分布,g(x)建模劣于阈值的分布。通过最大化l(x)/g(x)选择下一个采样点,这种方法计算效率更高,能有效处理条件参数和高维空间。
TPE(Tree-structured Parzen Estimator)是基于贝叶斯优化的方法,通过构建两个概率模型分别表示"好结果"和"坏结果"对应的参数分布,然后最大化两者比率来选择下一个试验点。相比传统高斯过程,TPE能更好处理高维和条件参数空间。
CMA-ES(Covariance Matrix Adaptation Evolution Strategy)是进化策略家族的代表,通过维护一个多元正态分布来表示搜索分布,每次迭代根据优秀个体调整均值和协方差矩阵。该算法由Nikolaus Hansen于2001年提出,是连续域黑盒优化的黄金标准之一。其核心思想是维护一个多元正态分布N(m, σ²C),其中m为均值向量,σ为步长,C为协方差矩阵。每次迭代采样λ个候选解,根据适应度排序后更新分布参数。协方差矩阵的适应使算法能学习目标函数的局部几何结构,自动调整搜索方向和尺度。CMA-ES具有旋转不变性和尺度不变性,对ill-conditioned问题表现优异,且几乎无需调整自身超参数。在超参数优化中,CMA-ES特别适合连续参数的精细调优阶段,但在离散参数和高维(>100维)场景中效果有限。
剪枝机制的工作原理:剪枝(Pruning)是提前终止劣质试验的策略,核心思想是利用训练过程中的中间指标预测最终表现。Median Pruning算法在每个检查点(如每个epoch结束)计算历史试验在该点的指标中位数,若当前试验显著低于中位数则终止。Successive Halving是另一种策略,周期性淘汰表现最差的一半试验。这些方法在深度学习中尤为重要:一个ResNet训练可能耗时数小时,若前几个epoch就显示出劣势,提前停止能节省70-90%的计算资源。
剪枝机制是Optuna的重要创新。Median Pruning算法通过比较当前试验的中间结果与历史试验在相同步数的中位数表现,提前终止显著劣于平均水平的试验。这在深度学习场景中尤为重要,因为训练一个epoch可能耗时数小时,早停能节省大量计算资源。
多目标优化(Multi-objective Optimization)用于同时优化多个冲突指标(如准确率和推理延迟),返回帕累托最优解集合。Optuna实现了NSGA-II等经典多目标进化算法,让用户能在精度和效率间做权衡。
从项目的GitHub仓库可以看出,Rustuna并非简单的语言移植,而是针对Rust生态进行了深度优化。Rust的并发模型和异步运行时为超参数搜索这种天然并行的任务提供了理想的执行环境。
Rust并发模型对超参数优化的适配:Rust的并发模型基于"无畏并发"(Fearless Concurrency)理念,通过所有权系统和Send/Sync trait在编译时保证线程安全。在超参数优化场景中,多个试验通常可以并行执行,但需要共享优化历史来指导后续采样。Python受限于全局解释器锁(GIL),真正的多线程并行需要依赖多进程方案,带来额外的进程间通信开销和内存复制成本。Rust的async/await异步运行时(如Tokio)能高效管理大量并发I/O操作,而其无锁数据结构和原子操作原语则支持高效的共享状态管理。这使得Rustuna在分布式优化场景中具备架构层面的优势,能更自然地实现试验调度、结果收集和模型更新的并发流水线。
官方博客文章中提到的性能提升主要体现在两个维度:一是单次试验的执行速度,Rust编译后的机器码执行效率显著高于Python解释器;二是内存占用的降低,这在长时间运行的优化任务中尤为关键。
虽然具体的基准测试数据尚未全面公开,但根据类似项目的经验,Rust实现通常能带来2到10倍的性能提升,具体数值取决于工作负载特征和原Python代码的优化程度。
对机器学习工具生态的启示
Rustuna的发布是机器学习工具链Rust化浪潮中的一个重要节点。从数据处理框架Polars,到模型推理引擎Candle,再到超参数优化工具Rustuna,越来越多的ML基础设施选择用Rust重构核心组件。
Rust ML生态系统发展
Rust在机器学习领域的应用从2020年开始显著加速,形成了日益完善的工具链生态。
Apache Arrow内存格式:Apache Arrow是一种列式内存格式规范,为数据分析提供零拷贝数据共享。与传统行式存储不同,Arrow按列组织数据,配合向量化计算和SIMD指令,大幅提升分析查询性能。它定义了跨语言的内存布局标准,使Python、R、Java等环境能直接共享内存中的数据无需序列化。Polars、Pandas 2.0、DuckDB等现代数据工具都基于Arrow构建。该项目由Wes McKinney(Pandas作者)发起,已成为数据工程领域的基础设施标准。
Polars是用Rust编写的DataFrame库,在数据处理速度上全面超越Pandas,内存效率提升3-5倍,特别适合处理GB级别的数据集。它利用Apache Arrow内存格式和并行查询执行引擎,提供了惰性求值(Lazy Evaluation)和查询优化能力。
Candle是Hugging Face开发的Rust深度学习框架,设计目标是轻量级和易部署。与PyTorch不同,Candle专注于模型推理场景,编译后的二进制文件可独立运行无需Python环境,大小仅数十MB,非常适合边缘设备和Serverless部署。
Hugging Face与Rust ML生态的推动:Hugging Face作为当前最具影响力的AI开源社区,在推动Rust进入ML生态方面发挥了关键作用。除了Candle推理框架外,其tokenizers库是最早也是最成功的Rust ML项目之一——它将NLP分词速度提升了数十倍,并通过PyO3提供Python绑定,实现了"Rust核心+Python接口"的架构模式。safetensors(安全的模型权重格式)也采用Rust实现,用于替代存在远程代码执行风险的pickle格式。Hugging Face的这些实践证明了一种可行的迁移路径:不需要完全放弃Python生态,而是将性能关键的底层组件用Rust重写,通过FFI或Python绑定暴露给上层应用。这种"渐进式Rust化"策略也可能是Rustuna未来发展的方向之一。
burn是另一个野心勃勃的Rust深度学习框架,支持多后端(CPU、CUDA、WebGPU),强调类型安全和可组合性。通过Rust的类型系统,burn能在编译时检测张量维度不匹配等常见错误。
ONNX Runtime生态:ONNX(Open Neural Network Exchange)是微软和Facebook主导的开放神经网络交换格式,定义了模型表示的标准协议。ONNX Runtime是其高性能推理引擎,支持CPU、GPU、边缘设备等多平台,通过图优化、量化、算子融合等技术加速推理。主流框架(PyTorch、TensorFlow、scikit-learn)都支持导出ONNX格式。ort库为Rust提供了ONNX Runtime绑定,让Rust程序能加载和运行ONNX模型,实现跨语言的模型部署。
此外,tokenizers(Hugging Face的分词库)、ort(ONNX Runtime的Rust绑定)等项目也在生产环境中广泛使用。这些工具共同构成了从数据处理、模型训练到推理部署的完整Rust ML工具链,虽然成熟度尚不及Python生态,但在特定场景下已显示出明显优势。
这一趋势反映了行业对性能和安全性要求的持续提升。随着模型规模和数据量的增长,Python的性能瓶颈日益突出,而Rust凭借系统级编程能力和现代语言特性,成为构建高性能ML基础设施的热门选择。
对于开发者而言,Rustuna也提供了学习Rust在ML领域应用的优质案例。通过研究其源代码,可以了解如何用Rust实现复杂的优化算法,以及如何在保持API友好性的同时充分发挥底层语言的性能优势。
未来展望与社区参与
作为一个新发布的项目,Rustuna目前还处于早期阶段,社区的反馈和贡献将是其走向成熟的关键。对于有Rust开发经验的ML从业者来说,这是一个参与开源项目、将两个领域知识相结合的好机会。
项目的长期发展将取决于几个核心因素:与Python版Optuna的功能完整性对比、在真实工作负载下的性能表现、文档和示例的完善程度,以及与现有ML生态系统的集成深度。
从更宏观的视角看,Rustuna的发布是对"用合适的工具解决合适的问题"这一理念的践行。它表明开源社区愿意投入资源去切实解决性能和安全层面的痛点,而非仅仅停留在既有方案上。这种工程文化的演进,最终将惠及整个机器学习社区。
核心要点
核心要点
相关推荐

Antigravity调用Gemini报错真相:IP风控实测与应对
Google Antigravity IDE调用Gemini模型频繁报错?实测发现同一账号仅切换IP即可恢复,且同IP在AI Studio仍可正常使用。本文解析这一基于IP的风控策略、成因推测及排查应对思路。
AI超级员工系统拆解:营销自动化工具的能力与风险
一款宣称"全接管基础岗位"的AI超级员工系统在B站流传,本文拆解其视频生成、数字人克隆、智能体和批量获客等功能,并客观分析其中的合规与安全风险,提醒用户警惕"免费领取"营销套路。
群像才是团体的灵魂:内娱几首氛围感满满的合唱盘点
从07届快男到NINE PERCENT,盘点内娱几首氛围感满满的群像合唱歌曲。相比单人高光与数据热度,一群人并肩同行的情谊才是团体无可替代的灵魂。