SAE特征能预测AI错误,但因果影响几何?

新研究审计SAE特征因果作用:能预测模型错误,却难以稳定纠错。
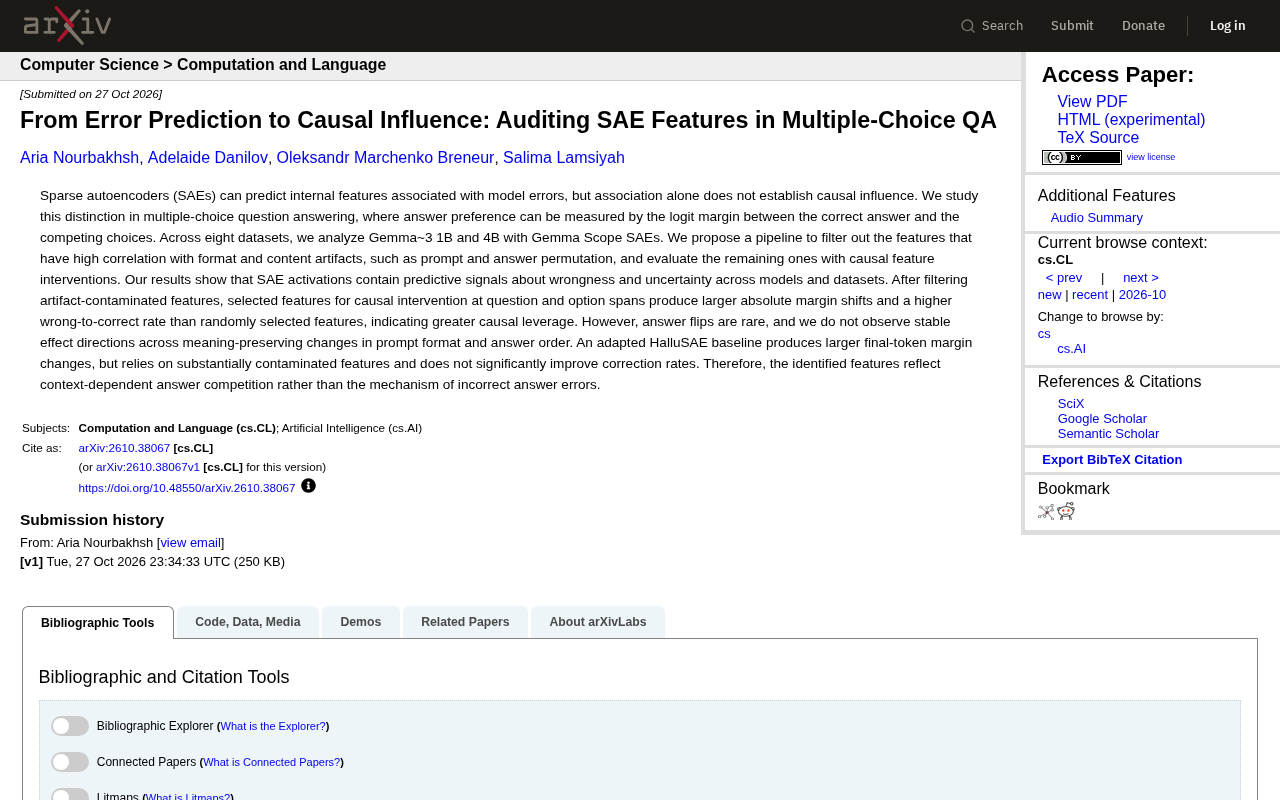
一项针对多选题问答的新研究系统审计了稀疏自编码器(SAE)特征的因果作用。研究在八个数据集上对Gemma 3 1B和4B模型使用Gemma Scope SAE进行分析,发现SAE激活中包含关于错误和不确定性的预测信号,且跨模型数据集一致。经过滤格式与内容伪影后,选定特征的因果干预比随机特征产生更大margin偏移和更高纠错率,但答案翻转罕见,且在语义保持的提示与选项变化下效应方向不稳定。对比HalluSAE基线发现其margin变化更大但依赖污染特征,纠正率无显著提升。结论认为这些特征反映上下文相关的答案竞争,而非错误产生机制,提示从预测到控制仍有距离。
稀疏自编码器(SAE)常被用来解读大模型内部特征,甚至预测模型会在哪些问题上出错。但相关性不等于因果性——一项针对多选题问答(MCQA)的新研究系统审计了SAE特征的因果作用,结论值得关注:特征能预测错误,却难以稳定地“修正”错误。
研究背景:从错误预测到因果干预
研究团队在八个数据集上,对Gemma 3 1B和4B模型使用Gemma Scope SAE进行分析。他们关注多选题场景中的答案偏好,用正确答案与竞争选项之间的logit margin(对数几率差)来度量。
核心问题很直接:SAE激活中与错误相关的信号,究竟只是反映了格式或内容伪影,还是真正具备因果杠杆?为回答这个问题,作者提出了一条过滤管线,先剔除与提示词、答案排列等格式和内容伪影高度相关的特征,再对剩余特征进行因果干预实验。
稀疏自编码器(SAE) 是一种无监督学习方法,通过将高维激活向量分解为稀疏的、可解释的特征方向,常用于探测大语言模型内部表征。其基本假设是:模型激活可表示为少量稀疏特征的线性组合,每个特征对应一种语义概念。Gemma Scope 是专为 Gemma 模型系列发布的 SAE 集合,提供不同层和不同稀疏度的预训练编码器,便于研究者直接提取特征而不必从头训练。
Logit margin(对数几率差) 指模型输出层中两个候选答案的 logit 值之差,在多选题中通常计算正确答案与最强竞争选项的差值。该指标能连续度量模型对答案的偏好强度,比单纯的准确率更细粒度,适合观察干预前后模型决策的微小变化。
关键发现:预测力强,因果力弱
预测信号确实存在
结果显示,SAE激活中包含了关于“错误”和“不确定性”的预测信号,且这一现象在不同模型和数据集上保持一致。这意味着,从内部激活中读出模型可能答错的信号是可行的。
过滤后仍有因果杠杆,但有限
经过伪影过滤后,被选中用于因果干预的特征(作用于问题片段和选项片段)相比随机特征,能产生更大的绝对margin偏移和更高的“从错到对”转化率。这说明这些特征确实具备一定的因果杠杆,而非纯粹的虚假相关。
但研究者也划出了明确的边界:答案翻转(answer flip)非常罕见,且在保持语义不变的提示格式和答案顺序变化下,没有观察到稳定的效应方向。换言之,特征的作用高度依赖上下文,换一种问法或选项顺序,效果就可能消失甚至反转。
因果干预在可解释性研究中通常指通过激活编辑(如放大、抑制或替换特定特征激活)来观察模型输出的变化。若编辑某特征能稳定地改变目标行为(如将错误答案改为正确答案),则该特征被认为具有因果杠杆。本研究中,作者对选定特征进行定向激活干预,并与随机选择特征的效果对比,以区分真实因果作用与虚假相关。
答案翻转(answer flip) 指模型最终选择的答案从错误变为正确(或反之)的离散事件。与连续的 margin 偏移不同,答案翻转要求干预强度足够大以跨越决策边界,因此更为罕见。该指标直接反映纠错成功率,是评估特征实用价值的关键。
基线对比暴露问题
研究还对比了一个改编的HalluSAE基线。该基线能带来更大的最终token margin变化,但其依赖的特征受到严重污染,且没有显著提升纠正率。这提示:看似更强的干预效果,可能来自伪影而非真正的因果机制。
这意味着什么
作者给出的结论颇为克制:识别出的特征反映的是上下文相关的答案竞争,而非错误答案产生的机制本身。换句话说,这些SAE特征更像是“竞争状态的读数”,而不是可以拿来精准纠错的“控制旋钮”。
对实践者的启示是:用SAE做错误预测或可解释性分析时,必须警惕格式伪影的干扰;若想把特征用于干预或纠错,需要更严格的因果验证,不能仅凭相关性下结论。
方法启示:审计管线值得借鉴
这项工作的价值不止于结论。其提出的伪影过滤+因果干预评估管线,为SAE特征审计提供了一个可复用的框架。在多选题这类答案空间有限、可精确度量margin的任务上,这套方法能有效区分“预测性特征”和“因果性特征”。
对于关注AI可解释性与模型可靠性的研究者而言,这项研究提醒我们:SAE打开模型黑箱的能力值得肯定,但从“看到”到“控制”之间,还有相当距离。
相关推荐

科幻小说对AI的预测有多准?
科幻小说对AI的预测有多准?本文结合Hacker News讨论,分析科幻作品在AI发展中的远见与盲区,探讨其真正价值在于启发思考而非精准预测。

SwarmEvolve:潜空间智能体集群加速进化搜索
SwarmEvolve框架让数百个低成本智能体在潜空间中集群推理,通过KV缓存共享信息,在数学发现和科学计算问题上实现快速进化搜索,中位数仅3-8分钟达到其他框架60分钟的最佳分数。

trainlint:静态检查揪出不会崩溃的 ML 训练 Bug
trainlint 是一个静态检查工具,能找出不会报错的机器学习训练 bug,包括数据泄漏、eval 模式残留、softmax 与 CrossEntropyLoss 冲突等十四类问题。本文介绍其原理、验证结果与局限。