SAGE:用Schema引导LLM做拨款评审,人机协作达成中高一致性
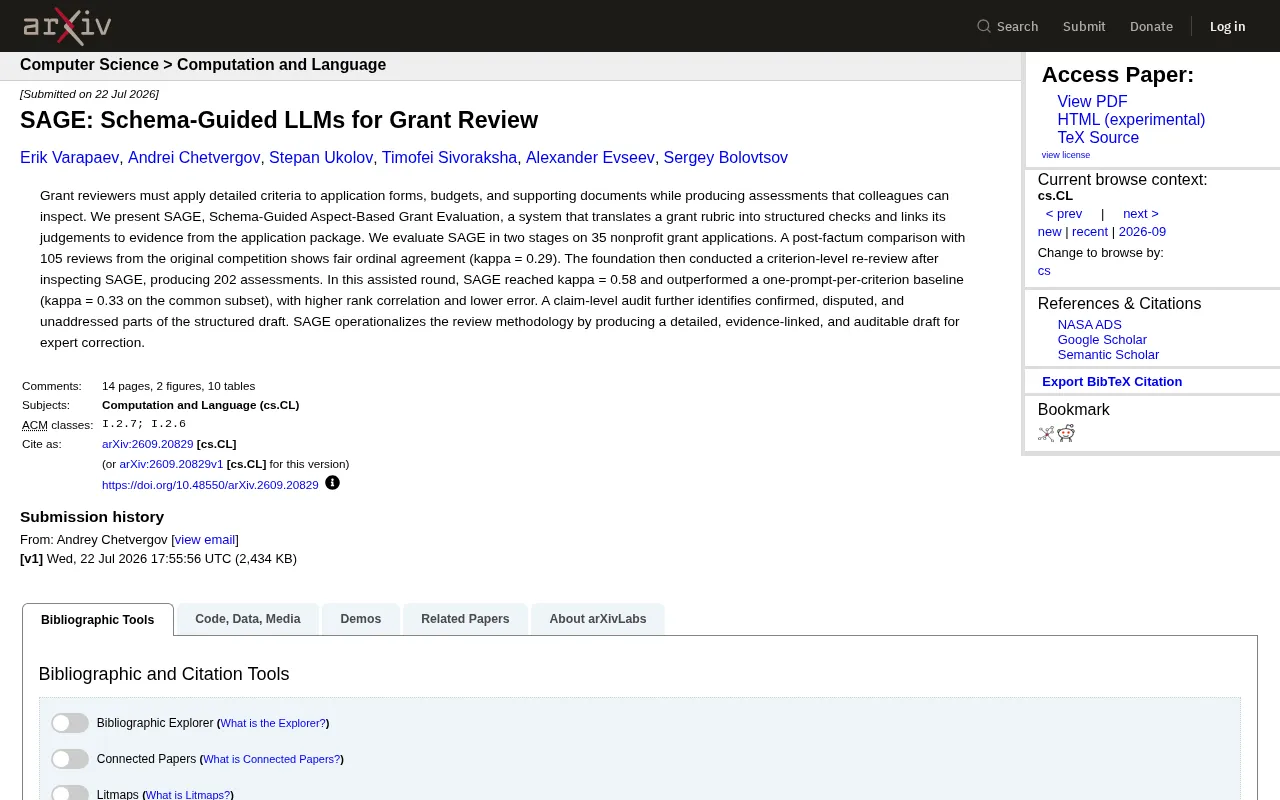
SAGE用结构化Schema引导LLM生成可审计的拨款评审初稿,辅助模式下一致性kappa达0.58。
SAGE(Schema-Guided Aspect-Based Grant Evaluation)是一个将拨款评分标准翻译为结构化检查项、并把每项判断与申请材料证据绑定的LLM辅助评审系统。研究者在35份非营利组织拨款申请上分两阶段测试:纯自动化模式下与人工评审的序数一致性为kappa=0.29(一般水平),而在人类专家基于SAGE输出进行逐条复审的辅助模式下,一致性提升至kappa=0.58(中高水平)。对照实验显示,简单的"每条标准一个提示"基线仅达0.33,证明结构化Schema设计本身是性能提升的关键。SAGE还引入声明级审计机制,将草稿中每个判断标注为已确认、有争议或未覆盖,帮助专家快速定位需要重点审查的环节,兼顾效率与透明度。
拨款评审的难题:既要严谨又要可审计
拨款评审是一项高度依赖专业判断的工作。评审员必须依据详细的评分标准(rubric),对申请表、预算和支撑材料逐一核对,同时还要产出可供同行检验的评估意见。这意味着评审不仅要准确,还要透明——每一个判断背后都应有清晰的依据。
然而,人工评审在规模化时面临一致性差、耗时长、难以追溯的问题。不同评审员对同一份申请可能给出差异很大的意见,而这些意见往往缺乏与具体证据的明确关联。一篇发表于 arXiv 的最新研究提出了名为 SAGE 的系统,试图用结构化的方式让大语言模型(LLM)参与到这一流程中。
SAGE 是什么:把评分标准翻译成结构化检查
SAGE 的全称是 Schema-Guided Aspect-Based Grant Evaluation(基于 Schema 引导的方面化拨款评估)。它的核心思路是将拨款评审的评分标准(rubric)翻译成一系列结构化的检查项,并把每一项判断与申请材料包中的具体证据建立链接。
这种设计有两个关键价值。其一,它把模糊的评审标准拆解为可操作的检查逻辑,降低了随意性;其二,通过将判断与证据绑定,SAGE 产出的不是一个黑箱式的结论,而是一份可审计的草稿——评审专家可以逐条查看、确认或修正模型的判断。
换句话说,SAGE 并不试图取代人类评审员,而是把方法论落地为一个「详细、证据关联、可审计」的初稿,供专家修正。这一定位与当前 AI 辅助专业决策的主流思路一致:机器负责结构化和初筛,人类负责最终裁定。
两阶段评估:从事后对比到辅助复审
研究团队在 35 份非营利组织的拨款申请上,分两个阶段评估了 SAGE 的表现。
第一阶段:事后对比
研究者将 SAGE 的评估结果与原始竞赛中的 105 份人工评审进行对比,得到的序数一致性(ordinal agreement)为 kappa = 0.29,属于「一般」水平。这个数字并不算高,但它反映的是 SAGE 在无人干预、纯自动化状态下与历史人工评审的吻合度。考虑到人工评审本身也存在显著的内部差异,0.29 的结果说明模型至少捕捉到了部分评审逻辑,但离可靠还有距离。
Cohen's Kappa(κ)是衡量两个评审者之间一致性的统计指标,它在原始百分比一致率的基础上,剔除了纯粹由随机因素造成的巧合一致,因此比简单的「答对率」更严格。通常的解读标准为:κ < 0.20 视为极弱一致,0.21–0.40 为一般(fair),0.41–0.60 为中等(moderate),0.61–0.80 为较强(substantial),0.80 以上为近乎完美。值得注意的是,即使是经验丰富的人类专家在同一任务上,组间 Kappa 往往也只在 0.4–0.6 之间,因此 0.29 的「一般」水平并不意味着模型毫无价值,而更多反映了拨款评审本身主观性强、任务难度高的特点。
第二阶段:辅助复审
更有说服力的是第二阶段。基金会在检视了 SAGE 的输出后,进行了一次逐条标准的再评审,共产出 202 项评估。在这一「人机协作」的模式下,SAGE 的一致性提升到 kappa = 0.58,达到了中高水平。
这一结果的意义在于:当人类专家把 SAGE 作为参考并在此基础上复审时,评审的整体一致性显著改善。这印证了 SAGE 的核心定位——它是一个辅助工具,其价值在协作场景中才能充分释放。
结构化方法胜过简单提示
为了验证结构化设计本身的价值,研究团队还设置了一个对照基线:即「每条标准用一个提示」(one-prompt-per-criterion)的简单方案。
在共同子集上,这个基线只达到了 kappa = 0.33,而 SAGE 达到 0.58。此外,SAGE 在排序相关性(rank correlation)上更高,错误率更低。这组对比说明,简单地把评分标准逐条丢给 LLM 并不足够——将标准翻译成结构化检查、并把判断锚定到证据的方法论设计,才是性能提升的关键。
这一发现对 AI 应用开发有普遍启示:在专业领域引入 LLM 时,精心设计的结构化框架(schema)往往比堆砌 prompt 更能带来稳定、可靠的结果。
声明级审计:区分确认、争议与未覆盖
SAGE 的另一个亮点是它引入了**声明级审计(claim-level audit)**机制。系统会对结构化草稿中的每一个判断进行标注,识别出哪些部分是「已确认的」(confirmed)、哪些是「有争议的」(disputed)、哪些是「未被覆盖的」(unaddressed)。
这种细粒度的审计能力,让评审专家能够快速定位需要重点关注的环节,而不必从头逐字核对整份草稿。它既提升了效率,也强化了整个评审流程的透明度和问责性——这正是拨款评审这类高利害决策所迫切需要的。
声明级审计(claim-level audit)的设计思路借鉴了自然语言处理中的「细粒度可解释性」研究方向。传统的 AI 辅助决策系统往往只输出一个总体评分或结论,使人类专家难以判断模型在哪些地方可信、哪些地方需要存疑。声明级审计通过将草稿拆解为最小可验证单元,并为每个单元标注证据状态,实质上是在构建一条从「申请原文」到「评审结论」的可追溯推理链。这种设计在医疗、法律等高利害领域的 AI 辅助系统中越来越常见——当出错的代价很高时,「知道模型在哪里不确定」往往比「知道模型给出了什么答案」更有价值。
意义与展望
SAGE 提供了一个值得借鉴的范式:在专业评审场景中,AI 的最优角色不是「替代裁判」,而是「生成可审计的初稿」。通过 schema 引导、证据链接和声明级审计三重设计,它把评审方法论真正地工程化落地。
从数据看,SAGE 在辅助模式下 kappa = 0.58 的表现,虽然还谈不上完美,但已经明显优于简单基线,并展示了人机协作的潜力。对于长期受困于评审一致性和可追溯性问题的资助机构而言,这类工具或许能带来实质性的流程改进。
当然,35 份申请的样本规模仍然有限,模型在更大规模、更多样化的评审场景中的泛化能力还有待检验。但作为一次将结构化方法与 LLM 结合应用于严肃决策的探索,SAGE 的思路无疑具有参考价值。
相关推荐
Asana AI产品负责人分享AI Agent最佳实践
Asana AI产品负责人分享AI Agent最佳实践,涵盖职责边界设定、人在回路设计、数据模型锚定以及评估迭代方法,为产品团队落地Agent提供可参考的原则。
日本互联网巨头GMO遭黑客泄密:云服务漏洞致客户数据外泄
日本GMO Internet证实云服务遭黑客攻击,客户数据疑被公开。公司正核实泄露数据真实性,事件凸显云服务安全风险与供应链攻击威胁。

苹果为Pages、Keynote、Numbers加入AI助手
苹果为Keynote、Pages、Numbers引入AI助手,基于苹果与OpenAI模型,可理解文档上下文,在Keynote中设计动画幻灯片、在Pages中起草和重构文档,生产力套件AI竞争升级。