三个月从零入门深度学习:一份高效AI自学路线图
以应用为导向的三个月AI自学路线:基础半个月,深度学习两个多月,优先视觉方向再扩展NLP与大模型。
这份由B站UP主分享的三个月AI自学路线图,核心理念是「基础够用即可、时间盒子推进」。它将Python、数学、机器学习三块基础压缩在半个月内完成,不纠缠公式推导,随后把剩余两个多月全部投入深度学习。入门方向优先选择计算机视觉,因为其直观性强,且所积累的神经网络基础能低成本迁移到自然语言处理等其他领域。NLP阶段则建议绕过传统基本功,直接聚焦大模型和智能体的应用开发,以贴近当下就业市场。数据挖掘被列为按需选修。这套路线图适合以工程就业为目标的初学者,但对有志于科研或深度调优的学习者而言,跳过的数学与理论功底仍需日后补齐。
对于想要快速切入人工智能领域的初学者来说,最大的痛点往往不是缺少资料,而是不知道如何分配有限的时间。一份来自B站UP主的三个月AI自学路线图给出了明确的时间规划思路:与其在基础上无限打磨,不如以应用为导向、快速推进到深度学习的核心方向。本文对这套路线图做梳理与解读。
基础阶段:Python与数学不超过一周
路线图的核心理念是「基础够用即可」。作者建议把 Python 和数学的学习时间控制在一周以内,理由很直接:这些基础只是为后续内容做铺垫,并不需要精通。
了解基本语法、掌握基本概念就足够开始下一步。在如今的开发环境下,智能体(AI Agent)已经可以协助写代码、读论文,前期完全没必要在 Python 和数学上死磕。这个观点虽然可能引起争议,但对于以就业和应用为目标的学习者来说,确实能大幅降低入门门槛。
机器学习:了解思想,不抠公式推导
机器学习部分同样建议控制在一周左右。作者提出了一个反直觉但务实的判断:机器学习学得越多,负担可能越重,反而越不愿意往下推进。
具体做法是把十大经典算法「刷一刷」,了解每个算法的基本思想即可——知道这个算法是做什么的、如何建模、输入什么数据、输出什么结果。至于公式推导和底层逻辑,暂时可以跳过。这样,Python、数学、机器学习三块基础合计大约半个月就能搭建起来。
深度学习:先从计算机视觉切入
打完基础后,剩下的两个多月全部投入深度学习。作者建议在三个方向中做选择:计算机视觉、自然语言处理、数据挖掘。
推荐首选计算机视觉,原因是它相对不抽象,是「看得着摸得着」的东西,学起来更有直观感受。这一阶段需要先掌握深度学习的基础:神经网络、各类网络结构、卷积神经网络等,再进入检测、分割、识别等具体任务,预计需要一个月左右。
卷积神经网络(CNN)是计算机视觉的核心基础架构,其设计灵感来自生物视觉皮层对局部感受野的响应机制。与全连接网络不同,CNN通过卷积核在图像上滑动提取局部特征,大幅减少了参数数量,同时具备平移不变性——即无论目标出现在图像哪个位置,网络都能识别出来。掌握CNN之后,检测(如YOLO系列)、分割(如U-Net)、识别等具体任务都建立在这一基础之上,因此该基础模块的学习投入会在后续任务中持续复用,学习效率较高。
方向拓展:底层逻辑不变,切换成本低
很多初学者担心学完一个方向后,转向其他领域是否又要从头再来。作者给出了否定的答案。
在学习计算机视觉的过程中,你已经熟悉了大量神经网络基础和网络结构。后续拓展到其他方向,本质上只是「输入数据不同、输出结果不同」,而中间的算法逻辑是不变的。这意味着第一个方向学得扎实,后面的拓展会非常轻松。
自然语言处理:以大模型和智能体为重点
转向自然语言处理时,作者建议不必再纠结传统的基本功,因为在当前「清一色大模型、清一色智能体」的环境下,很多传统基本功已经用不上了。
学习重点应放在大模型和智能体上,并以应用为导向。从就业角度看,应用方向的岗位更多、求职机会更广,入门难度相对也较低。这是一条更贴近实际市场需求的路径选择。
大模型(Large Language Model,LLM)通常指参数量达到数十亿乃至数千亿级别、基于Transformer架构预训练的语言模型,代表性产品包括GPT系列、LLaMA、Claude等。智能体(AI Agent)则是在大模型之上封装了工具调用、记忆管理和任务规划能力的系统,能够自主分解目标、调用外部API并逐步执行复杂任务。对于应用导向的学习者,核心技能包括提示词工程(Prompt Engineering)、检索增强生成(RAG)、以及使用LangChain、LlamaIndex等框架搭建Agent流水线,这些能力在当前工程岗位中需求旺盛,且不要求深厚的数学背景。
数据挖掘:按需选修
数据挖掘被定位为「按需选修」的方向。如果学完前两个方向后还有时间和兴趣,可以再补上数据挖掘,比如时间序列、图神经网络,或者参加相关竞赛来实战练手。
路线图的价值与局限
这套路线图的最大价值在于「时间盒子」思维——为每个阶段设定明确的时间上限,避免初学者陷入无止境的基础学习中。它以应用和就业为导向,符合当下大模型时代的技术现实。
不过也需要辩证看待:跳过公式推导和底层逻辑固然能加快入门,但如果目标是研究或需要深度调优模型,扎实的数学与理论功底仍不可或缺。这份路线图更适合以工程应用和快速就业为目标的学习者,而非科研方向。三个月能否真正「入门」,很大程度上取决于每天投入的强度和实践的深度。
「时间盒子」(Timeboxing)是一种项目管理与学习策略,核心思路是为某项任务预先设定固定时间上限,时间到了就强制推进,而非等到「学满意了」再继续。这种方法能有效对抗完美主义导致的拖延,尤其适合技术学习场景——因为基础知识的边界几乎无限,若不设时间约束,初学者极易陷入永远在「打基础」的循环而迟迟进不了核心领域。代价是对某些概念的理解会停留在使用层面,遇到复杂问题时可能需要回头补课,因此这一策略的适用性与个人目标(工程应用 vs. 学术研究)高度相关。
相关推荐
AI Agent智能体入门:大脑、记忆与工具三要素详解
从零理解AI Agent智能体:详解大脑、记忆、工具三大核心组件,梳理大模型从原生模型、提示工程、RAG到Agent的四阶段演进,帮你搞懂Agent到底解决了什么问题以及为何值得学习。
抵制不支持Linux的软件:一位开发者的选择哲学
一位只用Linux的开发者分享他抵制不支持Linux软件的选择哲学:不牺牲生产力,用编程Agent扩展开源工具,并点评Valve、Proton、Omarchi等推动Linux主流化的力量。
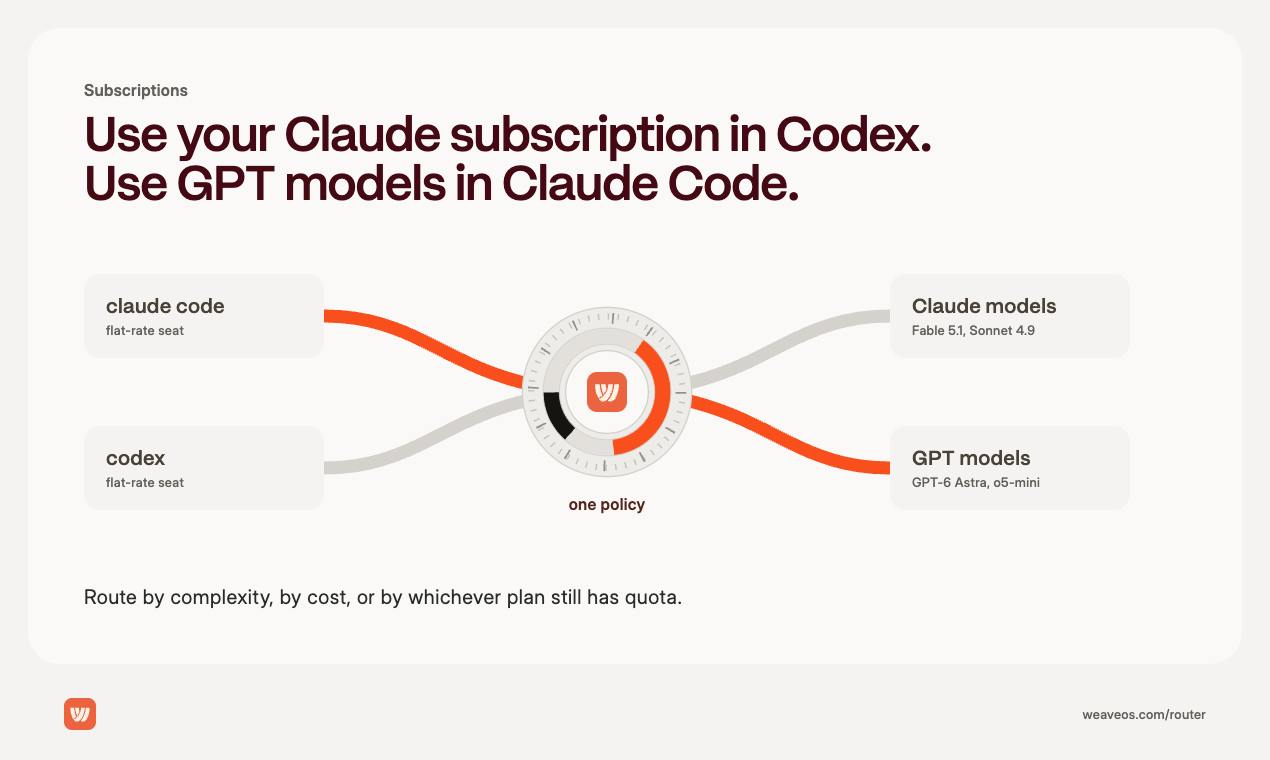
Weave Router 2.0:跨订阅智能路由的编程助手调度器
Weave Router 2.0 是一款订阅感知的 AI 编程助手路由器,可跨 Claude、Codex、GPT 订阅自动调度请求。官方称在 Terminal-Bench 4.0 与 SWE-Atlas 上对标 GPT-6 Astra,成本减半、速度翻倍。