SGLang v0.5.20 发布:高性能LLM推理引擎再迭代

SGLang 发布 v0.5.20,这一高性能 LLM 推理框架凭借 RadixAttention 等技术持续高频迭代。
SGLang 近日发布 v0.5.20 版本,这是该开源大模型推理框架在 0.5.x 系列中的最新迭代。SGLang 以结构化生成语言与高效推理运行时为核心,通过 RadixAttention 技术实现 KV 缓存的前缀复用,在多轮对话、批量推理等场景下显著降低延迟、提升吞吐。项目目前在 GitHub 拥有超过 36.1k Star,保持接近每周一次的发布频率,体现出团队对新模型架构和量化方案的快速跟进能力。对于正在部署或评估 LLM 推理基础设施的团队,升级前建议仔细核查官方 Release Notes 中的兼容性说明。
SGLang v0.5.20 版本发布
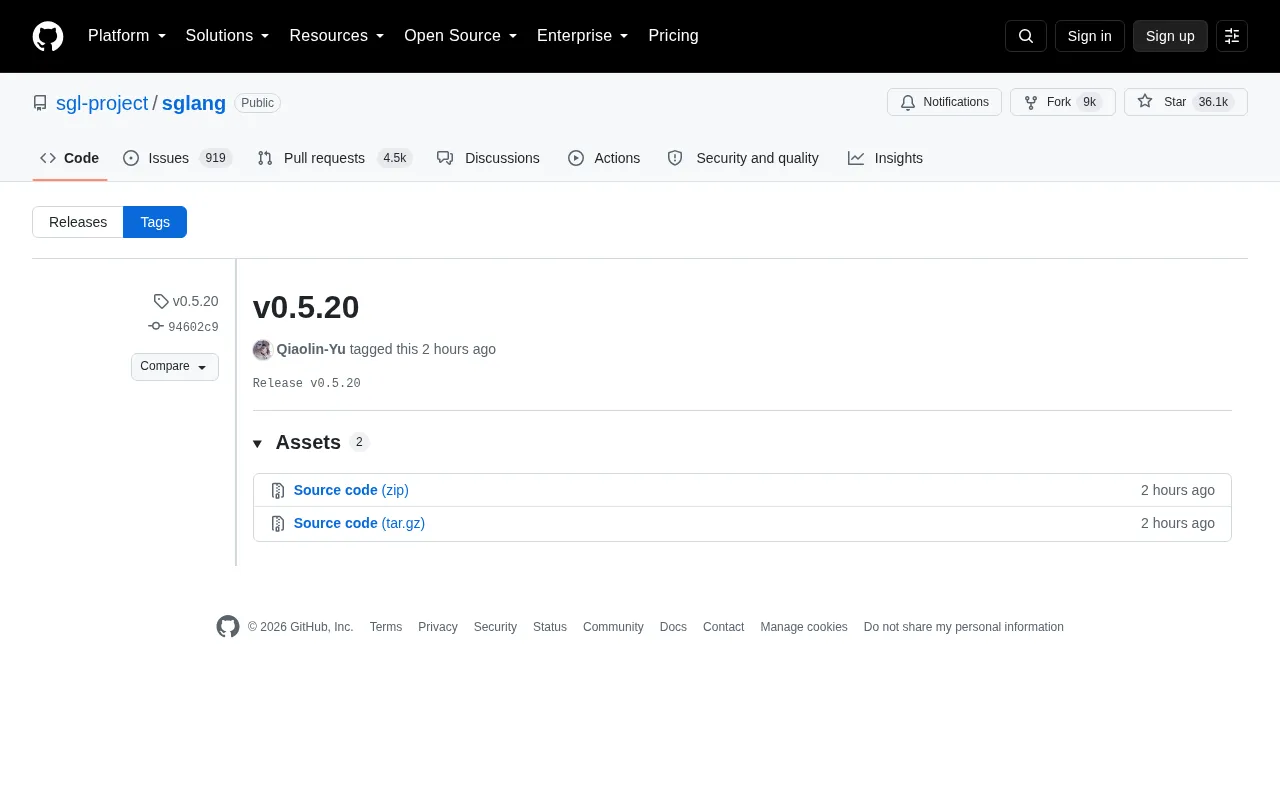
开源大模型推理框架 SGLang 近日发布了 v0.5.20 版本。作为当前最受关注的 LLM 服务化引擎之一,SGLang 由 sgl-project 团队维护,目前在 GitHub 上已积累超过 36.1k Star 和 9k Fork,社区活跃度可观。本次版本由维护者 Qiaolin-Yu 打标发布,延续了该项目高频迭代的一贯节奏。
对于关注大模型部署与推理性能优化的开发者而言,SGLang 是绕不开的基础设施选择之一。它主打结构化生成语言(Structured Generation Language)与高效的推理运行时,能够在保证吞吐的同时降低延迟,广泛应用于大规模在线推理场景。
SGLang 是什么
SGLang 是一个面向大语言模型和视觉语言模型的高性能服务框架。它的核心价值在于将前端的编程接口与后端的推理运行时深度协同,通过 RadixAttention 等技术实现 KV 缓存的高效复用,从而在多轮对话、复杂提示词编排等场景下显著提升性能。
相比传统的推理方案,SGLang 的设计理念强调「服务化」与「可编程性」并重。开发者既可以用它快速搭建高并发的推理服务,也能借助其结构化生成能力,精确控制模型输出的格式与流程。这种双重定位让它在生产环境中获得了广泛采用。
RadixAttention 是 SGLang 的核心创新之一,其原理是将 KV Cache(键值缓存)以前缀树(Radix Tree)的数据结构进行组织和索引。在传统推理方案中,每次请求都需要重新计算提示词对应的 KV 值;而 RadixAttention 能够识别不同请求之间共享的前缀部分,直接复用已缓存的计算结果。这在系统提示词(System Prompt)固定、多轮对话或批量文档问答等场景下效果尤为突出,可大幅减少重复计算开销,显著提升整体吞吐量并降低首 Token 延迟(TTFT)。结构化生成(Structured Generation)则指约束模型输出严格符合特定格式,如 JSON Schema、正则表达式或自定义语法,这对需要可靠解析模型输出的下游应用至关重要。
v0.5.x 系列的迭代意义
从版本号 v0.5.20 可以看出,SGLang 目前正处于 0.5.x 系列的密集迭代阶段。这类小版本更新通常聚焦于三个方向:性能优化、对新模型架构的支持,以及稳定性修复。
开源推理框架的竞争核心在于「跟得上」——每当业界出现新的模型架构或量化方案,能否第一时间提供高效支持,往往决定了框架的实际竞争力。SGLang 保持接近每周一次的发布频率,本身就说明了其背后团队对社区需求的快速响应能力。
对使用者来说,及时跟进这类版本更新意味着可以第一时间用上最新的性能改进和模型兼容性支持。不过需要提醒的是,生产环境升级前仍应仔细阅读官方 Release Notes,验证具体的变更项与潜在的兼容性影响。
量化方案(Quantization)是当前推理优化的重要方向,指将模型权重从高精度浮点数(如 FP16/BF16)压缩为低精度表示(如 INT8、INT4 甚至更低比特),以换取更小的显存占用和更快的计算速度。常见的量化方法包括 GPTQ、AWQ、FP8 等,不同方案在精度损失与推理加速之间存在不同的权衡。推理框架对新量化格式的支持速度,直接影响用户能否第一时间将压缩后的模型投入生产。SGLang 的高频发布节奏,在很大程度上正是为了快速跟进 Llama、Qwen、Gemma 等主流模型系列的新版本发布以及社区涌现的新量化技术。
如何获取与升级
用户可以通过项目的 GitHub Releases 页面获取 v0.5.20 的发布资产(Assets),或直接通过包管理工具升级到最新版本。建议在升级前查阅官方文档中对应版本的详细更新说明,确认所依赖的功能未发生破坏性变更。
对于正在评估推理框架的团队,SGLang 高达 36.1k 的 Star 数量与活跃的贡献者社区,是衡量其项目健康度与长期可维护性的重要参考指标。持续的高频发布也表明该项目在可预见的未来会保持积极维护。
小结
SGLang v0.5.20 是该项目稳步演进中的又一个节点。虽然本次发布的具体变更细节需要参考完整的更新日志,但从项目整体的活跃度、社区规模与迭代节奏来看,SGLang 依然是当前 LLM 推理部署领域值得重点关注的开源基础设施。对于追求高吞吐、低延迟推理性能的开发者与团队,持续跟踪其版本迭代是明智之举。
相关推荐

REA:无需编码,用AI逆向任意应用
REA是一款爆火GitHub的开源AI逆向工程工具,可让Claude、Codex等AI代理直接分析任意应用并生成功能克隆,无需编码。本文介绍其工作原理、安装方法、实测案例及法律风险。

2026年AI编程工具横评:Claude、ChatGPT、Gemini谁最强?
2026年五款主流AI编程工具横评:Claude Code、ChatGPT Codex、Gemini、DeepSeek和GitHub Copilot在真实项目、定价与代码质量上的全面对比,帮你决定每月20美元该花给谁。

ChatGPT Codex克隆任意软件?实测风险与真相
YouTube短视频宣称用ChatGPT Codex或Claude Code即可克隆Adobe、Excel、Figma等软件并终身免费使用。本文拆解其技术可行性、法律风险与私信引流套路,说明AI编程工具真正适合的用法。