vLLM Worker侧GPU KV Cache初始化流程深度解析

在vLLM的推理引擎中,KV Cache的管理是决定显存利用率和吞吐量的核心机制。
KV Cache技术背景
KV Cache(Key-Value Cache)是Transformer模型推理加速的核心技术。在自回归生成过程中,每生成一个新token都需要用到之前所有token的Key和Value向量。如果每次都重新计算,会造成大量冗余计算。KV Cache通过缓存已计算的Key-Value对,使得每步只需计算新token的KV,然后与缓存拼接使用。这项技术可将推理时间复杂度从O(n²)降低到O(n),但代价是需要占用大量显存。一个典型的LLaMA-70B模型在处理4096个token时,KV Cache可能占用数十GB显存,因此如何高效管理KV Cache的显存成为推理系统的核心挑战。
为了更直观地理解这一挑战的严峻程度,我们可以做一个具体的计算。以LLaMA-70B为例,它有80层、8个KV头(使用GQA机制)、每个头维度128、使用FP16精度。单个token的KV Cache大小为:80层 × 8头 × 128维 × 2(K+V) × 2字节(FP16) ≈ 640KB。当支持4096长度的序列时,单条请求就需要约2.5GB显存;如果要同时处理32条请求,仅KV Cache就需要80GB——这几乎耗尽一张H100的全部显存。因此,哪怕1%的显存碎片率,在这个量级下都意味着数GB的浪费,直接影响可并发处理的请求数量。这也正是vLLM在KV Cache管理上如此精细化设计的根本原因。
除了通过精细的显存管理来提升利用率之外,KV Cache本身的压缩也是降低显存占用的重要手段。FP8 KV Cache将原本FP16的2字节存储压缩为1字节,理论上可将KV Cache显存减半,且对模型质量的影响通常在可接受范围内。更激进的INT4量化可以进一步压缩到0.5字节,但可能需要配合校准数据来保证精度。vLLM通过int8字节数组分配+reshape的设计,天然地支持了这些不同精度格式的KV Cache——分配时按字节计算总量,reshape时根据实际精度确定元素数量和维度,无需修改底层分配逻辑。
前面我们已经了解了KVCacheConfig是如何生成的,以及它如何被调度侧的SchedulerConnector(AsyncLLM/EngineCore一侧)消费来建立逻辑上的block pool与block table。但这些都是逻辑层面的抽象——真正的物理显存分配,发生在Worker侧。
本文将聚焦于KVCacheConfig在Worker侧的消费流程:Worker是如何根据配置在GPU上真正分配KV Cache张量,又是如何把逻辑block映射到物理显存位置的。
KVCacheConfig的传递路径
KVCacheConfig从生成到被Worker消费,经历了一条相对漫长的调用链。整个流程可以拆分为几个关键阶段。
vLLM架构与分离式设计
vLLM采用了经典的调度-执行分离架构。调度侧(EngineCore/AsyncLLM)负责请求管理、序列调度和逻辑资源分配,它维护着逻辑层面的block table,决定哪些请求应该被处理、需要多少资源。执行侧(Worker)则负责实际的模型推理和物理显存管理。这种分离带来了多个好处:调度逻辑与硬件解耦,可以支持多种后端;调度器可以在不了解GPU细节的情况下做全局优化;Worker可以专注于高效执行。两侧通过RPC通信,调度器下发执行指令,Worker返回执行结果。
在通信层面,vLLM在单机场景下使用ZeroMQ(zmq)作为RPC框架,它是一个轻量级的异步消息库,支持多种通信模式。在分布式场景下,vLLM还借助Ray框架来管理多节点的Worker。RPC调用传递的不仅是KVCacheConfig,还包括调度决策、模型输入数据以及Worker的执行结果。通信开销需要被最小化,因为它直接影响端到端延迟——这也是为什么vLLM尽量将频繁变化的数据(如block table更新)设计为轻量级的整数映射,而非序列化整个Tensor。这种架构在分布式推理场景下尤其重要,因为调度器需要协调多个GPU Worker的工作。
在Worker启动阶段,会先经过init_worker、init_device、加载模型、执行Profile与投影等步骤。之后进入KV Cache初始化环节,其起点是EngineCore。
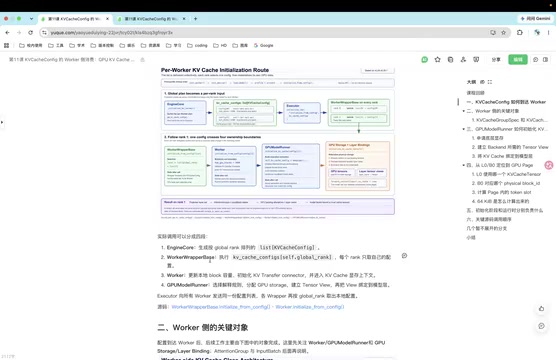
EngineCore从每个GPU、每个Worker上采集模型与硬件信息之后,会构造出一个KVCacheConfig的list——注意,是一个列表,其中包含了每个Worker各自对应的配置。随后这个list通过RPC调用传递给WorkerWrapperBase。
分布式推理中的Rank概念
在多GPU分布式训练或推理中,每个进程/设备都有一个唯一的标识符。global_rank是进程在整个集群中的全局编号(如0到15),local_rank是进程在单机内的编号(如0到7)。这些编号用于:确定进程应该加载模型的哪个分片(模型并行)、分配哪块数据(数据并行)、使用哪个GPU设备、在集合通信中的身份标识等。在vLLM中,EngineCore会为所有Worker生成一个配置列表,列表的每个元素对应一个Worker。WorkerWrapperBase根据自己的global_rank从列表中取出属于自己的配置,这样每个Worker就知道自己应该管理多少KV Cache、使用哪些资源。这种设计使得相同的代码可以在不同Worker上运行,只需通过rank区分即可。
关键点在于:WorkerWrapperBase会根据当前的global_rank,从整个配置列表中选取属于自己的那份Local Config。这一步完成了从"全局配置"到"本地配置"的收敛,之后才把真正的初始化任务交给Worker。
四个核心阶段
整个Worker侧的初始化可以概括为四个阶段:
- EngineCore生成KVCacheConfig的list
- WorkerWrapperBase按rank选择自己的Config
- Worker完成一些前置初始化,并设置block数量
- GPUModelRunner执行真正的显存分配,并将KV Cache绑定到模型
可以看到,Worker本身更多扮演"资源编排者"的角色,而真正干活、执行物理分配的是它所持有的ModelRunner。
各层职责与数据结构
理解这套机制,需要先厘清几个关键结构的职责关系。
KVCacheConfig的组成
KVCacheConfig本质上是当前Worker的一份"资源合约",主要包含三部分:
- num_blocks:可用的block数量,含义比较直观。
- KVCacheGroups (KVCacheGroupSpec):描述哪些层共用同一个逻辑的block table,表达的是逻辑顺序与缓存策略分组。
- KVCacheTensors (KVCacheTensor):主要给Worker使用,描述Worker申请的物理存储槽位,用一系列字段标识具体的显存位置。
混合注意力机制
现代大模型常采用混合注意力架构来平衡性能与效率。Full Attention让每个token关注所有历史token,捕获长距离依赖但计算量大;Sliding Window Attention只关注最近的若干token(如4096个),降低计算复杂度;还有Group Query Attention(GQA)让多个查询头共享同一组KV,减少KV Cache大小。一个模型的不同层可能使用不同的注意力机制:底层用Full Attention捕获全局语义,上层用Sliding Window提升效率。
Sliding Window Attention(SWA)不仅降低了计算复杂度,还为KV Cache管理带来了独特的优化空间。由于SWA只关注最近W个token(如W=4096),超出窗口的旧token的KV数据可以被安全回收。这意味着使用SWA的层所需的block数量有一个固定上限(W/block_size),不会随序列长度无限增长。在vLLM中,Full Attention组的block会持续增长直到序列结束,而SWA组的block数量被限制在窗口大小范围内,超出窗口的block会被及时释放回block pool。Mistral和Mixtral等模型正是采用了这种交替使用Full Attention和SWA的架构,vLLM的Group分组机制完美地支持了这种模式。
这种混合设计给KV Cache管理带来挑战:不同层需要的Cache大小和访问模式不同,需要统一的抽象来管理。vLLM通过Group机制将使用相同注意力策略的层分组,每组共享一个逻辑block table,从而优雅地支持混合架构。
这里有一个容易混淆的点需要特别强调:同一个Group内的层,通常分布在不同的Tensor中;而不同Group但处于相同槽位(slot)的层,反而可能位于同一个Tensor里。这种设计正是为了支持混合注意力布局,后文会用具体例子说明。
Worker与ModelRunner的协作
Worker持有ModelRunner,后者才是真正的"装配工"。ModelRunner负责:
- 管理
KVCacheAttentionGroup(即KV Cache的输入分组) - 执行Tensor的物理分配
- 完成类型转换,将无类型字节数组转换为具体模型对应的KV Cache视图
- 将最终的Tensor视图绑定到Attention层上
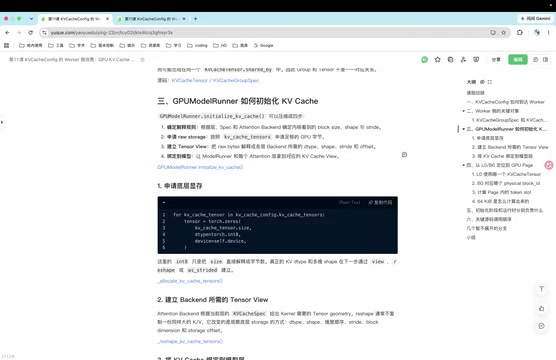
绑定完成后,推理过程中Attention层就能直接拿到对应的KV Cache张量视图进行读写。在实际计算时,vLLM通常使用FlashAttention或FlashInfer等高效注意力内核来执行Attention运算。这些内核通过分块计算(tiling)和在线softmax技术,将注意力计算的显存复杂度从O(n²)降低到O(n),同时最大化GPU的计算吞吐。FlashAttention要求KV Cache以特定的内存布局存储(如[num_blocks, block_size, num_heads, head_dim]),vLLM的reshape步骤正是将字节数组转换为这种内核期望的布局。不同的注意力后端(如FlashAttention v2、xFormers、FlashInfer)可能要求不同的内存布局,vLLM通过在reshape阶段适配不同后端的需求来实现后端的可插拔性。
ModelRunner的显存分配流程
ModelRunner的初始化主要分为三步:确定解释规则(初始化banking等辅助类)、执行显存分配、执行类型转换并绑定到模型。
第一步:物理分配
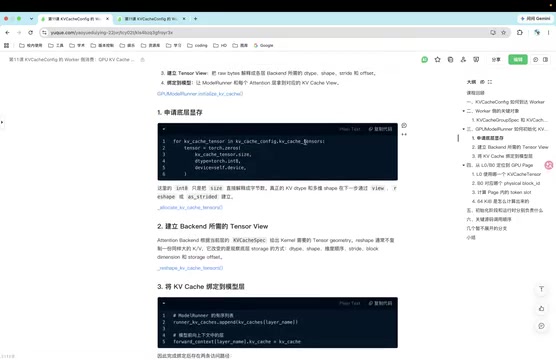
真正分配显存的逻辑,是遍历KVCacheTensor逐个分配。有意思的是,分配时使用的是int8类型——也就是说,vLLM实际上是按字节(Byte)分配一块无类型的字节数组。这种设计带来了极大的灵活性。
选择int8(字节)类型而非直接用模型精度类型(如FP16/BF16)来分配,是一个深思熟虑的工程决策。首先,不同精度格式的element大小不同(FP16为2字节,FP8为1字节,INT4为0.5字节),用字节数组可以统一处理所有精度类型,甚至可以在同一个Tensor内混合不同精度的层。其次,某些量化方案(如GPTQ、AWQ)在存储KV Cache时可能涉及非标准的数据布局,字节数组提供了最大的灵活性。最后,PyTorch/CUDA的显存分配器在处理大块连续分配时效率最高,一次性分配一大块字节数组再reshape,比分多次小块分配要高效得多,也避免了显存碎片问题。
值得深入了解的是PyTorch底层显存分配器的工作机制。PyTorch使用基于CUDA的缓存显存分配器(Caching Allocator),它维护一个空闲块池来避免频繁调用cudaMalloc/cudaFree。每次分配请求会先尝试从空闲池中找到合适大小的块,找不到时才调用底层CUDA API分配新块。释放时不会立即归还给CUDA,而是放回空闲池。这种机制减少了系统调用开销,但也可能导致"显存碎片"——空闲池中有足够总量的显存,但没有单块足够大的连续空间。vLLM的策略是在初始化时一次性分配少量大块连续显存(而非运行时频繁分配小块),这既避免了分配器的碎片问题,也绕过了缓存分配器的查找开销。此外,GPU显存的访问需要遵循特定的对齐要求(通常为128字节或256字节),vLLM的block大小和KV Cache维度设计都考虑了这一点,确保每个block的起始地址自然对齐到GPU的最优访问边界,从而最大化显存带宽利用率。
第二步:视图转换(reshape)
Tensor视图与零拷贝技术
在深度学习框架中,Tensor的reshape操作是一种零拷贝(zero-copy)技术。物理显存中的数据布局保持不变,只是改变了解释这些数据的方式——即改变了维度、步幅(stride)等元信息。例如,一个形状为[1024]的一维数组可以被reshape成[32, 32]的二维矩阵,但底层的1024个数字在显存中的位置完全不变。这使得同一块显存可以被多种方式解释:作为字节数组分配时方便内存管理和对齐,作为特定形状的Tensor使用时方便模型计算。vLLM正是利用这一特性,先以int8字节数组的形式分配显存(便于按字节精确控制大小),再根据实际的KV Cache维度需求reshape成对应的多维Tensor,整个过程没有任何数据拷贝,既灵活又高效。
分配好字节数组后,ModelRunner会根据KVCacheSpec对其执行reshape操作。reshape只是改变了存储的解释方式——即如何解释这些字节,而不需要重新分配显存。这是一个非常轻量且高效的操作。
第三步:绑定到模型
完成视图转换后,将Tensor的引用(指针)放到两个位置:
ModelRunner的KV Cache容器里- forward过程的上下文中
这样Attention层在前向计算时就能直接使用这个Tensor View。
从逻辑位置到物理位置:一个完整的例子
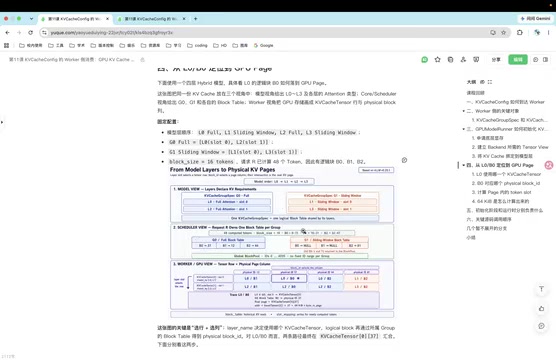
整套机制最精妙之处,在于如何把"模型视角"、"调度视角"和"GPU物理视角"三者串联起来。我们用一个具体例子来说明。
模型视角:分组
假设一个模型有4层:L0、L1、L2、L3。经过分组后:
- Group0:L0、L2,使用Full Attention机制
- Group1:L1、L3,使用Sliding Window Attention机制
在分组内,L0处于Slot0,L2处于Slot1(Group0内);L1、L3同理分布在Group1内。一个KVCacheGroupSpec表达的就是:这些层共享同一个逻辑block table。
调度视角:逻辑资源分配
PagedAttention与Block管理
vLLM的核心创新之一是借鉴操作系统的虚拟内存管理思想,将KV Cache组织成固定大小的block(类似内存页)。每个block通常包含16或32个token的KV数据。这种设计带来了三大优势:第一,可以实现非连续的物理存储,避免显存碎片化;第二,可以在不同序列间共享相同的KV Cache block(如共同的prompt前缀),大幅提升显存利用率;第三,支持动态的block分配和回收,类似OS的页面置换。调度器维护逻辑block到物理block的映射表(block table),就像页表一样。这种设计使得vLLM能在相同显存下支持更大的batch size,从而显著提升吞吐量。
在前缀共享(Prefix Caching)场景下,block粒度管理的价值更加突出。在实际应用中,很多请求共享相同的系统提示(system prompt)或few-shot示例。例如100个请求都以同一段2000 token的系统提示开头,传统方案需要为每个请求独立存储这2000 token的KV Cache,共计20万token的KV数据。而block粒度管理允许这些请求共享同一组物理block——所有请求的block table前N行都指向相同的物理block ID。vLLM通过引用计数追踪每个物理block被多少个逻辑block引用,只有当引用计数降为0时才回收该block。这种机制可以将显存利用率提升数倍,尤其是在长系统提示的对话场景中效果显著。
从调度器的角度看,会为每个Group生成一个Manager,负责逻辑资源分配。假设某一时刻已经计算了48个Token,block size为16,那么就需要3个逻辑block来承载这些Token。
物理视角:两个KVCacheTensor
关键在于分配时创建的两个KVCacheTensor:
- Tensor0:存储所有Slot0对应的层,即Group0的L0和Group1的L1
- Tensor1:存储所有Slot1对应的层,即L2和L3
这正好印证了前文的"反直觉"结论:不同Group但相同Slot的层,被放进了同一个Tensor。
坐标定位:行列映射
Block Table的多级映射机制
Block table实现了从逻辑位置到物理位置的多级映射。第一级是序列级别:每个生成序列有自己的逻辑block列表,表示该序列占用了哪些逻辑block(如[0, 1, 2]表示占用前3个block)。第二级是Group级别:每个attention group维护一个GroupBlockTable,将逻辑block ID映射到物理block ID(如逻辑block 0 → 物理block 37)。第三级是Tensor级别:根据层所在的slot,确定使用哪个KVCacheTensor;再根据物理block ID和token offset,计算出在该Tensor中的精确偏移地址。这种多级映射实现了灵活的资源管理:调度器只需操作逻辑block,Worker负责将其映射到物理显存;不同序列可以共享相同的物理block(前缀共享);物理block可以被动态分配和回收。
每个Tensor是一个很长的张量,定位一个具体的KV Cache需要确定"行"和"列":
确定行(哪个Tensor + 层内位置):根据层名(layer name)判断该层属于哪个Group、哪个Slot。例如L0属于Group0的Slot0,因此它的数据位于Tensor0中。
确定列(物理block位置):通过 逻辑block → GroupBlockTable → physical_block_id 的映射链。假设调度器为逻辑block分配的physical_block_id是37,那么就定位到了Tensor中第37个block的列位置。
精确到Token Slot
找到block后,还需计算block内的具体Token Slot。以第7个Token为例(block size为16):
- 逻辑block index = 7 // 16 = 0
- Token偏移量 = 7 % 16 = 7
最终的物理地址计算为:Tensor0起始地址 + 37 × 16 + 7。即先定位到Tensor0,跳过前面37个block,再偏移7个Token位置,就精确拿到了目标KV Cache的物理存储位置。
这套 模型分组 → 物理资源 → 逻辑位置 → GPU物理位置 的转换链条,以一种相当优雅的方式实现了逻辑与物理的解耦。
初始化阶段 vs 运行阶段
最后需要区分两个阶段各自的职责:
初始化阶段(静态):
- 完成显存分配
- 确定Tensor的视图(reshape)
- 将Tensor绑定到固定的层
- 确定可用的block数量
运行阶段(动态):
- 每个Group的block table内容动态变化(如[37, 12, 44]等映射会不断更新)
- 本轮Token的位置在变化
- 实际使用的KV Cache内容在变化
- block的引用计数与复用(如何高效复用cache)
总结
初始化完成后,模型层绑定了自己的KV Cache视图;运行时,block table将逻辑block index映射为物理block id,再结合slot mapping与token offset,最终确定应该写入的物理slot。
这套设计的精妙之处在于:用无类型字节数组做底层分配、用reshape做零拷贝视图转换、用分组机制统一管理异构注意力层,从而在保证灵活性的同时实现了高效的显存管理。虽然实际的代码实现相当复杂,但抽象出来的主逻辑清晰而优雅,值得每一位关注推理引擎的开发者深入学习。
核心要点
- KV Cache管理是vLLM推理性能的关键,涉及逻辑抽象与物理实现的精妙配合
- 配置从EngineCore经过WorkerWrapperBase按rank分发,最终由ModelRunner执行物理分配
- 采用字节数组+reshape的零拷贝技术,既灵活又高效
- Group机制支持混合注意力架构,相同slot不同group的层共享物理Tensor
- 多级映射(逻辑block→物理block→Tensor偏移)实现了调度与执行的解耦
- 初始化阶段确定静态结构,运行阶段动态更新block映射关系
相关推荐
HuggingFace开始内容审查?下架模型引发社区争议
HuggingFace下架一个标注「用于网络攻击」的去审查GLM模型,引发开源社区关于内容审查的争议。本文梳理事件始末,分析abliterated模型的敏感性,以及平台治理透明度这一真正痛点。
Cayu:构建长周期领域智能体的开源Python框架
Cayu 是一个用于构建领域专用、长周期 AI 智能体的开源 Python 框架。它让开发者围绕工具、知识与业务规则组装 harness,并提供集成的持久化运行时处理会话、状态、恢复、审批与可观测性。本文解析其核心思路与落地场景。
社交媒体真的在伤害青少年吗?一场悬而未决的科学争论
社会心理学家乔纳森·海特在《焦虑的一代》中将青少年心理健康下滑归咎于社交媒体,但这一论断在学术界引发分歧。本文探讨相关性与因果关系的争议,以及这场辩论对公共政策的现实意义。