Ollama Cloud新计费方案实测:变相涨价2.9-6.7倍

Ollama Cloud计费模式从GPU时长转向token计费,实测涨幅高达2.9至6.7倍,存量用户暂可保留旧套餐。
Ollama Cloud于9月1日将计费模式从"按GPU时长"改为"按token用量",社区用户通过实测接口探测发现,这一变更实质上构成了2.9至6.7倍的隐性涨价。旧模式允许重度用户在时长限额内密集调用、极低摊薄成本;新模式则以固定单价精确计费,彻底抹平了重度用户的边际成本优势。GLM-5.2受影响最大(涨幅6.2-6.7倍),DeepSeek v4 Pro相对温和(2.9-3.3倍)。存量订阅用户可通过不取消、不升级套餐来暂时规避涨价,但一旦主动变更即无法自动回退。这一事件揭示了AI云服务定价演变的普遍趋势,也凸显了社区独立实测的重要价值。
事件概览
Ollama Cloud于9月1日实施的配额计费方案调整,正在社区中引发广泛讨论。根据Reddit用户u/Flaky-Maybe-7556的实测研究,这次看似平常的计费模式变更,实际上构成了一次幅度高达2.9至6.7倍的隐性涨价。
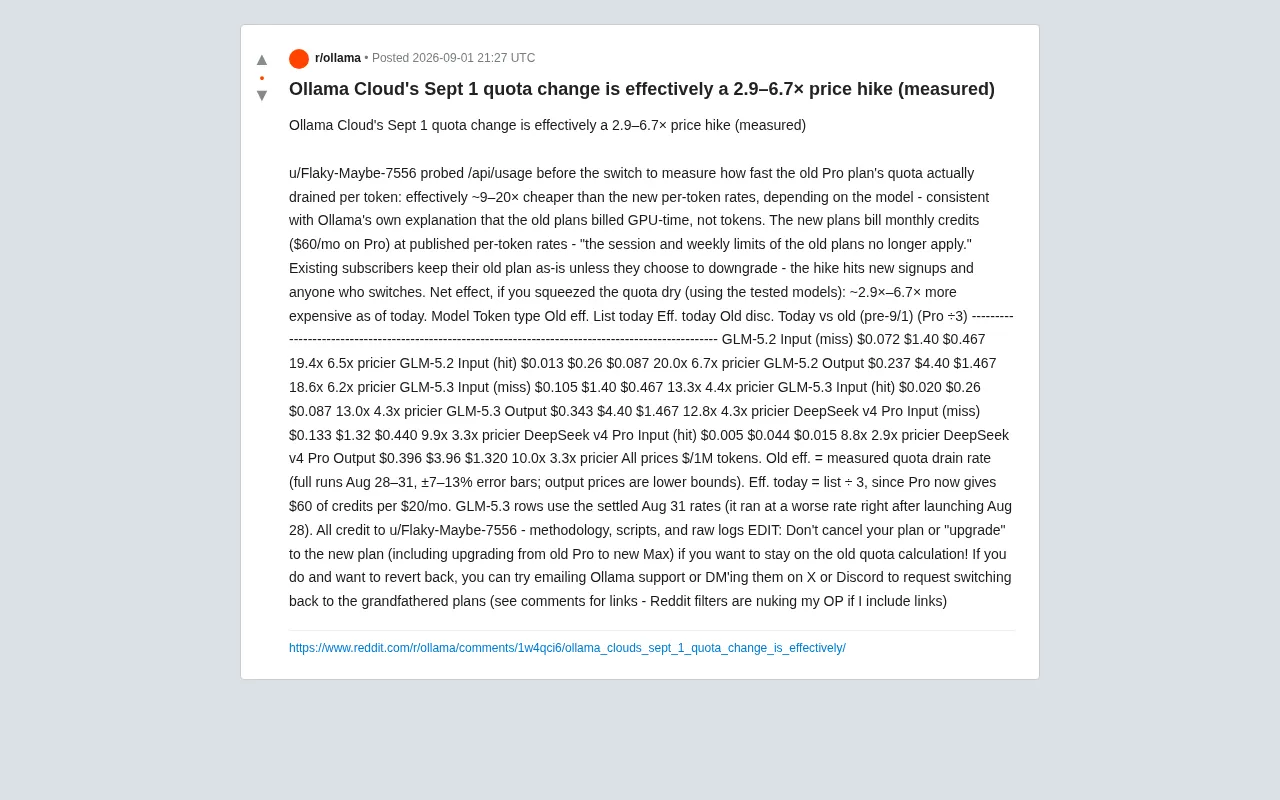
这项研究并非基于官方说法或主观感受,而是通过在计费方案切换前反复调用 /api/usage 接口,实测记录旧版Pro套餐配额在每消耗一个token时的实际扣减速度。测试运行覆盖8月28日至31日,误差范围控制在±7-13%之间,方法论、脚本与原始日志均公开可查。
新旧计费模式的本质区别
理解这次涨价,关键在于弄清两种计费模式的差异。
旧模式:按GPU时长计费
旧版套餐本质上是按GPU运行时长计费,而非按token计费。这一点与Ollama官方的解释一致。在这种模式下,用户在会话和每周限额约束下使用模型,实际的"每token成本"取决于模型的推理速度——推理越快,同样的GPU时长能产出越多token,单token成本也就越低。
实测数据显示,旧模式下的有效单token价格比新版的每token挂牌价便宜约9到20倍,具体倍数因模型而异。
新模式:按月度信用额度与token单价计费
新版套餐改为每月发放固定信用额度(Pro套餐为60美元/月,实际月费20美元,相当于3倍额度),并按公开的每token单价扣费。官方明确表示,"旧套餐的会话与每周限额不再适用"。
表面上看,这是一次计费透明化的改进,但换算成实际单token成本后,涨价幅度便清晰可见。
实测涨价幅度:2.9到6.7倍
研究者对三款主流模型进行了对比测算,以下为关键数据(单位:美元/百万token):
| 模型 | Token类型 | 旧有效价 | 今日有效价 | 涨幅 |
|---|---|---|---|---|
| GLM-5.2 | 输入(未命中) | $0.072 | $0.467 | 6.5倍 |
| GLM-5.2 | 输入(命中) | $0.013 | $0.087 | 6.7倍 |
| GLM-5.2 | 输出 | $0.237 | $1.467 | 6.2倍 |
| GLM-5.3 | 输入(未命中) | $0.105 | $0.467 | 4.4倍 |
| GLM-5.3 | 输出 | $0.343 | $1.467 | 4.3倍 |
| DeepSeek广告 v4 Pro | 输入(未命中) | $0.133 | $0.440 | 3.3倍 |
| DeepSeek v4 Pro | 输入(命中) | $0.005 | $0.015 | 2.9倍 |
| DeepSeek v4 Pro | 输出 | $0.396 | $1.320 | 3.3倍 |
从数据可以看出,涨价幅度与模型密切相关。GLM-5.2受影响最大,用满配额情况下涨幅达6.2-6.7倍;GLM-5.3约为4.3-4.4倍;DeepSeek v4 Pro相对温和,为2.9-3.3倍。
需要说明的是,"今日有效价"是按挂牌价除以3计算得出的,因为Pro套餐现在以20美元月费提供60美元的信用额度。而"旧有效价"则是实测的配额扣减速率,输出价格为下限估计值。
涨价背后的逻辑
为什么按GPU时长计费会显得如此便宜?核心在于满负荷压榨配额的假设。
旧模式的低单价,建立在用户将配额"榨干"的前提下——也就是在GPU时长限额内尽可能高强度、高频率地跑满推理任务。对于重度用户而言,这种模式确实极具性价比。而新模式按token精确计费后,无论使用强度如何,成本都锁定在固定单价上,重度用户此前享受的"边际成本递减"优势被彻底抹平。
换句话说,这次变更并非单纯的价格上调,而是计费逻辑的根本性转变,其结果对不同使用模式的用户影响差异巨大。
存量用户如何应对
值得庆幸的是,这次变更对存量订阅用户设有保护机制。
现有订阅者可保留原套餐不变,涨价仅影响新注册用户以及主动切换套餐的人。这意味着如果你已经是旧版Pro用户并对当前配额满意,最稳妥的做法是保持现状。
研究者在更新说明中特别提醒:
- 不要取消现有套餐
- 不要"升级"到新套餐(包括从旧版Pro升级到新版Max)
一旦执行上述操作,就会切换到新的token计费逻辑,无法自动恢复。如果误操作后希望回退,可以尝试通过邮件联系Ollama支持团队,或在X、Discord上私信官方,请求切换回受保护的旧套餐(grandfathered plan)。
结语
这起事件是AI基础设施服务定价演变的一个典型案例。计费模式从"按资源时长"转向"按token用量",本质上是服务商将成本核算精细化、并向可预测的订阅收入模型靠拢的过程。对用户而言,这提醒我们在评估云端AI服务成本时,不能只看挂牌单价,更要结合自身实际使用模式进行测算。
这项研究最值得称道之处,在于其扎实的实测方法论——通过接口探测、多轮完整运行和公开原始日志,将一个容易被官方话术模糊的"计费透明化"变更,还原为可量化、可复现的涨价事实。在AI服务日益复杂的定价环境中,这类由社区驱动的独立测评,正变得越来越有价值。
相关推荐

Reddit帖子被删引发AI内容审核争议
Reddit一则帖子被平台以违反内容政策为由删除,页面仅显示移除提示。事件折射出AI内容审核系统在透明度、误判风险和申诉机制方面的普遍困境,值得内容平台与创作者关注。

DSH+Ollama本地部署大模型实战:免费对话大肥鱼
B站UP主实测DSH+Ollama本地部署大模型全流程:从Ollama安装、迅雷加速下载、魔搭GGUF模型导入,到DSH自定义API地址配置,并对比千问3.5 4B、8B、Gemma等模型在8G显存下的表现,给出本地部署与API调用的选择建议。

899元Mac Mini实测:能替代200美元AI订阅吗?
实测M4 Mac mini能否替代200美元AI订阅:16GB内存装不下大模型,速度与质量均有差距,但隐私、无上限和近零运行成本让它成为常驻智能体的理想宿主。附各配置选购建议与省钱策略。