视觉Transformer如何理解抽象概念?转喻电路机制揭秘
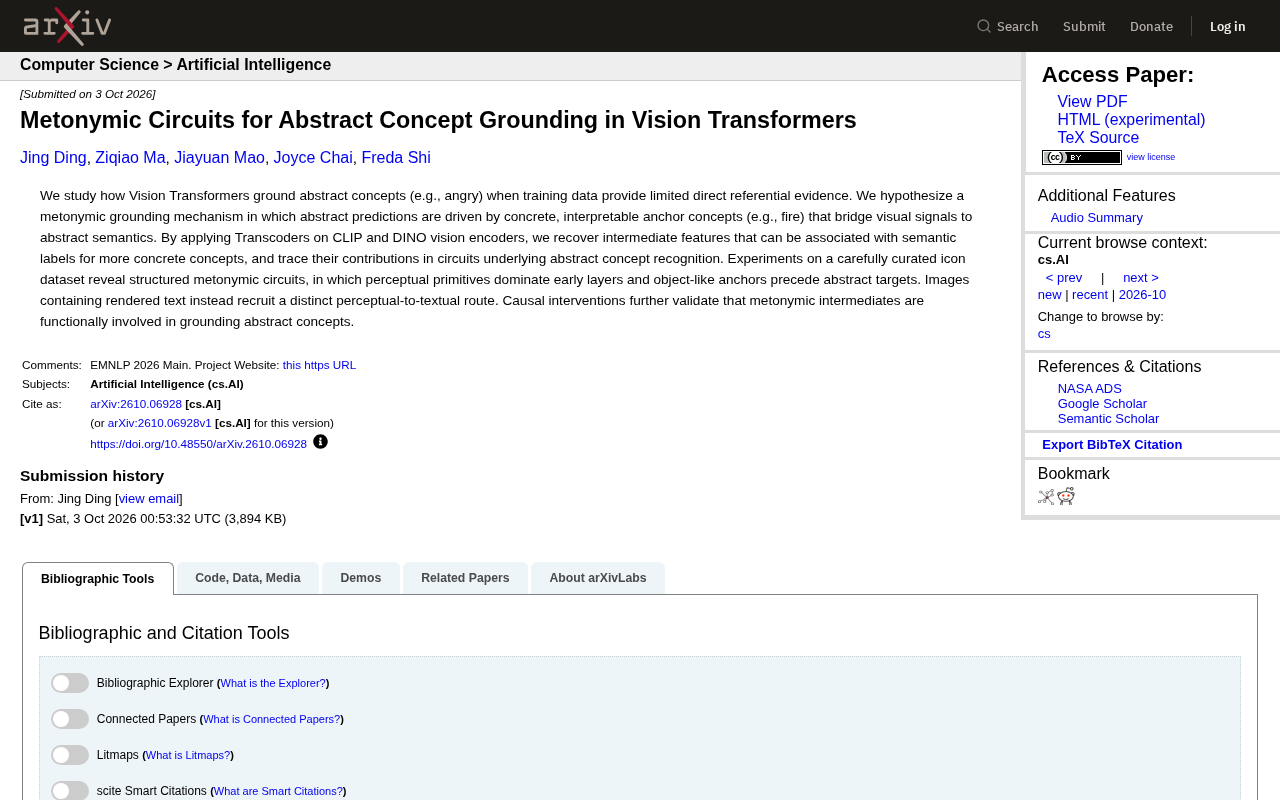
视觉Transformer借助"火焰→愤怒"式转喻锚点理解抽象概念,研究以因果干预证实了这一内部电路机制。
一篇arXiv论文揭示了视觉Transformer理解抽象概念(如"愤怒")的内部机制:模型并非直接映射像素到抽象语义,而是借助转喻接地策略——先激活"火焰"等具体可见的锚点概念,再由锚点跳转至抽象目标。研究团队在CLIP和DINO两种主流编码器上应用Transcoder技术,追踪中间特征的语义贡献,发现模型内部存在清晰的分层转喻电路:早期层处理颜色/形状等感知基元,中间层激活物体级锚点,最终层才抵达抽象概念;而图像中的文字内容则触发独立的处理路径。因果干预实验进一步证实,这些转喻中间体对最终预测具有实际功能性作用,而非偶发关联。该研究为机制可解释性领域提供了可复用的分析范式,也揭示了视觉模型与人类认知隐喻机制的深层相似性。
抽象概念的识别难题
视觉Transformer(Vision Transformer)在图像识别领域表现出色,但一个长期存在的问题是:模型如何理解像"愤怒"(angry)这类抽象概念?与"猫""汽车"等具体物体不同,抽象概念在训练数据中往往缺乏直接的视觉指代证据。一张图片里并没有"愤怒"这个实体,模型究竟依靠什么来完成这类判断?
一篇新发布的arXiv论文《Metonymic Circuits for Abstract Concept Grounding in Vision Transformers》给出了一个颇具启发性的答案:模型可能借助了一种转喻(metonymy)接地机制,通过具体且可解释的"锚点概念"来搭建从视觉信号到抽象语义的桥梁。
什么是转喻接地机制
论文的核心假设是:当模型需要预测某个抽象概念时,它的判断实际上是由一系列具体、可解释的中间概念驱动的。举例来说,识别"愤怒"可能依赖于"火焰"(fire)这样的具象元素——火焰在视觉上是可感知的,同时在语义上又与"愤怒"存在隐喻关联。
这种机制在语言学中被称为"转喻",即用一个相关的具体事物来指代抽象含义。研究者将这一概念迁移到视觉模型内部,试图验证模型是否也在无意识地使用类似策略:先锁定具体的视觉锚点,再由锚点通向抽象目标。
为什么这个视角重要
传统的可解释性研究大多聚焦于模型如何识别具体物体,而抽象概念的内部表征一直是黑箱中的黑箱。转喻接地的框架提供了一条可操作的路径,让研究者能够追踪抽象判断背后的"推理链条",而不是把它当作不可拆解的整体。
CLIP(Contrastive Language-Image Pre-Training)和 DINO 是当前最广泛使用的两种视觉编码器,代表了截然不同的训练范式。CLIP由OpenAI提出,通过将图像与自然语言描述进行对比学习,使图像嵌入空间天然对齐文本语义,因此在跨模态检索和零样本识别任务中表现突出;其内部特征被认为富含高层语义信息,但也因此更难追溯具体视觉信号的贡献。DINO(及其后续版本DINOv2)则采用自监督蒸馏方式训练,无需文本配对,却能学习到具有强空间定位能力的视觉特征,注意力图往往能清晰勾勒出物体轮廓。在同一框架下同时研究这两种编码器,有助于判断转喻电路是视觉模型的通用机制,还是仅在特定训练目标下才会涌现的现象。
用Transcoder拆解模型内部电路
为了验证假设,研究团队在CLIP和DINO两种主流视觉编码器上应用了Transcoder技术。Transcoder能够恢复模型的中间特征,并将这些特征与更具体的概念语义标签关联起来,从而在抽象概念识别的"电路"中追踪各个成分的贡献。
研究者还专门构建了一个精心策划的图标(icon)数据集进行实验。实验结果揭示出清晰的结构化转喻电路:
- 早期层由感知基元主导:模型浅层主要处理颜色、形状、纹理等低级视觉特征。
- 物体级锚点先于抽象目标出现:在抵达抽象概念之前,模型会先激活类似物体的具体锚点概念。
- 文本走独立路径:当图像中包含渲染文字时,模型会调用一条截然不同的"感知到文本"路由,而非走转喻锚点通道。
这种分层结构表明,抽象概念的识别并非一蹴而就,而是沿着从具体到抽象的梯度逐步构建。
Transcoder 是机制可解释性领域的一种特征分解工具,其设计灵感来源于稀疏自编码器(Sparse Autoencoder,SAE)。传统SAE通过在残差流上训练稀疏重建来提取可解释特征,而Transcoder则专门针对MLP层:它训练一个"输入→稀疏隐层→输出"的小型网络来替代原始MLP,同时保持模型行为基本不变。这样一来,原本难以解读的稠密MLP激活就被分解为若干稀疏的、有语义标签的中间特征,研究者可以直接读取"哪些概念节点在此刻被激活"。相比于纯粹的激活补丁(activation patching)或探针(probe)方法,Transcoder能够恢复更细粒度的计算图,让"电路"追踪从定性描述变为量化的贡献归因。在本研究中,正是借助Transcoder,研究者才得以在CLIP和DINO的各层之间逐一定位哪些中间特征充当了转喻锚点。
因果干预验证机制有效性
仅仅观察到相关性还不足以下结论。研究团队进一步采用了因果干预(causal intervention)方法,直接操纵这些转喻中间特征,观察模型最终输出的变化。
结果显示,这些转喻中间体在抽象概念接地过程中具有实际的功能性作用——改变锚点概念的激活会相应影响抽象概念的预测。这从因果层面证实了转喻电路不只是"巧合出现的关联",而是模型实际依赖的计算路径。
因果干预在机制可解释性研究中通常以"激活补丁"(activation patching)或"反事实替换"的形式实现:研究者直接修改模型前向传播过程中某一特定位置的激活值,然后观察最终输出的变化幅度。若某中间特征被抑制后抽象概念的预测概率显著下降,则可推断该特征在计算路径中承担了不可或缺的角色。这一方法的关键优势在于能够区分"相关性"与"因果性"——模型可能同时激活许多与目标概念相关的特征,但只有通过干预才能确定哪些是真正的功能节点,哪些只是"搭便车"的副产物。在抽象概念理解这一场景中,因果干预的意义尤为突出:它使研究者能够以实验方式回答"如果模型没有看到'火焰'这个锚点,它还能识别'愤怒'吗"这类反事实问题。
对AI可解释性研究的意义
这项工作的价值在于,它把抽象且难以捉摸的语义接地问题,转化为了可追踪、可验证的内部电路分析。几点启示值得关注:
其一,视觉模型在缺乏直接监督信号的情况下,会自发利用具体概念作为"跳板"来理解抽象语义,这与人类的认知隐喻机制有相似之处。
其二,文本内容触发独立处理路径的发现,提示多模态模型内部存在功能分化,这对理解CLIP等跨模态模型的工作原理有参考价值。
其三,Transcoder结合因果干预的方法论,为机制可解释性(mechanistic interpretability)研究提供了可复用的分析范式。
随着视觉与多模态大模型能力不断提升,理解它们"为什么这样判断"变得越来越重要。转喻电路的研究让我们得以窥见模型如何将像素信号一步步升华为抽象语义,这对构建更透明、更可控的AI系统具有长远意义。
相关推荐
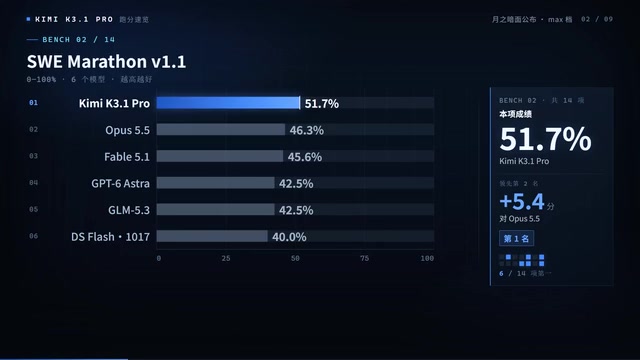
Kimi K3.1 Pro跑分曝光:14项测试6项第一,编程直追Opus
Kimi K3.1 Pro跑分公布:14项测试6项第一,场任务编程51.7超Opus,终端实战65.7仅差0.7分,幻觉率从23.4%降至8.3%,高速版支持百万上下文并计划开放权重。

谷歌Agent Compute Engine:每个Agent一个microVM
谷歌Agent Compute Engine为每个AI Agent分配独立microVM且不存凭证,本文解析其隔离设计与凭证管理思路,梳理已公开与未公开细节,并给出构建者可立即借鉴的三条实践。

付费AI写作研究谁最强?Reddit用户激辩ChatGPT与Gemini
Reddit用户热议付费AI聊天机器人写作研究能力:资深写作者发现免费Gemini输出胜过付费ChatGPT,社区讨论聚焦写作质量、研究场景偏好及提示词工作流,揭示免费与付费边界模糊下的工具选择策略。