视频扩散模型打造可控3D虚拟人:VDAs突破单图生成瓶颈
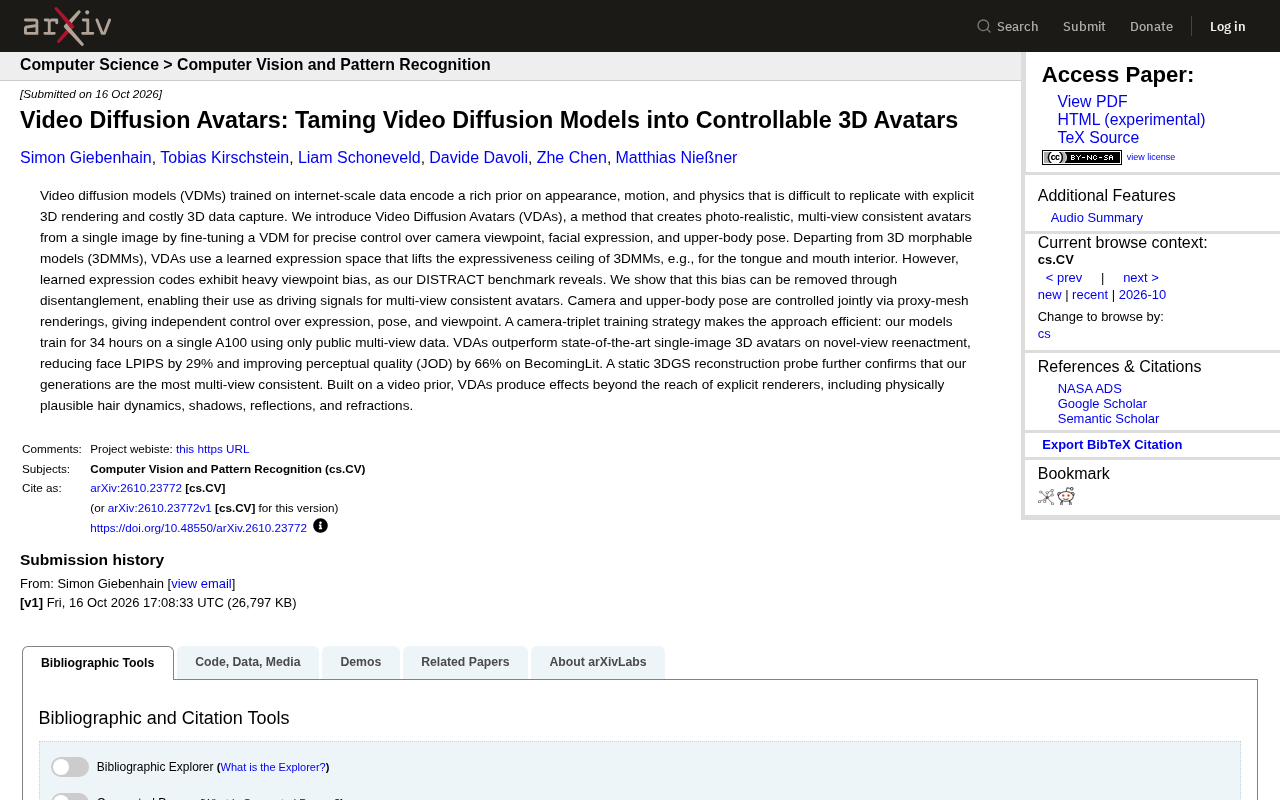
VDAs 用视频扩散先验与解耦表情编码,从单图生成多视角一致的3D虚拟人。
论文提出 Video Diffusion Avatars(VDAs),利用互联网规模视频扩散模型习得的 appearance、运动与物理先验,从单张图像生成逼真、多视角一致且可控的虚拟人。方法用学习式表情空间替代表达能力受限的3DMM,并指出学习式表情编码存在视角偏差,通过解耦消除后可作为多视角一致的驱动信号,同时构建 DISTRACT 基准量化该现象。相机视角与身体姿态由代理网格渲染控制,与表情通道彼此独立。相机三元组训练策略使模型在单张A100上34小时、仅用公开多视角数据完成训练。新视角重演任务中面部LPIPS降低29%、JOD提升66%,还能产生头发动态、阴影与反射折射等显式渲染器难以实现的效果。
视频扩散模型(VDM)在互联网规模数据上训练后,已经习得了对 appearance、运动乃至物理规律的丰富先验——这是传统显式3D渲染和昂贵3D数据采集难以复制的优势。一篇新论文提出的 Video Diffusion Avatars(VDAs),正是利用这一先验,从单张图像生成逼真、多视角一致的可控虚拟人。
从3DMM到学习式表情空间
传统虚拟人方法多依赖3D形变模型(3DMM)驱动表情,但3DMM的表达能力存在天花板,尤其在舌头和口腔内部等区域。VDAs 选择了一条不同的路:用一个学习得到的表情空间替代3DMM,从而突破表达上限。
不过,论文指出的一个关键问题是:学习式表情编码存在严重的视角偏差。作者为此构建了 DISTRACT 基准来量化这一现象,并证明通过**解耦(disentanglement)**可以消除该偏差,使这些编码能够作为多视角一致虚拟人的驱动信号。
3DMM(3D Morphable Model,三维形变模型) 是1999年由Blanz与Vetter提出的经典人脸参数化表示,其核心思想是通过对大量3D人脸扫描做PCA降维,得到一组低维基向量,用少量系数即可描述人脸形状与纹理的变化。3DMM的优点是线性、可解释、驱动稳定,至今仍是Face2Face、DECA、EMOCA等虚拟人系统的底层骨架。
局限也很明确:作为线性模型,它只能表示训练集中出现过的形变模式;舌头、牙龈、口腔内部等区域在多数扫描数据中不可见或未被标注,因此3DMM在这些区域几乎无法产生合理形变。这正是论文主张用非线性学习式表情空间替代3DMM的直接动因。
视角偏差(view bias) 指的是:当表情编码器从单目视频中学习时,编码结果会无意中吸收相机视角、光照和头部朝向的信息,而不只是纯粹的表情。表现在下游任务上,就是同一个表情在不同拍摄角度下被编码成不同向量,驱动出的虚拟人在跨视角时会发生抖动或形变。
这与表征学习中的“捷径学习”类似——网络倾向于利用数据中与标签相关但非因果的因素。论文的解决思路是解耦:让编码通道只承载表情语义,把视角相关的信息交给显式的相机参数(代理网格渲染)通道。DISTRACT 基准的作用就是把这个此前被忽视的问题变成可量化、可比较的指标。
相机、姿态与表情的独立控制
VDAs 将相机视角和上半身姿态的控制统一交给代理网格渲染(proxy-mesh renderings),而表情则走学习式编码通道。三者彼此独立,用户可以分别调整表情、身体姿态和观察视角,而不会相互干扰。
训练效率方面,论文采用相机三元组(camera-triplet)训练策略,在单张 A100 上仅用 34 小时、且只依赖公开多视角数据就完成了训练。这个成本对于视频扩散模型微调来说相当克制。
代理网格渲染(proxy-mesh renderings) 指用一个粗糙的参数化人体/头部网格(如 SMPL-X 或 FLAME)按目标相机与姿态位姿渲染出的深度图、法线图或分割掩码,作为扩散模型的空间条件输入。它不追求照片级真实,只提供几何骨架:哪个像素属于头部、朝哪个方向、深度多少。
这样做的好处是把“控制”与“生成”分离——控制信号来自显式几何、精确且可解释,生成细节则交给视频先验补全。相比直接用相机外参做 embedding,渲染出的网格图与图像空间对齐,扩散模型的U-Net更容易利用;同时,网格渲染天然支持任意视角外推,为多视角一致性提供了几何锚点。
性能表现:LPIPS 降低29%,JOD提升66%
在新视角重演(novel-view reenactment)任务上,VDAs 相比当前最强的单图3D虚拟人方法有明显优势:在 BecomingLit 数据集上,面部 LPIPS 降低 29%,感知质量指标 JOD 提升 66%。
作者还做了一个静态3DGS重建探针实验,进一步确认 VDAs 的生成结果在多视角一致性上表现最佳。这一点很关键——单图生成多视角时,视角间的几何一致性往往是最难保证的环节。
LPIPS(Learned Perceptual Image Patch Similarity) 用AlexNet/VGG等预训练网络提取特征,比较两张图在深层特征空间的距离,数值越低表示感知上越接近,比PSNR/SSIM更贴合人眼判断。JOD(Jensen-Shannon Distance 相关的感知分布度量) 则衡量生成结果与真值在特征分布层面的整体差异,对模糊、伪影等失真更敏感,论文中数值越高代表感知质量越好(具体方向以原文定义为准)。
两者互补:LPIPS偏重逐图像素级的感知相似,JOD更关注整体分布质量。同时报告这两个指标,可以避免单一指标被“平均化”掩盖掉局部严重失真,例如口腔区域的结构崩坏。
超越显式渲染器的物理效果
由于建立在视频先验之上,VDAs 能产生显式渲染器难以企及的效果:物理上合理的头发动态、阴影、反射与折射。这些细节并非通过物理仿真硬编码,而是模型从视频数据中习得的隐式知识。
这也揭示了这类方法的核心价值:视频扩散模型不只是生成工具,更是一个可被微调为精确控制器的世界先验载体。当相机、姿态、表情被解耦为独立控制维度后,这个先验就能被“驯服”成实用的3D虚拟人系统。
论文的方法细节与基准设计,为后续研究提供了一个清晰的参照:如何在不依赖3DMM的前提下,既保住表达能力,又解决视角偏差,同时把训练成本控制在可复现的范围内。
相关推荐
GitHub日报·10月24日:Agent开箱即用与桌面小鸭子

开源多Agent模拟经营项目实战评测
基于B站UP主开源的多Agent沙盘经营项目实测,拆解其规划、记忆、多Agent通信、HITL与评估机制,对比大模型自主决策与固定规则引擎在不同场景下的收益差异,为Agent开发者提供选型与工程实践参考。
AI工程化实战:Claude Code与Agent Skill开发全流程
B站实战课解析AI工程化:用Claude Code、Codex、WorkBuddy开发企业级Agent Skill,涵盖公众号报文、量化分析、小红书自动发布等案例,讲透Skill驱动开发的范式转移与工具选型。