时序预测别再硬塞大模型!NeurIPS实测:删掉反而更强

NeurIPS研究证实时序预测删掉LLM反而更好,应按数据类型分三条路线选型。
文章围绕一篇NeurIPS Spotlight论文展开,指出在时序预测中删除LLM或将其替换为单层注意力后,参数量从60多亿降至50多万、训练时间从3000分钟压缩到2分钟,精度却不下降。当前榜单前列的Kronos-2、TimeSafe M2.5等均为专用时序基础模型。文章强调LLM的真正价值在于阅读文本语义,与数值基础模型加权融合可超过最强单一模型。作者据此给出按数据类型划分的三条路线:纯数值先建最简基线,有文本做含错位打乱在内的四组对照实验,无文本则用专用时序基础模型作基线,并倡导用消融实验证明增益来源。
时序预测领域正在经历一次视角的纠偏。过去两年,把大语言模型(LLM)塞进时序预测管线几乎成了一种默认操作,但一篇NeurIPS Spotlight论文用13个数据集、26组对比实验给出了相反的结论:删掉LLM,效果反而更好。据B站相关解读视频介绍,TimeLM、OneFaceOut、Cuff这类"大模型+时序"的代表工作,在移除LLM或将其替换为一层普通注意力后,参数量从60多亿骤降到50多万,训练时间从3000分钟压缩到2分钟,而精度并没有因此下降。
这一结果并非孤例。当前各大时序榜单上排名靠前的模型——Kronos-2、TimeSafe M2.5等——全部是时序基础模型,而不是把LLM硬塞进预测流程的方案。视频中有一句话点破了这类工作的软肋:如果审稿人问一句"把LM拿掉效果掉不掉",答不上来,整篇文章就站不住。
LLM在时序中的真实定位:读文字,不是算数字
那么LLM在时序预测里彻底没用了?并非如此,问题在于用错了地方。大模型的强项从来不是拟合数值曲线,而是理解文本语义。据视频中引用的Google Time团队参与的一项研究,研究者用真实数据搭配真实文字重新做了评测,发现此前那些用合成文本堆出来的"大模型碾压"结论被严重高估。
真正稳健的做法反而很朴素:时序基础模型负责数值预测,大模型负责阅读相关文本,两路各出一版结果,最后做加权平均。这一组合在实验中超过了最强的单一时序基础模型。这个思路的关键在于分工明确——让擅长数字的模型处理数字,让擅长语言的模型处理语言,而不是强迫一个模型同时做两件事。
时序基础模型(Time Series Foundation Model) 指专门在大规模时序语料上预训练的模型,典型代表包括 TimesFM、Kronos、TimeSafe 等。与 LLM 按 token 处理离散文本不同,它们通常采用 patch 化输入,把连续数值序列切成片段再编码,输出直接是未来若干步的数值预测。这类模型的优势在于预训练阶段见过海量真实序列,因而具备零样本或少样本预测能力;同时也避免了对数值做文本序列化所带来的信息损失。理解这一区别是判断"该用 LLM 还是专用时序模型"的前提:前者擅长语义,后者擅长数值模式。
三条路线:按你手里的数据选打法
视频作者给出了一个非常实用的决策框架:具体用哪条路线,取决于你手头有什么类型的数据。
路线一:纯数值数据——先建最简基线
如果你手上只有电力负荷、分电功率、交通流量这类纯数字序列,不要急着上大模型。先把论文中的最简模型当作基线:归一化、切片、一层注意力,就这三样。作者将其称为PiTen,在小数据集上表现优于大多数编码方式。资料中提供的Raven和Patch嵌入两个模块可以直接拼装成你自己的改进版本。
改进的评判标准很明确:只要稳定赢过这个最简基线,再把LLM换进来做一组对比,把精度和训练时间并排展示,审稿人最想问的那个问题你就提前回答了。
消融实验(Ablation Study) 是机器学习论文中验证各组件贡献的标准手段:逐一移除或替换模型中的某个模块,观察性能变化,以此判断该模块是否真正起作用。文中"删掉 LLM 看效果掉不掉"正是消融思想的直接应用。一个设计良好的消融应当保证其他条件不变,只改变被测组件;若移除后指标几乎不变,说明该组件冗余,增益可能来自其他部分或数据泄漏。对"LLM+时序"类工作而言,缺少这一对照组往往意味着无法排除"普通注意力也能达到同等效果"的替代解释。
路线二:有文本记录——做四组对照实验
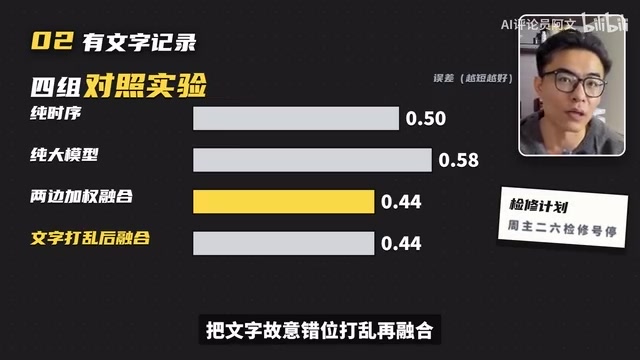
如果你手头有设备巡检日志、检修计划、排程记录、政策新闻或天气预报文本,这些就是你的差异化筹码。具体做法是:TimesFM 2.5开源且无需训练,直接产出一版数值预测;文本部分交给大模型阅读,产出一版语义调整;然后做四组对照实验——纯时序、纯大模型、两路加权融合,以及最关键的一组:把文本故意错位打乱后再融合。
如果文字打乱后精度立刻暴跌,就证明是外部文本信息在发挥实际作用,而不是模型碰巧拟合了噪声。这个设计同时具备工程意义和实验严谨性,足以支撑一个完整的顶会框架。
文本错位打乱对照(Shuffled Text Control) 是一种针对多模态融合的严谨性检验:保持文本的数量、长度和分布不变,仅随机打乱文本与时间片段的对应关系,再走同样的融合流程。若此时精度明显下降,说明模型确实在利用文本与数值之间的语义对齐关系;若精度几乎不受影响,则说明增益可能来自额外的参数容量或正则效应,而非文本信息本身。这一设计成本极低,却能有效回应审稿人对"增益来源是否真实"的质疑,是多模态时序研究中值得默认加入的对照组。
路线三:没有文本但需要大模型亮点——用专用时序基础模型
如果你的场景既没有文本,又需要在论文中体现"大模型"元素,不要自己往LLM里塞数据。直接使用为时序专门训练的基础模型,比如Kronos-2,无需训练即可输出预测。把它作为基线,你的方法只要能赢过它,比赢过十个传统老模型更有说服力——因为它代表了当前时序基础模型的水平线。
对研究者的启示
这套框架的价值不在于否定LLM,而在于重新划定了它的职责边界。过去"LLM+时序"的很多工作,本质上是让语言模型去拟合它并不擅长的数值模式,参数量和训练成本极高,但增益来源说不清楚。NeurIPS这篇Spotlight论文的实验设计——删除组件、观察效果是否下降——正是检验这类工作是否成立的标准动作。
对正在做时序预测研究的同学来说,务实的路径是:先用最简基线确认问题本身的可解性,再根据数据类型决定是否引入文本模态,最后用消融实验证明增益来源。盲目堆叠大模型参数的时代,至少在时序预测这个方向上,正在过去。
相关推荐
 科技前沿
Memorias:用AI传记作家把你的故事变成书
Memorias 是一款 AI 传记作家工具,通过对话式访谈将你的口述故事整理成回忆录,自动映射人物、地点与年份,支持照片与 EPUB/PDF/DOCX 导出,按次付费。
 科技前沿
mamitsu:让社交视频自动转成JSON的API与MCP
mamitsu是一款在Product Hunt上发布的API和MCP服务器,能将社交视频中的画面、音频和配文解析为JSON结构化数据,适用于食谱提取、产品信息抓取等开发者场景。
 科技前沿
GitHub日报·11月08日:Agent 基础设施全面开花
Deep dive into 7 new GitHub trending projects today