首届vLLM大会回顾:开源推理引擎生态全面崛起
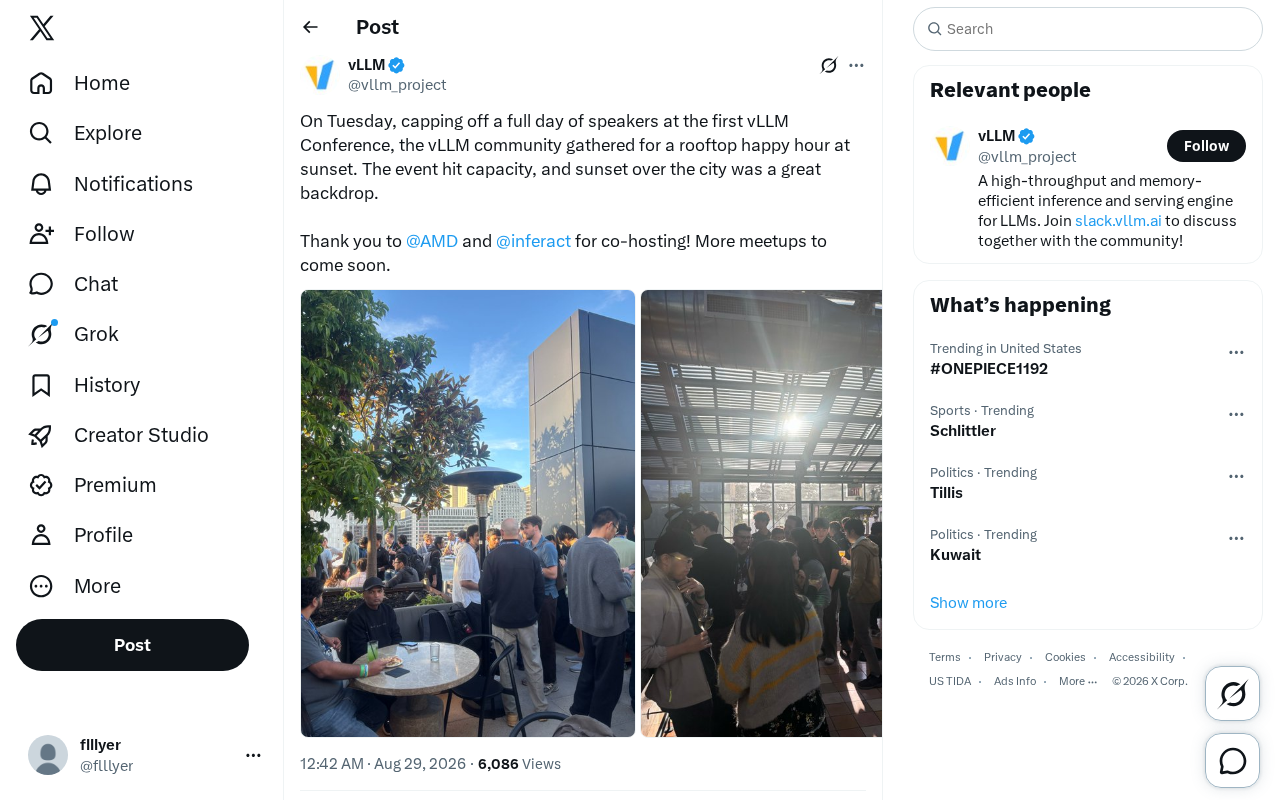
首届vLLM大会落幕,开源推理引擎凭借PagedAttention技术与产业联盟完成从工具到社区平台的跃迁。
首届vLLM大会由AMD与Inferact协办,标志着这一起源于UC伯克利的开源推理引擎正式迈入产业化核心地带。vLLM的核心竞争力在于PagedAttention技术——借鉴操作系统虚拟内存分页思想对KV Cache进行非连续内存管理,显著提升GPU显存利用率与并发吞吐量。在模型兼容性上,vLLM支持Llama、Qwen、Mistral等主流架构,并对齐OpenAI API规范,极大降低迁移成本。AMD的协办折射出社区推动硬件多元化、打破CUDA单一垄断的战略意图,而爆满的屋顶聚会则印证了vLLM已完成从"工具"到"社区运动"的跃迁,一个涵盖底层芯片、推理中间件与上层服务的完整产业链条正在成型。
首届vLLM大会:开源推理引擎的里程碑时刻
近日,首届vLLM大会(vLLM Conference)圆满落幕。作为大模型推理领域最受关注的开源项目之一,vLLM首次以独立大会的形式,将社区中的开发者、研究者与产业实践者聚集在了一起。会议在一整天密集的技术分享之后,以一场日落时分的屋顶欢乐时光(rooftop happy hour)收尾,现场人气爆满,成为开源社区凝聚力的生动写照。
据主办方透露,本次活动由 AMD 与 Inferact 共同协办。这一合作阵容本身就颇有深意——芯片厂商与推理服务提供商的加入,标志着 vLLM 已经从一个纯粹的学术开源项目,逐步迈入了产业化的核心地带。
vLLM 为何值得关注
高性能推理的开源标杆
vLLM 最初由加州大学伯克利分校的研究团队提出,其核心创新在于 PagedAttention 技术。这一机制借鉴了操作系统中虚拟内存分页的思想,将 KV Cache(键值缓存)以分页方式进行管理,从而极大提升了显存利用率,有效减少了内存碎片问题。
在实际部署场景中,这意味着同样的 GPU 硬件可以承载更高的并发吞吐量。对于需要大规模部署大语言模型的企业而言,推理成本往往是最沉重的开支之一,而 vLLM 恰恰在这一关键痛点上给出了切实可行的降本增效方案。
广泛的模型生态兼容性
vLLM 的另一大优势在于对主流模型架构的广泛支持。无论是 Llama 系列、Qwen、Mistral 还是各类多模态模型,vLLM 都能提供开箱即用的高效推理能力。同时,它兼容 OpenAI 的 API 接口规范,开发者只需极低的迁移成本,就能将现有应用切换到自托管的开源推理方案上。
AMD 与 Inferact 协办背后的产业信号
本次大会由 AMD 联合协办,这一点尤其值得关注。长期以来,大模型推理的硬件生态由 NVIDIA 的 CUDA 体系主导,而 AMD 的深度参与,折射出 vLLM 社区在推动硬件多元化方面的持续努力。
随着 vLLM 对 AMD ROCm 平台支持的不断完善,开发者在选择推理硬件时将拥有更多可选项。这不仅有助于打破单一厂商的生态锁定,也能在 GPU 供应紧张、价格居高不下的背景下,为企业提供更灵活的算力部署策略。
Inferact 作为推理服务方向的参与者,其加入则代表了应用层对高效推理引擎的强烈需求。从底层芯片到中间件,再到上层服务,一个围绕 vLLM 的完整产业链条正在逐渐成型。
从代码项目到社区运动
一场爆满的屋顶聚会,表面看只是活动花絮,实则折射出开源社区运作的深层逻辑。优秀的开源项目从来不只是代码的堆砌,更依赖活跃、健康的社区生态来驱动长期发展。
vLLM 能够成功举办首届独立大会,并吸引硬件巨头与产业伙伴共同背书,说明它已经完成了从「工具」到「平台」再到「社区运动」的跃迁。主办方表示「更多的线下聚会即将到来」(More meetups to come soon),预示着 vLLM 社区将持续通过线下互动来强化协作与共识。
对开发者的几点启示
对于关注大模型部署的开发者而言,vLLM 的崛起带来了几个值得思考的方向:
- 推理优化正成为核心竞争力:在模型能力日趋趋同的当下,谁能以更低成本提供更快的推理服务,谁就掌握了商业化落地的主动权。
- 开源推理方案日趋成熟:自托管推理不再是妥协之选,vLLM 等项目在性能表现上已足以对标甚至超越部分闭源方案。
- 硬件生态正在多元化:不必将算力策略押注在单一厂商身上,跨平台的推理引擎正在有效降低这一风险。
写在最后
首届 vLLM 大会的成功举办,是开源推理引擎走向成熟的一个重要节点。从 PagedAttention 等底层技术创新,到 AMD、Inferact 等产业力量的协作,再到社区自发的凝聚与壮大,vLLM 展现出了一个健康开源项目应有的完整生态面貌。
随着更多线下活动的展开,以及硬件厂商的持续投入,vLLM 有望在大模型推理这一关键赛道上,继续扮演开源标杆的角色。对于整个 AI 基础设施领域来说,这样的社区繁荣无疑是一个令人振奋的信号。
相关推荐

本地AI部署神器LocModel:一键玩转开源模型与AI生成
LocModel是一款本地AI部署工具,可自动适配硬件、一键下载开源模型,支持图片生成、视频生成、无审查大模型和Agent智能体,完全免费。本文基于实测视频介绍其安装与使用流程。

Antigravity CLI:终端免费调用Gemini与Claude顶级模型
Antigravity CLI(agy)宣称可在VS Code终端免费调用Gemini 3.1 Flash、Claude Sonnet等顶级模型,几秒完成安装。本文拆解其使用流程、终端内调用模型的价值,以及免费宣称背后需要核实的安全与可持续性问题。

聊天机器人与AI智能体:核心区别与选型指南
聊天机器人与AI智能体到底有什么区别?本文从工具、记忆、工作流三个维度拆解两者差异,用整理收件箱、安排会议等四个真实场景对比,并给出权限控制、不可逆操作确认等风险防范建议与选型判断标准。